Context Lens
Base de conocimiento de búsqueda semántica para asistentes de IA compatibles con MCP
Documentación
Context Lens
Dale a tu IA la capacidad de entender el significado, no solo de coincidir con palabras clave.


¿Qué es Context Lens?
Context Lens transforma cualquier contenido en una base de conocimiento buscable para tu asistente de IA. Este servidor de Model Context Protocol (MCP) autónomo, con almacenamiento vectorial serverless integrado (LanceDB), aporta búsqueda semántica a tus conversaciones. Apúntalo a cualquier contenido (código, documentación, contratos o archivos de texto) y tu IA podrá entender y responder preguntas sobre el contenido al instante.
La búsqueda tradicional por palabras clave encuentra archivos que contienen términos específicos. ¿No usas el término exacto? Te pierdes el contenido.
Context Lens entiende el significado. Pregunta por "autenticación" y encuentra código sobre inicio de sesión, credenciales, tokens, OAuth y control de acceso, incluso si esos archivos nunca usan la palabra "autenticación".
Véalo en acción
¿Quieres entender cómo funciona Context-Lens? Aquí viene lo divertido: puedes usar Context-Lens para aprender sobre Context-Lens.
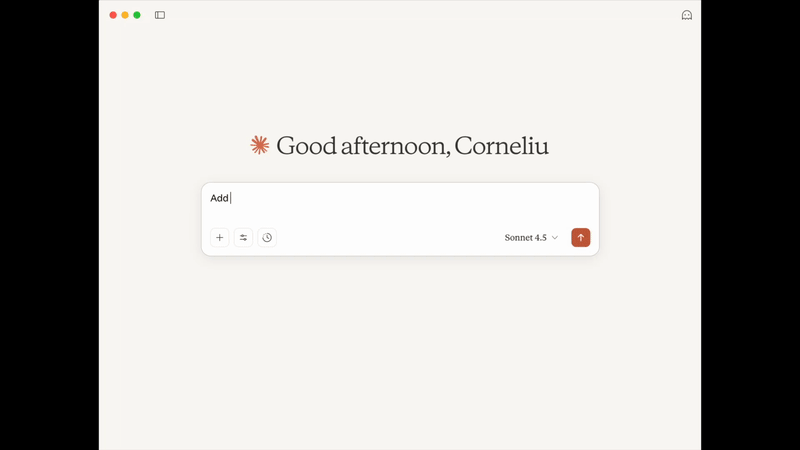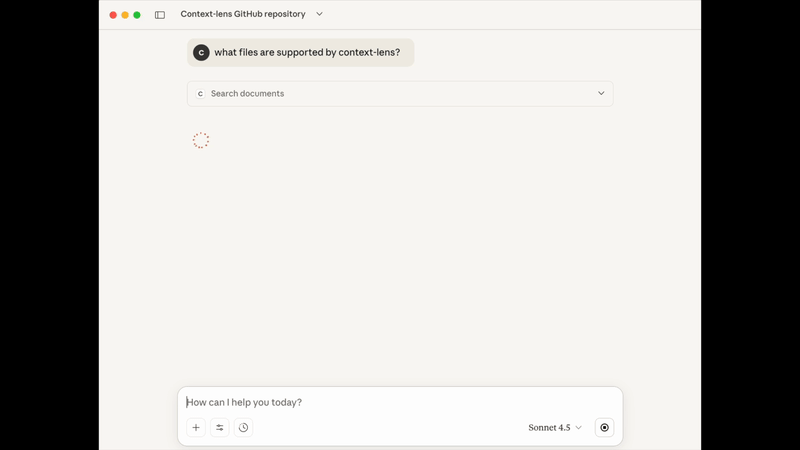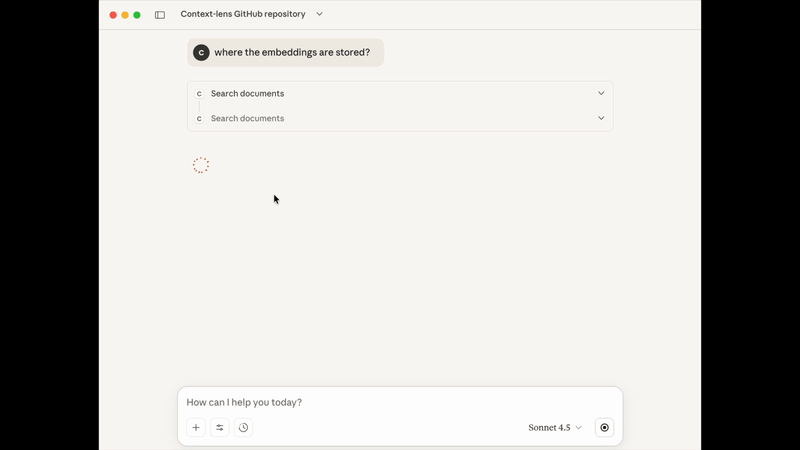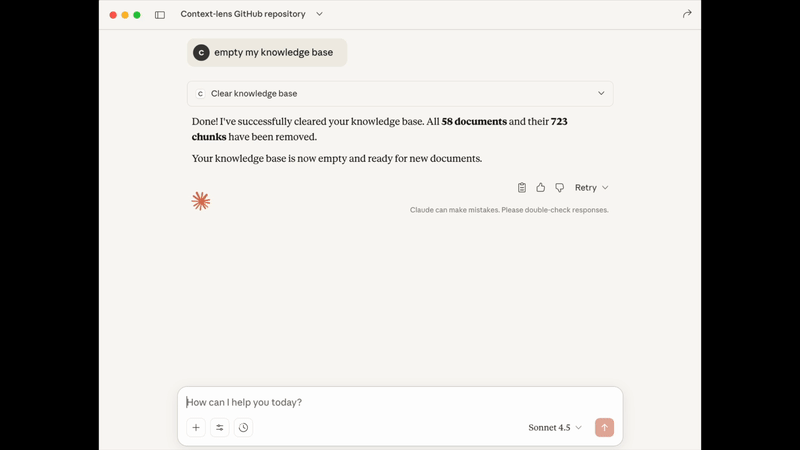
Demo: Uso de Claude Desktop con Context-Lens para indexar y consultar este mismo repositorio. Sin git clone, sin desplazarse por el código, solo preguntas y respuestas.
¿Por qué LanceDB?
Context Lens usa LanceDB, una base de datos vectorial moderna y serverless:
- 🆓 Totalmente gratis y local - Sin servicios en la nube, claves API ni suscripciones
- ⚡ Cero infraestructura - Base de datos integrada, solo un archivo en el disco
- 🚀 Rápido y eficiente - Construido sobre Apache Arrow, optimizado para búsqueda vectorial
- 💾 Almacenamiento simple - Base de datos de un solo archivo, fácil de respaldar o mover
Piénsalo como "SQLite para embeddings de IA": todo el poder de la búsqueda vectorial sin la complejidad.
Características
- 🔍 Búsqueda semántica - Entiende el significado, no solo palabras clave
- 🚀 Cero configuración - Sin instalación, sin configuración, sin claves API
- 💾 Almacenamiento serverless - LanceDB integrado, sin base de datos externa
- 🔒 100% local y privado - Todos los datos permanecen en tu máquina
- 📁 Local y GitHub - Indexa archivos locales o repositorios públicos de GitHub
- 🎯 Análisis inteligente - Fragmentación consciente del lenguaje para mejores resultados
Arquitectura
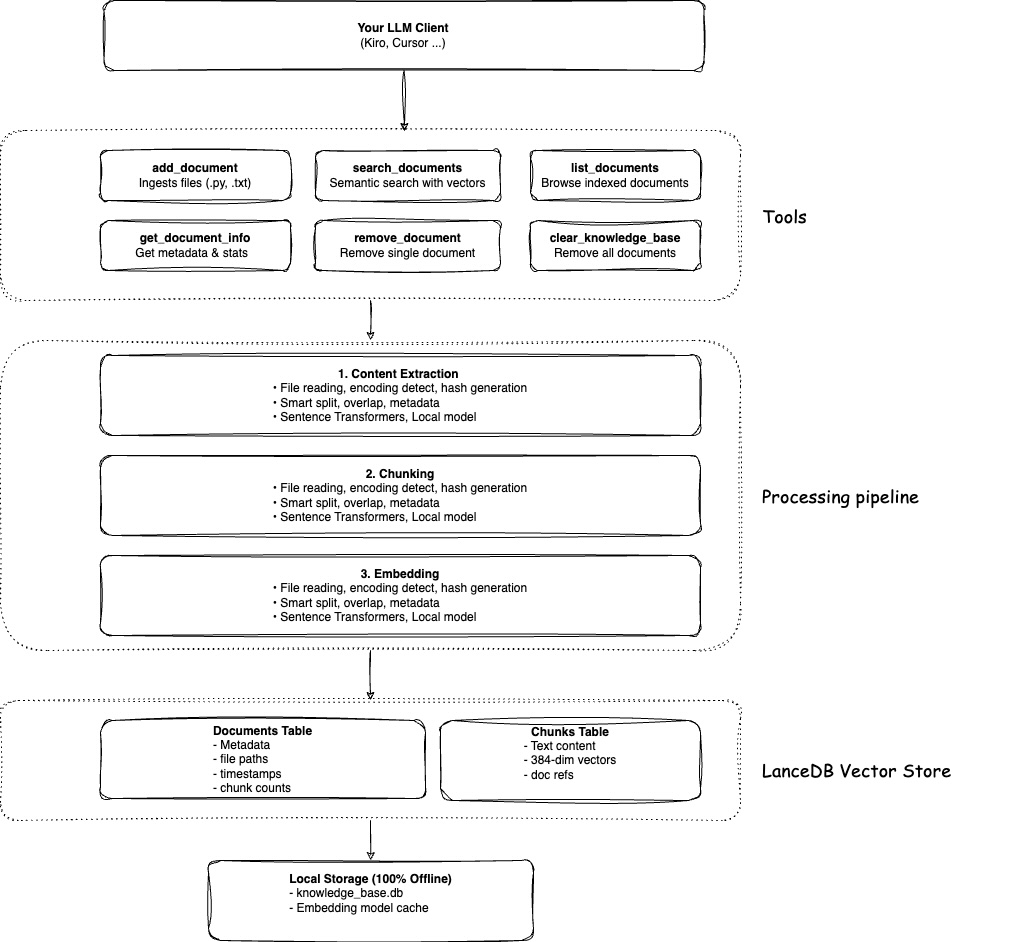
Cómo funciona
Cuando añades contenido a Context Lens, no solo vierte texto en una base de datos. Esto es lo que realmente ocurre:
Lectura inteligente: Context Lens detecta el tipo de archivo y usa analizadores especializados. Los archivos Python se analizan con análisis AST, el JSON se analiza estructuralmente y el Markdown se divide por encabezados. Esto preserva la estructura natural de tu contenido.
Fragmentos significativos: En lugar de límites arbitrarios de caracteres, el contenido se fragmenta de forma inteligente: funciones completas, párrafos lógicos, secciones enteras. Tu código nunca se divide a mitad de una función.
Vectores semánticos: Cada fragmento se convierte en un vector de 384 dimensiones mediante un modelo de embeddings local. Estos vectores capturan el significado, no solo las palabras. "autenticación" y "sistema de inicio de sesión" se convierten en vectores similares aunque no compartan palabras.
Almacenamiento local: Todo va a LanceDB, una base de datos vectorial serverless que es solo un archivo en tu disco. Sin servicios en la nube, sin llamadas API, completamente privado.
Búsqueda conceptual: Cuando haces una pregunta, también se convierte en un vector. Context Lens encuentra fragmentos con vectores similares (significado similar) y los clasifica por relevancia. Obtienes respuestas basadas en conceptos, no en coincidencias de palabras clave.
Especificaciones técnicas
| Componente | Detalles |
|---|---|
| Modelo de embeddings | sentence-transformers/all-MiniLM-L6-v2 |
| Dimensiones del vector | 384 dimensiones |
| Tamaño del modelo | ~90MB (se descarga en el primer uso) |
| Tamaño del fragmento | 1000 caracteres (predeterminado, configurable) |
| Superposición de fragmentos | 200 caracteres (predeterminado, configurable) |
| Base de datos vectorial | LanceDB (serverless, basada en archivos) |
| Formato de almacenamiento | Formato columnar Apache Arrow |
| Método de búsqueda | Similitud de coseno |
| Procesamiento | 100% local, sin llamadas API externas |
📖 ¿Quieres personalizarlo? Consulta SETUP.md para opciones de configuración y TECHNICAL.md para benchmarks de rendimiento.
Configuración rápida
Kiro IDE
Añade a .kiro/settings/mcp.json:
{
  "mcpServers": {
    "context-lens": {
      "command": "uvx",
      "args": ["context-lens"],
      "autoApprove": ["list_documents", "search_documents"]
    }
  }
}
Recargar: Paleta de comandos → "MCP: Recargar servidores"
Cursor
Añade a .cursor/mcp.json:
{
  "mcpServers": {
    "context-lens": {
      "command": "uvx",
      "args": ["context-lens"]
    }
  }
}
Otros clientes MCP
Para Claude Desktop, Continue.dev o cualquier cliente compatible con MCP:
{
  "mcpServers": {
    "context-lens": {
      "command": "uvx",
      "args": ["context-lens"]
    }
  }
}
📖 ¿Necesitas instrucciones de configuración detalladas? Consulta SETUP.md para todos los clientes, uso programático y opciones de configuración.
Registro MCP
Context Lens está publicado en el Registro oficial de Model Context Protocol como io.github.cornelcroi/context-lens.
📖 Detalles del registro y verificación: Consulta REGISTRY.md para la verificación de instalación e información del registro.
Uso programático
Usa Context Lens directamente en tus aplicaciones Python:
#!/usr/bin/env python3
import os
from dotenv import load_dotenv
from mcp import StdioServerParameters, stdio_client
from strands import Agent
from strands.models.openai import OpenAIModel
from strands.tools.mcp import MCPClient

def main():
    # Load environment variables from .env file
    load_dotenv()

    # Create MCP client for context-lens server
    mcp_client = MCPClient(
        lambda: stdio_client(
            StdioServerParameters(command="uvx", args=["context-lens"])
        )
    )

    # Create an agent with OpenAI model and MCP tools
    model = OpenAIModel(model_id="gpt-4o-mini")
    agent = Agent(model=model, tools=[mcp_client])

    print("Chatbot started! Type 'quit' to exit.")

    while True:
        user_input = input("\nYou: ").strip()

        if user_input.lower() in ['quit', 'exit', 'bye']:
            print("Goodbye!")
            break

        if not user_input:
            continue

        try:
            response = agent(user_input)
            print(f"Bot: {response}")
        except Exception as e:
            print(f"Error: {e}")

if __name__ == "__main__":
    main()
Ejemplo de conversación:
You: Add https://github.com/fastapi/fastapi to the knowledge base
Bot: ✓ Added 247 files from repository with 1,543 chunks

You: How does FastAPI handle dependency injection?
Bot: FastAPI uses a sophisticated dependency injection system...
📖 Ejemplos completos: Consulta SETUP.md para el código completo y más frameworks.
Inicio rápido
Añade tu proyecto
You: Add all Python files from ./src to the knowledge base
LLM: ✓ Added 23 Python files with 156 chunks

You: How does the authentication system work?
LLM: The authentication system uses JWT tokens. The login flow starts in
     auth/login.py where credentials are validated, then a token is generated
     with the user's ID and expiration time...

You: Show me all the database models
LLM: Based on the codebase, here are the main database models:
     1. User model (models/user.py) - handles user accounts and authentication
     2. Post model (models/post.py) - manages blog posts with relationships...
Aprende de código abierto
You: Add https://github.com/fastapi/fastapi to the knowledge base
LLM: ✓ Added 247 files from repository with 1,543 chunks

You: How does FastAPI handle dependency injection?
LLM: FastAPI uses a sophisticated dependency injection system. The Depends()
     function in fastapi/dependencies.py analyzes function signatures and
     automatically resolves dependencies. Here's how it works...

You: Compare FastAPI's routing to Flask
LLM: FastAPI uses decorator-based routing similar to Flask, but with key
     differences: 1) Type hints for automatic validation, 2) Async support
     built-in, 3) Automatic OpenAPI documentation generation...
Analiza documentos
You: Add all contracts from ./legal/contracts
LLM: ✓ Added 12 contract documents with 487 chunks

You: Find all termination clauses
LLM: I found termination clauses in 8 contracts. Here's a summary:
     - Service Agreement: 30-day notice required for either party
     - Vendor Contract: Immediate termination for breach of confidentiality...

You: What are the payment terms across all contracts?
LLM: Payment terms vary by contract type:
     - Service contracts: Net 30 days from invoice date
     - Vendor agreements: 50% upfront, 50% on delivery...
Obtén archivos de URLs
You: Add https://raw.githubusercontent.com/fastapi/fastapi/master/README.md
LLM: ✓ Document 'README.md' added successfully with 42 chunks

You: What is FastAPI and what are its key features?
LLM: FastAPI is a modern, fast web framework for building APIs with Python 3.7+.
     Key features include:
     - Fast performance (on par with NodeJS and Go)
     - Automatic API documentation
     - Type hints for validation
     - Async support built-in...
📖 Más ejemplos y patrones de consulta: USAGE_GUIDE.md
Análisis y fragmentación inteligente
Context Lens no solo divide texto a ciegas: entiende la estructura del código y crea fragmentos inteligentes que respetan los límites del lenguaje.
La diferencia: La fragmentación genérica divide el código arbitrariamente por número de caracteres, a menudo rompiendo funciones a mitad. El análisis inteligente entiende la estructura de tu código y crea fragmentos completos y significativos.
Tipos de archivo compatibles
- 🐍 Python (
.py,.pyw) - Funciones, clases, imports - ⚡ JavaScript/TypeScript (
.js,.jsx,.ts,.tsx,.mjs,.cjs) - Funciones, clases, imports - 📦 JSON (
.json,.jsonc) - Claves de nivel superior, objetos anidados - 📋 YAML (
.yaml,.yml) - Claves de nivel superior, listas, mapeos - 📝 Markdown (
.md,.markdown,.mdx) - Jerarquía de encabezados, bloques de código - 🦀 Rust (
.rs) - Structs, traits, bloques impl, funciones - 📄 Otros archivos (
.txt,.log,.cpp,.java, etc.) - División inteligente en párrafos/oraciones
Beneficios
✅ Unidades de código completas - Nunca divide funciones o clases a mitad
✅ Contexto preservado - Docstrings, comentarios y estructura permanecen intactos
✅ Mejor búsqueda - Encuentra fragmentos de código completos y comprensibles
✅ Automático - Sin configuración necesaria, funciona según la extensión del archivo
📖 ¿Quieres ver cómo funciona? Consulta PARSING_EXAMPLES.md para ejemplos detallados.
Qué puedes añadir
Context Lens funciona con archivos basados en texto de múltiples fuentes:
- 📁 Archivos y carpetas locales - Tus proyectos, documentación, cualquier archivo de texto
- 🌐 Repositorios de GitHub - Repos públicos, ramas específicas, directorios o archivos
- 🔗 URLs de archivos directas - Cualquier archivo accesible por HTTP/HTTPS
- 📄 Documentos - Contratos, políticas, artículos de investigación, documentación técnica
Tipos de archivo compatibles: .py, .js, .ts, .java, .cpp, .go, .rs, .rb, .php, .json, .yaml, .md, .txt, .sh, y más (más de 25 extensiones)
Tamaño máximo de archivo: 10 MB (configurable mediante la variable de entorno MAX_FILE_SIZE_MB)
Ejemplos:
./src/- Directorio local/path/to/file.py- Archivo local individualhttps://github.com/fastapi/fastapi- Repositorio completohttps://github.com/django/django/tree/main/django/contrib/auth- Directorio específicohttps://example.com/config.yaml- URL de archivo directa/path/to/contracts/- Documentos legales
📖 Consulta más ejemplos: USAGE_GUIDE.md
Herramientas disponibles
- 📥 add_document - Añade archivos, carpetas o URLs de GitHub
- 🔍 search_documents - Búsqueda semántica en todo el contenido
- 📋 list_documents - Explora documentos indexados
- ℹ️ get_document_info - Obtén metadatos sobre un documento
- 🗑️ remove_document - Elimina documentos específicos
- 🧹 clear_knowledge_base - Elimina todos los documentos
📖 Consulta ejemplos detallados: USAGE_GUIDE.md
Preguntas frecuentes
¿Cómo se compara con el servidor MCP de GitHub?
Sirven para propósitos diferentes y se complementan:
Context Lens es mejor para:
- 🧠 Comprensión semántica - "Encuentra código de autenticación" devuelve inicio de sesión, credenciales, tokens, OAuth, incluso sin palabras clave exactas
- 📚 Aprender bases de código - Pregunta "¿Cómo funciona X?" y obtén resultados conceptualmente relevantes en todo el proyecto
- 🔍 Descubrimiento de patrones - Encuentra patrones de código similares, enfoques de manejo de errores o decisiones arquitectónicas
- 💾 Desarrollo sin conexión - Una vez indexado, funciona sin conexión a internet
- 🔒 Privacidad - Todo el procesamiento ocurre localmente, sin datos enviados a servicios externos
El servidor MCP de GitHub es mejor para:
- 🔧 Gestión de repositorios - Crear issues, gestionar PRs, manejar operaciones de CI/CD
- 📊 Estado en tiempo real - Siempre obtiene la última versión de GitHub
- 🌐 Funciones específicas de GitHub - Se integra con el ecosistema de GitHub (Actions, Projects, etc.)
Diferencia clave: Context Lens clona una vez e indexa todo para búsqueda semántica rápida (sin conexión). GitHub MCP hace llamadas API por consulta para acceso en tiempo real (en línea). Usa Context Lens para entender código, GitHub MCP para gestionar repositorios.
¿Por qué la primera ejecución es lenta?
El modelo de embeddings (~100MB) se descarga en el primer uso. Esto solo ocurre una vez.
¿Necesito una clave API?
¡No! Context Lens se ejecuta completamente local. Sin claves API, sin servicios en la nube.
¿Dónde se almacenan mis datos?
Context-Lens almacena datos en directorios específicos de la plataforma:
- macOS:
~/Library/Application Support/context-lens/ - Linux:
~/.local/share/context-lens/ - Windows:
%LOCALAPPDATA%\context-lens\
Puedes cambiar el directorio base configurando la variable de entorno CONTEXT_LENS_HOME:
{
  "mcpServers": {
    "context-lens": {
      "command": "uvx",
      "args": ["context-lens"],
      "env": {
        "CONTEXT_LENS_HOME": "/path/to/your/data"
      }
    }
  }
}
O sobrescribir rutas individuales con LANCE_DB_PATH (base de datos) y EMBEDDING_CACHE_DIR (modelos).
¿Puedo usar esto con código privado?
¡Sí! Todo el procesamiento ocurre localmente. Nada se envía a servicios externos.
¿Cuánto espacio en disco usa?
~100MB para el modelo + ~1KB por fragmento de texto. Una base de código de 10MB usa ~5-10MB de espacio en la base de datos.
📖 ¿Más preguntas? TROUBLESHOOTING.md
Documentación
- 📖 Guía de configuración - Configuración detallada para todos los clientes, opciones de configuración
- 📚 Guía de uso - Ejemplos, consultas y mejores prácticas
- 🎨 Ejemplos de análisis - Cómo funciona el análisis inteligente
- 🔧 Solución de problemas - Problemas comunes y soluciones
- ⚙️ Detalles técnicos - Arquitectura, stack y rendimiento
- 📋 Información del registro - Verificación e instalación del Registro MCP
- 🤝 Contribuciones - Cómo contribuir, hoja de ruta
- 📦 Guía de publicación - Proceso de publicación en el Registro MCP (para mantenedores)
Contribuciones
¡Las contribuciones son bienvenidas! Por favor:
- Abre un issue primero para discutir tu idea
- Obtén aprobación antes de comenzar a trabajar
- Envía un PR haciendo referencia al issue
Consulta CONTRIBUTING.md para más detalles.
Licencia
Licencia MIT - consulta LICENSE para más detalles.
¡Dale una estrella al repositorio si te resulta útil! ⭐