Cluefinch MCP
Infraestructura de investigación profunda para agentes de IA. Busca en la web, lee páginas de forma incremental, sigue enlaces de fuentes y recopila evidencia relevante de múltiples fuentes.
Documentación
Cluefinch MCP
Infraestructura de Deep Research para agentes de IA.
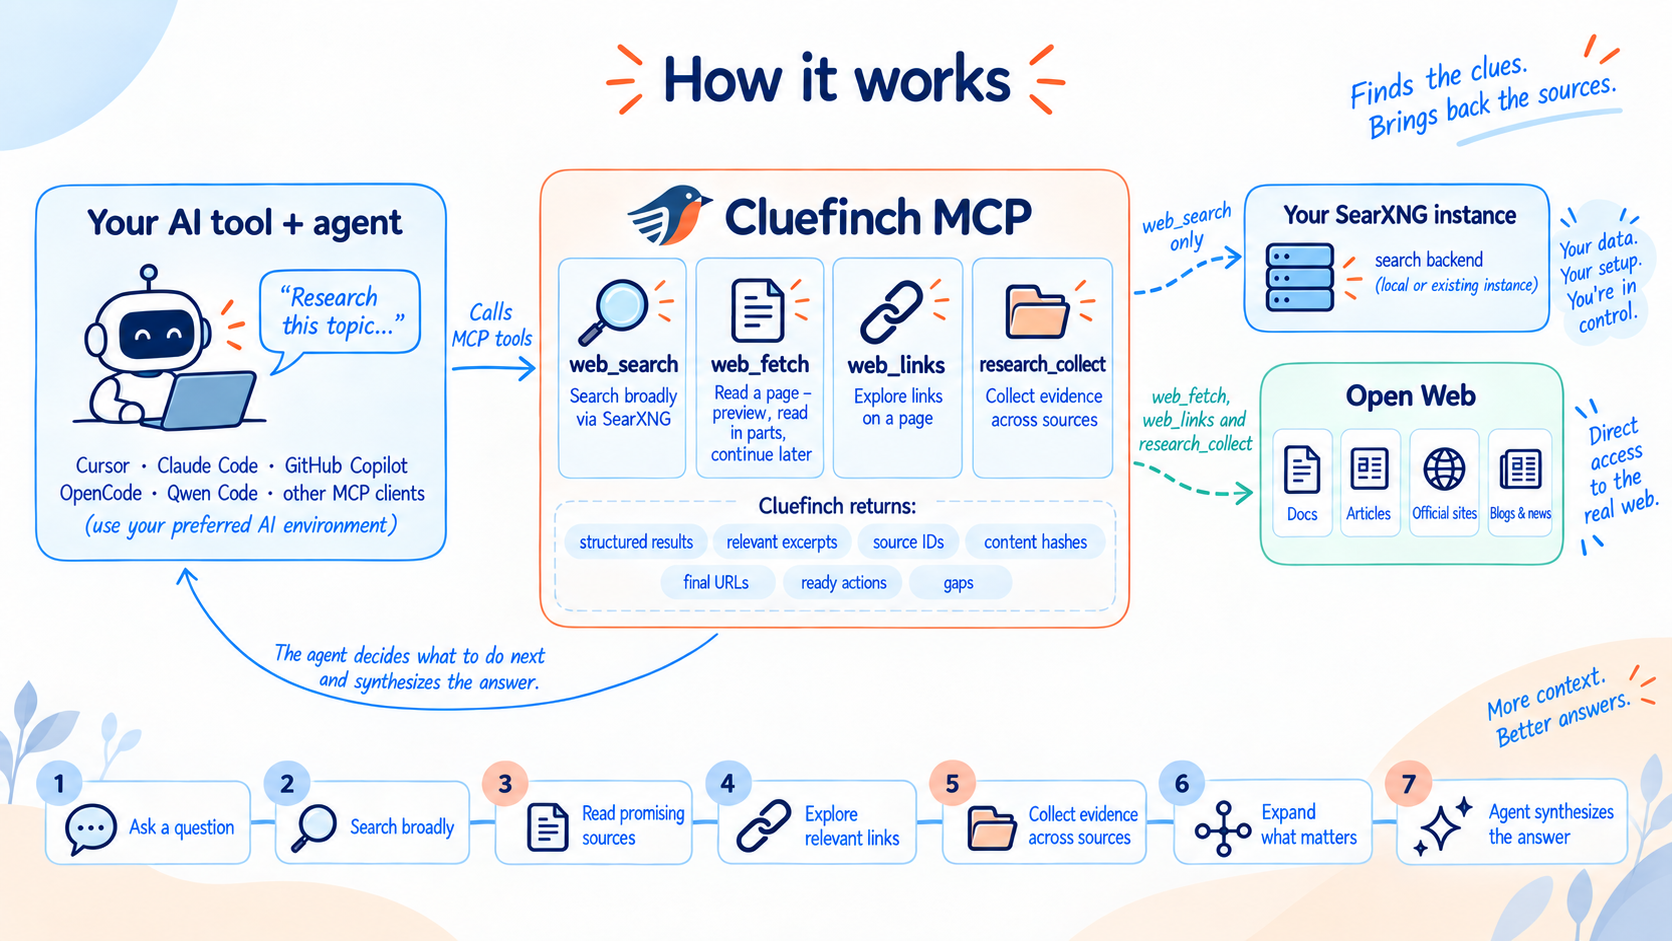
Cluefinch MCP brinda a los agentes de IA un conjunto completo de herramientas para trabajar con la web a través del Protocolo de Contexto de Modelo (MCP).
Con Cluefinch, un agente puede buscar en la web, leer páginas, navegar entre fuentes relacionadas y llevar a cabo investigaciones en profundidad.
Cluefinch MCP puede hacer que internet sea parte del espacio de trabajo de tu agente de IA, desde encontrar un dato puntual hasta realizar investigaciones complejas de múltiples pasos en varias fuentes.
Cluefinch MCP es completamente gratuito y no requiere suscripción de pago. Funciona con agentes de IA, ya sea que estén impulsados por LLM locales o modelos basados en la nube, y no requiere una API de búsqueda comercial ni una suscripción a un servicio de Deep Research alojado en la nube.
Cluefinch MCP no impone sus propios límites en la cantidad de consultas de búsqueda o ejecuciones de investigación.
Tu agente obtiene las herramientas que necesita para trabajar eficazmente con la web, mientras tú conservas el control sobre cómo se utilizan esas herramientas. Cluefinch se integra fácilmente con herramientas de IA compatibles con MCP y se adapta al flujo de trabajo que ya utilizas.
Lo que Cluefinch MCP puede hacer
Búsqueda web
Cluefinch MCP permite que un agente busque en internet a través de tu propia instancia de SearXNG.
El agente puede formular y refinar consultas de búsqueda, usar diferentes motores de búsqueda, restringir las búsquedas por idioma o dominio, y emitir consultas de seguimiento o revisadas cuando sea necesario.
Lectura web
Una vez que se encuentra un enlace útil, el agente puede abrir la página a través de Cluefinch MCP y recibir texto limpio listo para el procesamiento del modelo.
Las páginas grandes no tienen que cargarse en el contexto del modelo de una sola vez. El agente puede leerlas en fragmentos, continuar desde una posición específica y solicitar contexto adicional solo cuando realmente se necesite.
Navegación de fuentes
Después de encontrar una página útil, el agente puede inspeccionar sus enlaces HTTP/HTTPS y usar la estructura propia de la fuente para continuar la investigación: moverse por secciones de documentación y capítulos de informes, seguir la paginación, abrir páginas relacionadas y llegar a materiales primarios, sin volver a un motor de búsqueda en cada paso.
Deep Research
Cluefinch MCP le da al agente las herramientas para llevar a cabo flujos de trabajo de investigación de múltiples fuentes.
El agente puede seguir varias líneas de investigación a la vez, trabajar tanto con resultados de búsqueda como con URL conocidas, recopilar material de diferentes fuentes, examinar las partes más relevantes de documentos largos y profundizar la investigación a medida que surgen nuevas preguntas.
El agente mantiene el control del proceso de investigación: decide qué buscar a continuación, qué fuentes merecen una inspección más cercana, cómo interpretar el material recopilado y cuándo hay suficiente evidencia para producir una respuesta.
La profundidad de la investigación, desde una consulta rápida de producto hasta un análisis complejo de múltiples etapas, depende de la tarea, el modelo y las instrucciones del usuario.
Inicio rápido
Cluefinch MCP requiere Python 3.12.4 o posterior.
1. Instalar Cluefinch MCP
python -m pip install cluefinch
Después de la instalación, asegúrate de que el ejecutable cluefinch esté disponible a través de la variable de entorno PATH.
En Windows:
where.exe cluefinch
En macOS y Linux:
command -v cluefinch
Si no se encuentra cluefinch, agrega el directorio que contiene el ejecutable instalado a PATH.
2. Iniciar SearXNG
Cluefinch usa SearXNG como su backend de búsqueda. Si aún no tienes tu propia instancia de SearXNG, el repositorio incluye un ejemplo de configuración local listo para usar:
examples/searxng/compose.yamlexamples/searxng/settings.yml
Para ejecutar el ejemplo, necesitas Docker con soporte de Docker Compose.
Descarga estos archivos en un directorio separado y crea un archivo .env junto a ellos con un SEARXNG_SECRET aleatorio.
En macOS y Linux:
printf 'SEARXNG_SECRET=%s\n' "$(openssl rand -hex 32)" > .env
En Windows PowerShell:
$secret = -join ((1..64) | ForEach-Object { '{0:x}' -f (Get-Random -Maximum 16) })
"SEARXNG_SECRET=$secret" | Set-Content -Encoding ascii .env
Luego inicia SearXNG con Docker Compose:
docker compose up -d
De forma predeterminada, la instancia local de SearXNG estará disponible en:
http://127.0.0.1:8081
3. Conectar Cluefinch MCP a tu herramienta de IA
Cluefinch se conecta fácilmente a herramientas de IA populares y se ejecuta como un servidor MCP local estándar a través de stdio.
En la siguiente sección se proporcionan ejemplos de conexión listos para usar.
Integración con herramientas de IA
Cluefinch MCP utiliza el transporte MCP local estándar stdio, por lo que en la mayoría de los clientes solo necesitas especificar el comando cluefinch.
A continuación se muestran ejemplos mínimos de integración de Cluefinch con algunas herramientas de IA populares. Cluefinch también se puede usar con otros clientes que admitan servidores MCP locales a través de stdio.
Los ejemplos a continuación usan SearXNG en http://127.0.0.1:8081, como se muestra en la sección de Inicio rápido anterior.
Si tu instancia de SearXNG no usa la dirección predeterminada, pasa MCP_SEARCH_SEARXNG_URL a través del entorno del servidor MCP en la configuración de tu cliente.
Cursor
Agrega Cluefinch al .cursor/mcp.json de tu proyecto o a la configuración global de MCP de Cursor:
{
  "mcpServers": {
    "cluefinch": {
      "type": "stdio",
      "command": "cluefinch"
    }
  }
}
Después de reiniciar la conexión MCP, Cursor descubrirá las herramientas de Cluefinch y podrá usarlas en tareas de agente.
Claude Code
Cluefinch se puede agregar con un solo comando:
claude mcp add --scope user cluefinch -- cluefinch
Para verificar la conexión:
claude mcp list
Codex
Agrega Cluefinch con:
codex mcp add cluefinch -- cluefinch
Para verificar la conexión:
codex mcp list
GitHub Copilot en VS Code
Agrega el servidor MCP local a .vscode/mcp.json:
{
  "servers": {
    "cluefinch": {
      "type": "stdio",
      "command": "cluefinch"
    }
  }
}
Cluefinch estará disponible para GitHub Copilot en modo agente como un conjunto de herramientas MCP.
OpenCode
Agrega Cluefinch a opencode.jsonc:
{
  "$schema": "https://opencode.ai/config.json",
  "mcp": {
    "cluefinch": {
      "type": "local",
      "command": ["cluefinch"],
      "enabled": true
    }
  }
}
Qwen Code
Agrega Cluefinch a ~/.qwen/settings.json para la configuración a nivel de usuario, o a .qwen/settings.json para un proyecto específico:
{
  "mcpServers": {
    "cluefinch": {
      "command": "cluefinch",
      "args": []
    }
  }
}
Después de reiniciar Qwen Code, puedes verificar la conexión con el comando /mcp.
OpenClaw
Agrega Cluefinch con:
openclaw mcp add cluefinch --command cluefinch
O configúralo manualmente en openclaw.json:
{
  "mcp": {
    "servers": {
      "cluefinch": {
        "command": "cluefinch",
        "transport": "stdio"
      }
    }
  }
}
Para verificar la conexión:
openclaw mcp probe cluefinch
Hermes Agent
Agrega Cluefinch al archivo config.yaml utilizado por tu perfil de Hermes activo:
mcp_servers:
  cluefinch:
    command: "cluefinch"
    args: []
Reinicia Hermes después de guardar la configuración.
Configuración del comportamiento del agente
El agente formula consultas de búsqueda, selecciona fuentes y gestiona el proceso de investigación utilizando las herramientas disponibles de Cluefinch MCP. Puedes definir tus propias reglas para ese proceso a través de instrucciones en AGENTS.md o configuraciones equivalentes en tu herramienta de IA.
Esas instrucciones pueden regir tanto las búsquedas ordinarias como la investigación profunda de múltiples etapas, incluido cómo se deben usar las herramientas individuales de Cluefinch MCP.
Por ejemplo, puedes pedirle al agente que comience con un plan de investigación, ejecute varias consultas de refinamiento a través de web_search, use web_links para navegar por capítulos y páginas relacionadas, priorice fuentes primarias y lea documentos grandes de forma incremental con web_fetch.
Para la recopilación de múltiples fuentes y el filtrado inicial, el agente puede usar research_collect. Tus instrucciones también pueden definir reglas para reutilizar el contexto ya recopilado, verificar fuentes en conflicto, limitar iteraciones de búsqueda adicionales y mantener la evidencia fáctica separada de la interpretación.
El repositorio incluye un archivo AGENTS.md con un ejemplo listo para usar de este tipo de flujo de trabajo de Deep Research. Puedes usarlo como punto de partida, simplificarlo para investigaciones rápidas o adaptarlo a tus propias tareas, modelo y requisitos de salida.
Herramientas de Cluefinch MCP
A nivel de MCP, Cluefinch expone cuatro herramientas complementarias que llevan a un agente desde la búsqueda web hasta la lectura de fuentes específicas y luego a la investigación de múltiples fuentes.
web_search
web_search ejecuta búsquedas a través de la instancia de SearXNG configurada y devuelve enlaces a fuentes potencialmente útiles.
El agente puede controlar la cantidad de resultados, elegir motores de búsqueda e idioma, usar Safe Search, restringir la búsqueda a un dominio particular o excluir dominios no deseados. Cluefinch también informa cuando uno o más motores de SearXNG no responden, para que el agente no confunda un conjunto de resultados incompleto con uno completo.
web_fetch
web_fetch lee páginas web directamente. Cluefinch descarga el HTML de la URL especificada, extrae el texto principal, lo convierte a Markdown y devuelve solo la parte que el agente necesita.
El agente puede solicitar primero una pequeña vista previa de la página para juzgar si la fuente es útil y luego continuar leyendo solo si es necesario. Un documento largo se puede leer de forma incremental desde una posición elegida. Cluefinch devuelve next_start y una acción continuation lista para usar, por lo que el agente no necesita calcular la siguiente posición manualmente. Junto con el contenido, recibe los metadatos necesarios para continuar navegando por la misma versión retenida del texto extraído de manera segura.
web_links
web_links extrae enlaces HTTP/HTTPS de navegación de una página HTML y los devuelve en orden de documento. Permite que el agente inspeccione la estructura de una fuente que ya ha encontrado: secciones de documentación, capítulos de informes, paginación, apéndices, referencias a fuentes primarias y páginas relacionadas.
Esto es especialmente útil en Deep Research. Después de encontrar una fuente sólida, el agente puede inspeccionar su estructura, abrir solo las secciones relevantes con web_fetch y luego recopilar material de varias fuentes seleccionadas con research_collect. Esto reduce búsquedas innecesarias, ayuda a preservar el contexto de investigación y permite un trabajo más profundo con materiales primarios.
Los enlaces relativos se resuelven en URL absolutas utilizando la URL base del documento. Los enlaces se pueden filtrar por origen cuando sea necesario, y los conjuntos de enlaces grandes se pueden recuperar de forma incremental en múltiples solicitudes.
Cluefinch también versiona cada conjunto de enlaces retenido. Si la navegación de la página cambia entre solicitudes, el agente no continuará desde posiciones obsoletas en una lista desactualizada.
Extraer enlaces no realiza solicitudes a sus destinos. La validación completa de seguridad de salida se aplica solo si el agente decide más tarde obtener una de esas URL.
research_collect
research_collect está diseñado para trabajar con múltiples fuentes a la vez. Puedes proporcionar varias consultas de búsqueda, URL específicas o ambas.
Cluefinch recopila las fuentes disponibles, deduplica documentos por sus URL finales después de redirecciones e identifica los pasajes más relevantes en documentos largos. Cada pasaje seleccionado sigue siendo un fragmento exacto del texto extraído con coordenadas estables, por lo que el agente puede volver a él más tarde y solicitar contexto adicional cuando sea necesario.
Cada fuente recibe un source_id estable, mientras que los problemas de recopilación (como una URL inaccesible, una búsqueda fallida o un documento final duplicado) se informan explícitamente en gaps. El agente decide si se ha recopilado suficiente material y qué fuentes merecen una inspección más profunda.
Los esquemas completos de las herramientas, parámetros, límites y semántica de respuesta están documentados en docs/REFERENCE.md.
Qué hace que Cluefinch sea eficiente y seguro
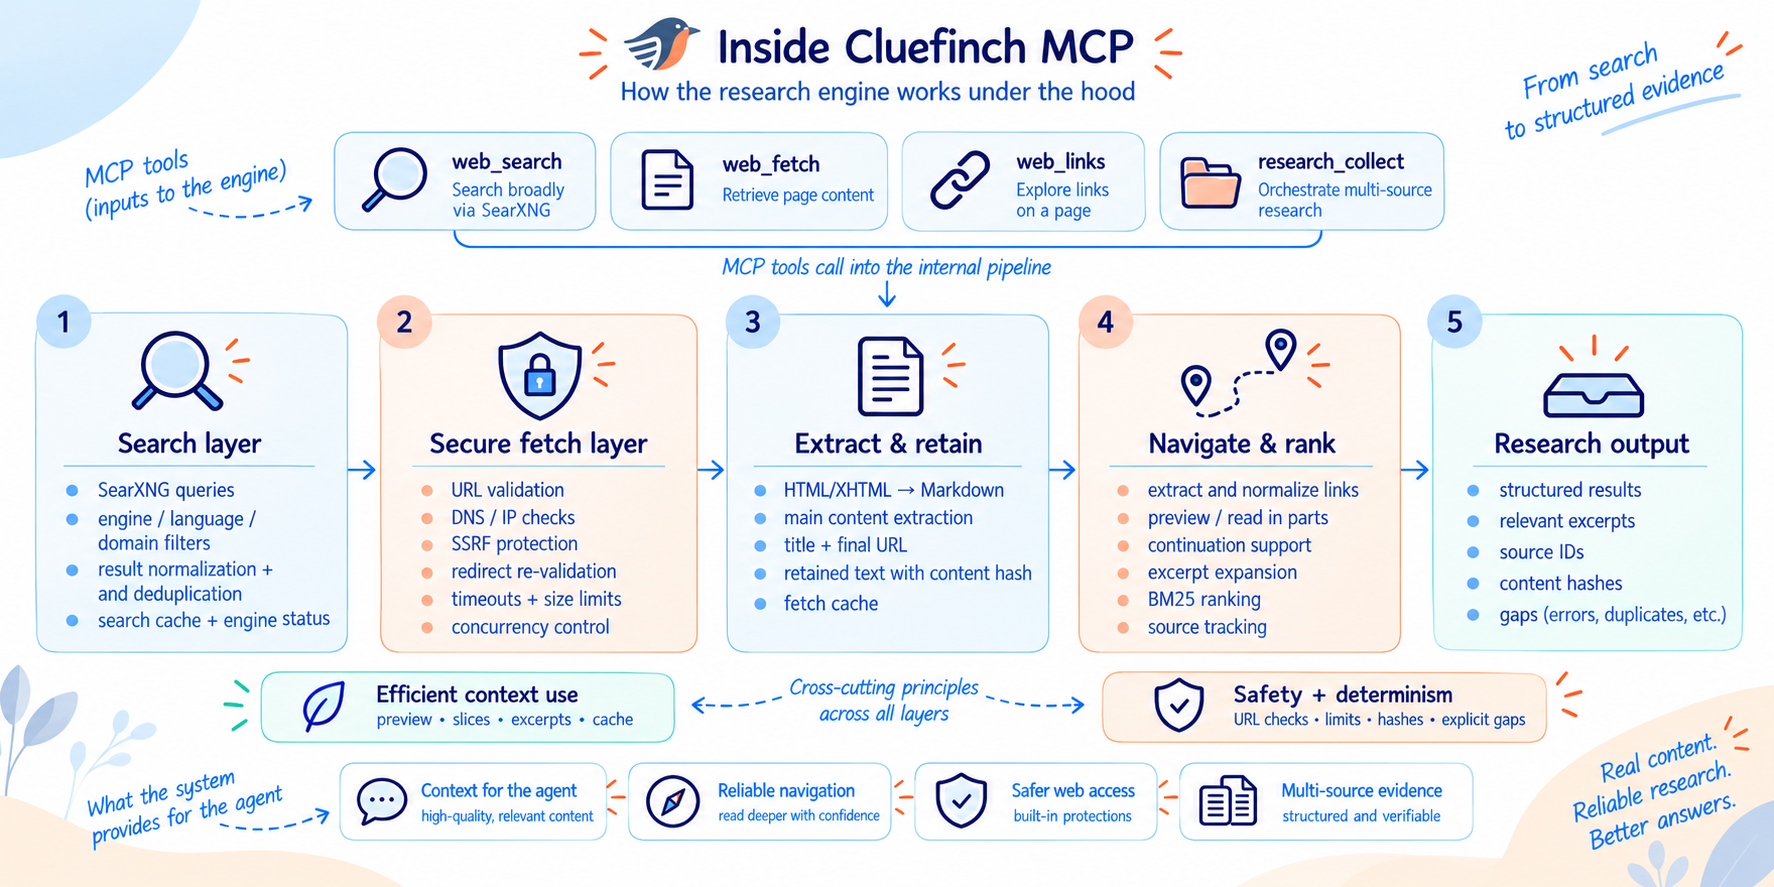
Detrás de las cuatro herramientas de Cluefinch MCP hay una capa de recuperación que maneja documentos largos, solicitudes repetidas, restricciones de red y acceso seguro a contenido externo.
Uso eficiente del contexto y los tokens
Cluefinch permite que el agente envíe solo la parte de una página necesaria para la tarea actual al modelo, en lugar de cargar todo el documento en el contexto.
Un documento extraído se puede leer de forma incremental. El agente recibe la posición del siguiente fragmento y continúa solo cuando realmente se necesita más contenido. Para pasajes de investigación individuales, también puede solicitar más contexto circundante sin volver a leer todo el documento.
La navegación utiliza posiciones en el texto extraído retenido, lo que permite que el agente regrese con precisión a pasajes previamente identificados. Esto ayuda al modelo a usar su ventana de contexto de manera más eficiente y gastar tokens solo en las partes de una fuente que importan para la etapa actual del trabajo.
Control de versiones para texto extraído
Cada versión retenida del texto extraído recibe un content_hash.
Cuando el agente continúa leyendo o expande un pasaje previamente seleccionado usando expected_content_hash, Cluefinch verifica ese hash. Las acciones listas para usar de continuación y expansión lo pasan automáticamente. Si el contenido de la página ha cambiado y las coordenadas antiguas ya no pueden considerarse fiables, la herramienta informa del cambio en lugar de devolver un pasaje obsoleto de la posición anterior.
Esto hace que la lectura continuada de fuentes cambiantes sea más fiable y reduce el riesgo de mezclar silenciosamente pasajes de diferentes versiones de un documento.
Procedencia y trazabilidad de las fuentes
Cluefinch conserva la URL final después de las redirecciones y deduplica las fuentes de nuevo contra la dirección final del documento. Como resultado, diferentes enlaces que conducen al mismo material no se convierten en fuentes independientes separadas.
Cada URL final normalizada recibe un source_id estable, lo que permite identificar la misma fuente de manera consistente en diferentes etapas del proceso de investigación.
Para documentos largos, Cluefinch divide el texto extraído en pasajes acotados y los clasifica por relevancia con BM25. Los pasajes seleccionados siguen siendo porciones exactas del texto fuente extraído con coordenadas, de modo que el modelo recibe material fuente que puede revisitarse y expandirse posteriormente con contexto adicional.
Limitaciones explícitas en lugar de suposiciones ocultas
Cluefinch informa explícitamente de las condiciones que pueden afectar a la integridad de los datos recuperados.
research_collect devuelve gaps cuando algunas fuentes no pueden recuperarse o procesarse. web_search informa por separado de los motores de SearXNG que no respondieron. Al leer una página, Cluefinch también distingue entre los casos en los que queda más texto retenido disponible y los casos en los que se descartó el final del documento extraído debido al límite de retención configurado.
Esto hace que la recuperación incompleta sea visible para el agente en lugar de presentar un resultado parcial como si fuera completo. El agente sigue decidiendo si se ha recopilado suficiente información para continuar el análisis o producir una respuesta.
Caché y reutilización de datos
Los resultados de búsqueda y las páginas extraídas se almacenan temporalmente en cachés locales TTL/LRU por proceso. Mientras una entrada en caché siga siendo válida, solicitar el mismo recurso de nuevo evita otra petición HTTP. Las URL de las páginas se siguen validando antes de reutilizar la caché, lo que puede implicar consultas DNS.
Las búsquedas y recuperaciones concurrentes idénticas de la misma página se combinan para que las acciones paralelas del agente no creen tráfico de red duplicado.
El almacenamiento en caché complementa la gestión del contexto: la lectura incremental ayuda a conservar los tokens del modelo, mientras que la caché local evita descargar repetidamente los mismos datos de internet.
Acceso seguro a páginas externas
Un agente puede recibir enlaces de resultados de búsqueda y de sitios web arbitrarios, por lo que Cluefinch trata cada URL como potencialmente no confiable.
Antes de recuperar contenido, Cluefinch valida el esquema de la URL, el nombre de host, los resultados DNS y las direcciones IP finales. Las direcciones locales, privadas, reservadas, multicast y otras no seguras se bloquean. La validación se repite después de las redirecciones y de nuevo inmediatamente antes de la conexión. Cluefinch se conecta a una IP numérica ya validada mientras conserva el nombre de host original para HTTP y TLS.
Cluefinch también limita el tamaño de la respuesta y de los datos descomprimidos, el número de redirecciones, el tiempo de descarga, la actividad de red concurrente y los recursos utilizados para la extracción de texto. Las peticiones al mismo host también se espacian en el tiempo.
Estas medidas están diseñadas principalmente para proteger contra SSRF y el consumo descontrolado de recursos. El texto de una página web sigue siendo contenido no confiable y no debe tratarse automáticamente como una instrucción por parte del agente.
Separación de la búsqueda y la recuperación de páginas web
Cluefinch utiliza SearXNG únicamente como backend de búsqueda. Ayuda a descubrir fuentes potenciales, pero no se utiliza como proxy para leer páginas web.
Cuando el agente abre una URL descubierta, Cluefinch recupera la página directamente a través de su propia capa de recuperación protegida. Mantener el descubrimiento y la recuperación separados permite gestionar de forma independiente la seguridad, el almacenamiento en caché, la extracción de texto y la lectura de documentos largos.
SearXNG sigue siendo un servicio separado, mientras que Cluefinch MCP se ejecuta localmente en el entorno del usuario y no requiere su propio servicio de recuperación en la nube ni telemetría integrada.
Configuración de Cluefinch MCP
Cluefinch MCP puede ajustarse a un entorno y una carga de trabajo de agente específicos mediante variables de entorno con el prefijo MCP_SEARCH_.
En la mayoría de los casos, los valores predeterminados son suficientes. Los ajustes principales son:
| Ajuste | Predeterminado | Propósito |
|---|---|---|
MCP_SEARCH_SEARXNG_URL | http://127.0.0.1:8081 | Dirección de SearXNG |
MCP_SEARCH_ENGINES | google,google cse,brave,wikipedia,wikidata | Subconjunto de motores explícito permitido; omitir engines usa los valores predeterminados de SearXNG |
MCP_SEARCH_MAX_RESULTS | 20 | Número máximo de resultados por búsqueda |
MCP_SEARCH_MAX_SOURCES | 10 | Número máximo de fuentes que research_collect puede intentar recopilar |
MCP_SEARCH_MAX_QUERIES | 10 | Número máximo de consultas de búsqueda en una llamada a research_collect |
MCP_SEARCH_MAX_FETCH_CHARS | 20000 | Tamaño máximo de un fragmento de página devuelto individual |
MCP_SEARCH_MAX_TEXT_CHARS | 100000 | Cantidad máxima de texto extraído retenido para una página |
MCP_SEARCH_FETCH_CONCURRENCY | 3 | Número máximo de recuperaciones de página concurrentes |
MCP_SEARCH_FETCH_TTL | 600 | Vida útil de las páginas recuperadas en la caché local, en segundos |
MCP_SEARCH_SEARCH_TTL | 300 | Vida útil de los resultados de búsqueda en la caché local, en segundos |
Por ejemplo, si SearXNG se está ejecutando en una dirección diferente:
export MCP_SEARCH_SEARXNG_URL=http://127.0.0.1:8888
Las mismas variables también pueden pasarse directamente a través de la configuración del servidor del cliente MCP.
La lista completa de ajustes, valores predeterminados y comportamiento exacto está documentada en docs/REFERENCE.md.
Limitaciones actuales
Cluefinch MCP está diseñado para buscar y recuperar páginas web ordinarias a través de HTTP/HTTPS. La versión actual admite extracción de HTML/XHTML y texto sin ejecutar un navegador completo.
Cluefinch MCP actualmente no incluye:
- Renderizado de JavaScript ni automatización de navegador;
- Extracción de texto PDF;
- Sesiones autenticadas ni páginas privadas;
- Evasión de CAPTCHA o muros de pago;
- Búsqueda vectorial ni recuperación basada en incrustaciones;
- SaaS alojado, API REST ni telemetría integrada.
Si una página depende casi por completo de JavaScript o no está disponible sin autenticación, el agente debe buscar una fuente HTML alternativa, documentación pública, un espejo u otra fuente accesible.
Estas limitaciones se aplican a la versión actual de Cluefinch MCP y ayudan a mantener la arquitectura local, predecible y bajo tu control.
Configuración de desarrollo
Para trabajar con el código fuente, necesitas uv y Python 3.12.4 o posterior.
git clone https://github.com/cluefinch/mcp-server.git
cd mcp-server
uv python install 3.12
uv sync --locked
A continuación, puedes ejecutar el servidor directamente desde el árbol de trabajo:
uv run cluefinch
Si necesitas una instancia local de SearXNG para desarrollo, usa el ejemplo de configuración listo para usar. Si ya tienes tu propia instancia de SearXNG, simplemente establece su dirección a través de MCP_SEARCH_SEARXNG_URL.
Las comprobaciones principales del proyecto son:
uv run ruff check mcp_search tests scripts
uv run ruff format --check mcp_search tests scripts
uv run pytest -q
uvx --from 'pyright==1.1.414' pyright --pythonpath .venv/bin/python mcp_search scripts
uv build
CI prueba las versiones de Python compatibles en Ubuntu y Windows y también verifica los límites inferiores de las dependencias directas.
La información detallada sobre el entorno de desarrollo local, las pruebas de humo, la configuración del IDE, la evaluación del comportamiento del agente y los requisitos del árbol publicable está disponible en docs/DEVELOPMENT.md.
Contribuciones, soporte y seguridad
Si quieres proponer un cambio, informar de un problema o contribuir al proyecto, comienza con CONTRIBUTING.md. Describe los requisitos para las solicitudes de extracción, las pruebas y el Certificado de Origen del Desarrollador (DCO).
Para preguntas de uso y soporte, consulta SUPPORT.md.
Si descubres una vulnerabilidad u otro problema relacionado con la seguridad, no publiques los detalles en un Issue normal de GitHub. El proceso de notificación responsable se describe en SECURITY.md.
Al crear Issues o Pull Requests públicos, no publiques secretos, URL privadas, contenido de páginas no públicas, archivos de captura locales u otros datos sensibles.
Licencia
El código original de Cluefinch MCP se distribuye bajo la Licencia Apache 2.0.
SearXNG se utiliza como un servicio externo separado y sigue licenciado bajo GNU AGPL-3.0. La licencia Apache-2.0 de Cluefinch MCP no se aplica a SearXNG, sus dependencias ni al contenido de las páginas web recuperadas por el agente.
La información adicional sobre los componentes de terceros y sus licencias está disponible en THIRD_PARTY_NOTICES.md, mientras que las consideraciones de integración y distribución de SearXNG están documentadas en docs/SEARXNG_COMPLIANCE.md.
Consulta NOTICE para obtener información sobre derechos de autor y atribución.