local-gpu-imagegen
Generación de imágenes local con GPU NVIDIA, controlada por confirmación, para agentes de IA mediante flujos de trabajo ComfyUI existentes, con identidad de modelo SHA-256, aprobación explícita de licencia y sin descargas silenciosas de modelos. Windows 10/11 x64 NVIDIA. MIT.
Documentación
Local GPU Imagegen
Un plano de control centrado en MCP con identidad criptográfica del modelo, aprobaciones explícitas y evidencia de ejecución duradera para la configuración de ComfyUI que ya utilizas.
Ejecuta un flujo de trabajo de ComfyUI compatible desde Codex sin modificar tu configuración.
uvx local-gpu-imagegen verify
uvx local-gpu-imagegen setup codex --apply
La configuración almacena un lanzador resuelto y con versión fijada equivalente a
uvx --from local-gpu-imagegen==0.9.1 local-gpu-imagegen serve; no depende de un script de consola del entorno temporal uvx. Si una entrada anterior informa client_setup_drift, elimina solo esa entrada de cliente y aplica la configuración nuevamente. Iniciar ComfyUI no repara un fallo del lanzador de MCP; la disponibilidad del backend se verifica después de que el cliente carga el servidor.
Pregunta a Codex:
Run this supported ComfyUI API workflow from Codex: <path>.
Use this prompt: <prompt>. Preserve every other workflow setting.
Esta ruta requiere Python 3.11 o 3.12, Codex, una instancia local de ComfyUI ya en ejecución, un modelo ya instalado y un flujo de trabajo de API txt2img ordinario que utilice la topología integrada compatible. Utiliza tu backend y modelo de imagen local existentes sin descargas ni cambios silenciosos de modelo. No instala un backend, descarga un modelo, convierte JSON de formato UI ni ejecuta un flujo de trabajo que requiera nodos personalizados no compatibles. A continuación se documenta una opción explícita de inicio administrado para Windows portátil.
El alcance de host compatible con v0.9 es Windows 10/11 x64 con NVIDIA. La rueda única py3-none-any describe empaquetado de Python puro, no una edición separada para Linux ni una afirmación de soporte de generación administrada en Linux. CI de Ubuntu verifica los contratos de MCP independiente de plataforma, empaquetado, backend existente y plataforma no compatible; Windows ejecuta la suite completa de arranque portátil.
ComfyUI genera los píxeles. Local GPU Imagegen controla la autoridad, la reproducibilidad, la revisión y la recuperación en torno a esa generación.
Inicio rápido de cinco minutos | Manual de lanzamiento | Alternativas
Trae tu propio flujo de trabajo de ComfyUI
La sesión retenida de incorporación de flujos de trabajo de Codex inspeccionó y registró un grafo compatible, luego vinculó sus componentes de modelo exactos; no envió un prompt ni utilizó la GPU. Los registros históricos de imágenes generadas permanecen disponibles para auditoría técnica, pero v0.9 no los utiliza como imágenes promocionales ni como evidencia de superioridad de calidad de imagen.
Esta ruta requiere un backend y modelo de imagen local existentes; no hay descargas ni cambios silenciosos de modelo.
Arranque guiado (Windows NVIDIA)
Para un entorno existente, ejecuta bootstrap status y reutiliza solo una raíz portátil verificada, un checkpoint y un endpoint de bucle de retorno. Para una configuración desde cero, bootstrap plan muestra el archivo portátil exacto, checkpoint, límite de bytes, URL de licencia, hashes SHA-256, requisitos de disco/VRAM y reversión acotada; bootstrap apply requiere la confirmación explícita mostrada. Las descargas son reanudables y nunca silenciosas. El alcance congelado es Windows 10/11 x64 con NVIDIA RTX serie 20 o posterior, 10 GiB de VRAM y 30 GiB de disco libre. Docker no es necesario. Este contrato de arranque sin modelo no demuestra generación de imágenes ni preparación para producción.
setup es de solo lectura sin --apply. La ruta de aplicación delega en el comando oficial mcp add del cliente; Local GPU Imagegen no edita archivos de configuración del cliente directamente ni descarga un modelo.
Prueba de confianza: el resultado retenido de la ruta ordinaria provino de una sesión instalada de Codex. El descubrimiento no cargó pesos; la identidad de confianza y ruta fue explícita; las rondas exitosas fueron acotadas; la revisión utilizó el PNG de resolución original; la finalización se vinculó a los bytes revisados; y el estado de ejecución permanece recuperable. La evidencia prueba este único resultado, no la aceptación completa 9+3, el rendimiento medido ni la preparación para producción.
Aceptación local de v0.9: una instalación nueva de Windows/NVIDIA construida desde el archivo de ComfyUI aprobado por el usuario y el checkpoint SDXL alcanzó disponibilidad administrada, sirvió exactamente diecisiete herramientas MCP y finalizó una imagen de entorno no humano revisada con hashes de origen y final idénticos byte a byte. El artefacto permanece local hasta una exportación saneada separada y no se incluye en el paquete. Dos intentos separados de personajes fallaron la revisión estricta de manos, ojos o cola; por lo tanto, la calidad de anatomía humana prominente no está establecida.
Inicio administrado opcional de ComfyUI
La configuración de Windows puede registrar una raíz portátil existente para inicio administrado:
uvx local-gpu-imagegen setup codex --apply `
  --auto-start-comfyui `
  --comfyui-root "<ComfyUI_windows_portable>"
El comando opcional valida el diseño portátil fijo y registra python_embeded\python.exe -s ComfyUI\main.py en 127.0.0.1:8188. No instala ComfyUI ni descarga un modelo. Un endpoint ya en ejecución se reutiliza pero nunca se posee ni se detiene. Un proceso hijo iniciado por el proceso MCP se detiene al salir de MCP solo cuando su cola está vacía; una cola no vacía se retiene y se informa. Ambos modos utilizan el backend y modelo existentes sin descargas ni cambios silenciosos de modelo. La ejecución del flujo de trabajo sigue limitada a topologías integradas compatibles; el inicio administrado no elimina ni gestiona nodos personalizados ya presentes en la instalación portátil seleccionada.
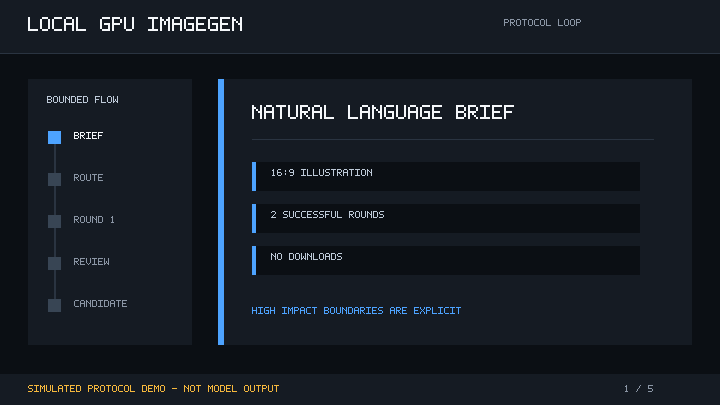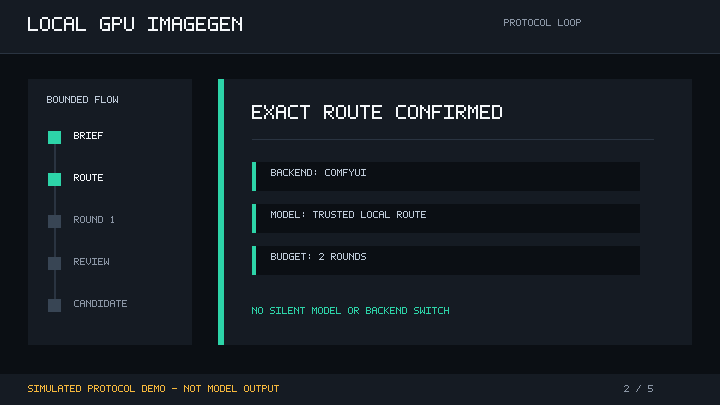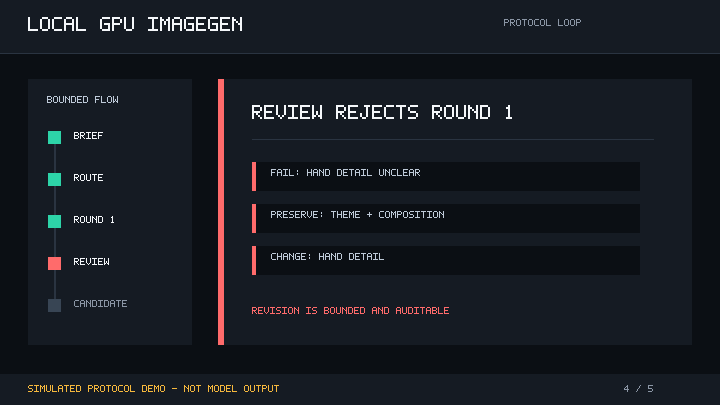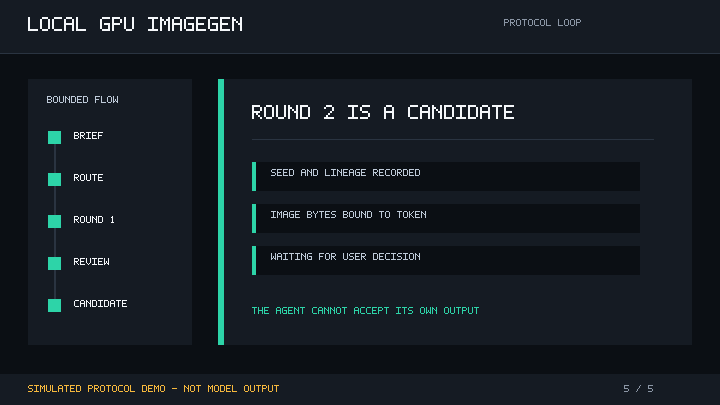
La animación es una demostración determinista simulada del protocolo, no salida de modelo ni evidencia de calidad de imagen. Sigue siendo secundaria al protocolo y a la evidencia de prueba. Las pruebas sin modelo cubren el protocolo y los contratos de backend, no la calidad de imagen, la generación más amplia de clientes nombrados, el rendimiento ni la aceptación completa 9+3.
Para Claude Code, usa uvx local-gpu-imagegen setup claude-code --apply. Elimina las entradas con codex mcp remove local-gpu-imagegen o claude mcp remove --scope user local-gpu-imagegen. Usa uvx local-gpu-imagegen doctor para inspeccionar la disponibilidad del backend local. Los contratos de configuración y los lanzamientos stdio equivalentes están verificados; se retiene una generación de cliente instalado de Codex, mientras que la generación de Claude Code sigue pendiente. Consulta Compatibilidad de clientes.
DeepSeek Harness (DSH) se conecta a través del mismo protocolo MCP stdio estándar sin comando de configuración: registra el servidor mediante dsh plugin --profile <name> add o apunta cualquier cliente compatible con MCP a scripts/mcp_server.py. Una ejecución real impulsada por DSH completó la secuencia completa de discover_models (api_only) → recommend_models → start_run → get_run → generate_round contra un checkpoint de ComfyUI en vivo y produjo un artefacto round-01.png; initialize/tools/list/ping, verify_mcp.py y verify_client_configs.py pasan todos.
Antes de la publicación en PyPI, instala la rueda verificada o un checkout de fuente, luego usa los comandos equivalentes local-gpu-imagegen verify y local-gpu-imagegen setup ....
Por qué este proyecto
- Ejecuta flujos de trabajo compatibles desde tu agente: inspecciona y registra grafos de API ordinarios de ComfyUI en lugar de reconstruirlos como scripts únicos.
- Reutiliza o gestiona explícitamente tu backend: ComfyUI es la ruta principal de flujo de trabajo existente; un supervisor portátil de Windows opcional elimina el inicio manual sin tomar posesión de un proceso existente. AUTOMATIC1111/Forge y Diffusers siguen siendo rutas de compatibilidad.
- Haz que las ejecuciones sean reproducibles: congela flujo de trabajo, identidad del modelo, prompts, configuraciones, semilla, presupuesto y hashes de salida en un manifiesto duradero.
- Usa el CLI instalado: verifica la disponibilidad y delega la configuración al comando oficial de Codex o Claude Code sin requerir un checkout de fuente.
- Mantén la autoridad del modelo explícita: el descubrimiento nunca carga pesos y la generación no puede descargar ni cambiar un modelo silenciosamente.
- Retén evidencia estructurada: rutas, presupuestos, intentos, hashes de imagen, revisiones y acciones de recuperación permanecen legibles por máquina y duraderos.
- Mantén la aceptación con el usuario: la revisión en resolución original y la finalización posterior vinculada a bytes separan una imagen generada de un final aceptado.
- Flujo de trabajo guiado por agente: una Agent Skill incluida convierte un resumen en lenguaje natural en una ejecución confirmada y limitada por catálogo.
- Tres perfiles de entrega: ilustraciones independientes, visuales de presentación y activos visuales de UI comparten un contrato determinista de ejecución y revisión.
- Revisión en caliente auditable: una ejecución hija inmutable registra un contrato de preservar/cambiar y utiliza refinamiento de prompt, img2img o inpainting confirmado explícitamente.
- Capa MCP ligera en dependencias: las verificaciones y pruebas de protocolo usan la biblioteca estándar de Python y no requieren GPU.
- Alcance enfocado: la generación de imágenes se mantiene separada de la planificación, la memoria y las características de agente no relacionadas.
Controles de composición experimentales
La ruta dorada usa sdxl-txt2img ordinario. Las rutas sdxl-regional-txt2img y sdxl-two-stage-copy-subject siguen siendo experimentales, no forman parte de la ruta dorada y no proporcionan respaldo desde la ruta ordinaria. Su evidencia negativa retenida no establece una mejora de calidad visual.
Límite de calidad de imagen
La calidad del modelo y del flujo de trabajo sigue siendo proporcionada por el usuario. Local GPU Imagegen agrega ejecución, revisión, recuperación y evidencia explícitas; no modifica algoritmos de difusión ni garantiza que un flujo de trabajo de prompt mejore una imagen. La revisión ahora trata un cambio en el medio de producto solicitado, sujeto, uso práctico o ranura de activo como sustitución semántica y una restricción fallida, incluso cuando el reemplazo se ve más limpio.
Consulta Control de calidad de imagen y la puerta congelada de no regresión de flujo de trabajo. La puerta retenida terminó en FAIL_WORKFLOW_REGRESSION; no se respalda ninguna afirmación pública de superioridad de calidad de imagen.
Checkout de fuente y configuración de backend
1. Verifica el servidor MCP
Python 3.11 o 3.12 es suficiente para esta verificación. No se requiere GPU, modelo ni cliente de IA.
python .\scripts\verify_mcp.py
Resultado esperado:
{
  "ok": true,
  "transport": "stdio",
  "python": "<current-python>",
  "server": {"name": "local-gpu-imagegen", "version": "0.9.1"},
  "protocolVersion": "2024-11-05",
  "tools": [
    "local_gpu_branch_run",
    "local_gpu_cleanup_run",
    "local_gpu_confirm_mask",
    "local_gpu_discover_models",
    "local_gpu_finalize_run",
    "local_gpu_generate_image",
    "local_gpu_generate_round",
    "local_gpu_get_run",
    "local_gpu_imagegen_check",
    "local_gpu_list_profiles",
    "local_gpu_prepare_mask",
    "local_gpu_recommend_models",
    "local_gpu_record_review",
    "local_gpu_register_workflow",
    "local_gpu_set_model_trust",
    "local_gpu_start_run",
    "local_gpu_inspect_workflow"
  ]
}
2. Elige un backend
| Backend | Mejor cuando | Configuración | Comportamiento de red |
|---|---|---|---|
| WebUI | AUTOMATIC1111 o Forge ya está instalado | Inícialo con acceso a API habilitado | Los prompts/imágenes van a la URL de WebUI configurada |
| ComfyUI | Ya ejecutas ComfyUI y deseas ejecución de grafos revisada | Inícialo tú mismo u opta por setup --auto-start-comfyui --comfyui-root <root> para una instalación portátil de Windows existente | Los prompts/imágenes van solo al endpoint de bucle de retorno o confirmado por separado |
| Diffusers | Deseas un pipeline de Python autocontenido | Crea el proyecto .venv con scripts/install.ps1 | Las descargas de modelo/LoRA están bloqueadas a menos que se permitan explícitamente |
Verifica la disponibilidad actual:
python .\scripts\check_gpu.py
El comando devuelve JSON. ready: false es un estado de diagnóstico válido, no un fallo de protocolo.
El inicio administrado es explícito y solo para Windows portátil. Fuerza el aislamiento de Python -s para que los paquetes Torch de sitio de usuario no puedan contaminar el runtime portátil, se inicia en segundo plano para que la inicialización de MCP no se retrase y permite que la primera verificación de disponibilidad administrada espere hasta el tiempo de espera de inicio configurado. doctor en sí sigue siendo de solo lectura y nunca inicia un backend.
Para verificar el servidor MCP bajo un entorno virtual específico y llamar a la disponibilidad a través de MCP:
python .\scripts\verify_mcp.py `
  --python .\.venv\Scripts\python.exe `
  --check-readiness
3. Conecta un cliente MCP
El .mcp.json incluido usa un comando relativo y cwd. Para un cliente con configuración global, reemplaza <project-root> con la ruta absoluta de este clon:
{
  "mcpServers": {
    "local-gpu-imagegen": {
      "command": "python",
      "args": ["<project-root>\\scripts\\mcp_server.py"]
    }
  }
}
Reinicia el cliente y luego llama a local_gpu_imagegen_check antes de la primera generación.
4. Solicita un activo visual
La Agent Skill incluida acepta solicitudes ordinarias. Por ejemplo:
Crea una ilustración independiente de personaje anime en 16:9 sin texto generado. Usa hasta dos rondas exitosas, mantén las descargas deshabilitadas y pregunta antes de cambiar la semilla.
La Skill no adivinará a partir de un nombre de archivo de checkpoint ni seleccionará silenciosamente un backend. Descubre el inventario local actual, aplica confianza local del usuario, recomienda una ruta exacta y espera confirmación sin descargar un modelo.
Flujo de trabajo de la Agent Skill
- Llama a
local_gpu_discover_modelsen modoapi_onlycuando el inventario sea desconocido. Los escaneos más amplios requieren un plan mostrado y una confirmación exacta antes del acceso al sistema de archivos. - Usa
local_gpu_set_model_trustsolo después de mostrar una identidad exacta y recibir su confirmación de confianza exacta. El uso privado y la evidencia pública son ámbitos separados. - Llama a
local_gpu_list_profilespara el ámbito de autorización previsto. Reutiliza valores breves conocidos y pregunta solo por los límites de alto impacto que falten. - Llama a
local_gpu_recommend_models. Devuelve una ruta exacta y como máximo dos alternativas sin debilitar los requisitos estrictos. - Muestra el
model_choiceresuelto exacto, el backend, la identidad/fuerza del hash o la advertencia de vinculación, el flujo de trabajo, el compilador, las dimensiones y el presupuesto. Espera una nueva confirmación explícita después de esa visualización. - Inicia la ruta congelada -> lee la ejecución persistida congelada -> construye el plan de generación completo -> gasta como máximo el presupuesto confirmado de rondas exitosas. Copia cada campo de ruta, identidad, flujo de trabajo, compilador, política y presupuesto de esa ejecución antes de agregar indicaciones y parámetros. Una imagen retenida consume una ronda; una falla del backend no.
- En un host con capacidad de visión, muestra e inspecciona la imagen original a resolución completa. Registra las comprobaciones requeridas de anatomía, pies/contacto, manos/objetos y texto/marca de agua con la rúbrica completa; una vista previa por sí sola es insuficiente. Las comprobaciones fallidas o inciertas requieren refinar o explorar. Un refinamiento conserva la semilla; una exploración cambia la semilla.
- Cuando una revisión elegible devuelva el estado de calidad
candidate, muestra sus limitaciones, el SHA-256 de la imagen y el valor exacto definalize:<run_id>:<round_number>:<image_sha256>, luego detente. Solo un mensaje posterior del usuario que contenga ese valor mostrado puede autorizar la finalización; el Agente no puede aceptar su propio candidato. - En un host solo de texto, retén exactamente una ronda exitosa, marca
review unavailable, informa la ruta no revisada y detente. No inventes puntuaciones ni llames a herramientas de revisión/finalización.
Después de un candidato revisado o finalizado, el usuario puede describir qué conservar y qué cambiar. La Skill presenta un contrato auditable de conservar/cambiar, solicita un presupuesto de revisión separado de una a tres rondas y crea una ejecución secundaria inmutable solo después de la confirmación. Elige el modo menos destructivo: refinamiento de indicaciones con la misma semilla, luego img2img de baja intensidad, luego inpainting con confirmación explícita de superposición de máscara. La preservación sin máscara es de mejor esfuerzo.
Para la ruta opcional copy-subject-v1, el Agente muestra ambas regiones normalizadas como decimales y porcentajes, ambas indicaciones regionales e intensidades, la ruta exacta de sdxl-regional-txt2img y el presupuesto de rondas exitosas antes de la confirmación. La geometría está congelada para esa ejecución. El refinamiento puede cambiar las indicaciones regionales o las intensidades, pero mover una región requiere una raíz o secundaria recién confirmada; la capacidad regional no disponible o desviada nunca recurre a sdxl-txt2img solo con indicaciones.
Para la ruta opcional sdxl-two-stage-copy-subject, local_gpu_set_model_trust acepta el two_stage_layout exacto; los llamadores nunca proporcionan control_sha256. El servidor normaliza ese diseño, inspecciona el flujo de trabajo incluido, deriva el resumen de control e incluye los resúmenes de flujo de trabajo, paquete y control en la confirmación de confianza mostrada. La aprobación y el enrutamiento posterior requieren el mismo diseño normalizado, flujo de trabajo, paquete de componentes, endpoint e identidad del modelo. El Agente también muestra la geometría de píxeles y los porcentajes, las semillas base y derivada del sujeto, el condicionamiento del sujeto y el presupuesto de dos etapas. Una ronda cuesta dos unidades de etapa y retiene tres PNG vinculados a roles: un artefacto base, un artefacto de máscara y un artefacto final. Las compuertas de píxeles protegidos y máscara guardada se ejecutan antes de la revisión; un resultado parcial se detiene sin respaldo. Tanto la base como la final reciben revisión de etapa a resolución completa, y solo el artefacto final puede convertirse en candidato. La primera compuerta de GPU en vivo es exactamente una ronda de dos etapas.
La ruta regional anterior de una sola pasada copy-subject-v1 permanece como evidencia negativa retenida y compatibilidad experimental. Su contrato de control sin modelo sigue siendo útil, pero la salida observada no establece una mejora de calidad visual. Ninguna ruta se presenta como evidencia positiva de calidad de imagen hasta que exista una aceptación retenida a resolución completa.
La secuencia adaptativa es descubrimiento -> confianza cuando sea necesario -> catálogo limitado -> breve -> recomendación de ruta exacta -> confirmación posterior a la visualización -> inicio -> leer ejecución persistida -> construir plan completo -> generar -> inspección a resolución completa -> revisar -> refinar/explorar o mostrar candidato -> esperar un mensaje posterior del usuario -> finalizar. El max_rounds configurado debe ser desde 1 hasta 3, y la urgencia o el costo hundido nunca lo extiende.
Perfiles Visuales Y Alcance
| Perfil | Subtipos admitidos | Enfoque de entrega |
|---|---|---|
standalone-illustration | character, environment, wallpaper | Salida de ilustración autocontenida. |
presentation-visual | cover, section, content-background | Activos de diapositivas solo visuales con restricciones de área segura y superposición. |
ui-visual-asset | hero, section-illustration, rectangular-background, decorative-texture | Visuales rasterizados que se pueden componer en una interfaz. |
Las presentaciones PPT completas están excluidas. El código de frontend y los componentes están excluidos. Los íconos de producción, SVG y PNG transparente están excluidos. La segmentación automática está excluida. Las garantías de textura sin costuras están excluidas. El proyecto produce activos rasterizados inspeccionables, no diseños de diapositivas ni implementaciones de interfaz.
Trae Tu Propio Modelo de Forma Segura
El descubrimiento tiene cuatro niveles: api_only, selected_folders, common_locations y full_drive. El descubrimiento del sistema de archivos es de dos etapas: index registra metadatos limitados sin abrir cargas útiles de checkpoint; fingerprint calcula SHA-256 solo para candidatos indexados explícitamente seleccionados. .ckpt permanece opaco, y los escaneos no siguen enlaces simbólicos, uniones ni puntos de reanálisis.
La confianza se almacena fuera del repositorio bajo el directorio de estado del usuario del sistema operativo, anulable con LOCAL_GPU_IMAGEGEN_STATE_DIR. Una identidad backend_binding puede ser confiable solo para uso private. Para rutas divididas de ComfyUI, la herramienta de confianza primero ofrece una acción de inspección no mutante que vincula el modelo principal, el codificador de texto, la VAE y el flujo de trabajo revisado en un paquete SHA-256 canónico. El resumen exacto del paquete es parte de la confirmación de confianza posterior y del token de ruta. Un paquete criptográfico puede convertirse en candidato public_evidence solo con metadatos exactos de fuente, licencia y redistribución de salida para cada componente; la autoridad de aceptación debe aprobar ese mismo paquete antes de la exportación.
Incorporación Segura de Flujos de Trabajo
Los flujos de trabajo existentes en formato API de ComfyUI pueden inspeccionarse y registrarse sin ID de nodo proporcionados por el llamador cuando son gráficos txt2img ordinarios que usan un solo checkpoint o topología de modelo dividida. La secuencia limitada es:
API-only discovery (when current inventory is absent)
-> local_gpu_inspect_workflow
-> display hashes, inferred binding, components, limitations, confirmation
-> later exact user confirmation
-> local_gpu_register_workflow
-> separate local_gpu_set_model_trust with `registered_workflow_id`
La inspección lee un archivo JSON local explícito, acepta un gráfico API simple o un envoltorio prompt único, e informa source_sha256, workflow_sha256, topología, vinculación inferida, salida propia e identidades de componentes. Los resultados registrables incluyen register_workflow:<source_sha256>:<proposal_digest>; los resultados de diagnóstico no tienen confirmación. El formato de UI no se convierte; el registro no otorga confianza del modelo ni autoridad pública. La evidencia de incorporación de cliente real con cero GPU se retiene; la evidencia de generación permanece separada.
No se incluyen pesos de modelo. El catálogo del repositorio incluye el ID auditable civitai/anything-v5@30163 para un checkpoint local de WebUI ya revisado, y las descargas siguen sin aprobarse. Otros modelos locales pueden ingresar al catálogo privado solo mediante descubrimiento y confianza explícita; la calidad del modelo aún proviene del modelo del usuario. Este proyecto agrega enrutamiento más seguro, revisión duradera y revisión en caliente en lugar de reclamar un traductor de indicaciones superior.
ComfyUI incluye flujos de trabajo revisados sd15-txt2img-v1.json, sdxl-txt2img-v1.json, sdxl-regional-txt2img-v1.json, sdxl-two-stage-copy-subject-v1.json, z-image-turbo-txt2img-v1.json y anima-txt2img-v1.json. El descubrimiento distingue CheckpointLoaderSimple, UNETLoader, CLIPLoader y VAELoader. Una ruta privada vinculada al backend puede vincular solo el cargador principal, pero la elegibilidad de evidencia pública para un flujo de trabajo dividido requiere identidades API actuales más identidades SHA-256 del sistema de archivos para cada componente congelado. Una instalación de modelo dividido puro puede no tener opciones de checkpoint. Se rechazan shell, ejecución de Python/script/proceso, nodos de red/descarga/webhook/fetch, comandos, nodos personalizados desconocidos, parámetros no vinculados y excesos de recursos.
Los archivos de flujo de trabajo no incluyen, instalan, confían ni licencian pesos de modelo. Z-Image y Anima aún requieren descubrimiento local exacto, aprobación del usuario y una ruta confirmada. Anima es una ruta de anime opcional y no debe presentarse como un valor predeterminado comercial o de evidencia pública bajo sus restricciones de peso ascendente. Adaptador ComfyUI: probado por contrato; ejecuciones de adaptador local Z-Image y Anima: observadas; evidencia de aceptación pública: no retenida.
Referencia de Herramientas
La superficie pública de MCP tiene exactamente diecisiete herramientas: dos herramientas de compatibilidad y quince herramientas de alto nivel de descubrimiento/incorporación/ejecución/revisión.
local_gpu_imagegen_check
Informa paquetes de Python, dispositivos CUDA, accesibilidad de WebUI y preparación agregada. Una máquina puede no estar lista mientras la llamada a la herramienta en sí tiene éxito.
local_gpu_generate_image
Admite:
txt2img,img2imge inpainting- semillas fijas
- selección de checkpoint y muestreador de WebUI
- selección de programador de Diffusers
- carga de LoRA
- teselado de VAE y descarga opcional de CPU
- respaldo explícito de CPU
- permiso explícito de descarga de modelo/LoRA
El esquema de la herramienta valida tipos, rangos, enums, campos desconocidos, requisitos de modo de imagen y dimensiones antes de iniciar el proceso del backend.
Estas dos herramientas de compatibilidad permanecen disponibles junto a las quince herramientas de alto nivel. En particular, la herramienta de compatibilidad de bajo nivel local_gpu_generate_image no cambia: su valor de modelo opcional sigue siendo un paso directo de compatibilidad y no es el flujo de trabajo del Agente limitado por catálogo. Sus opciones de WebUI/Diffusers y controles explícitos de descarga de modelo no cambian.
Herramientas de Ejecución de Alto Nivel
| Herramienta | Responsabilidad |
|---|---|
local_gpu_discover_models | Planificar o ejecutar inventario limitado de API/sistema de archivos sin cargar pesos de modelo. |
local_gpu_inspect_workflow | Inspeccionar un flujo de trabajo txt2img de API de ComfyUI ordinario y devolver hashes y vinculaciones de diagnóstico o registrables. |
local_gpu_register_workflow | Revisar una propuesta exacta y almacenar su copia de flujo de trabajo registrada inmutable después de la confirmación vinculada al resumen posterior. |
local_gpu_set_model_trust | Inspeccionar un paquete de componentes revisado sin mutación, o aprobar/revocar una identidad exacta en el estado local del usuario después de la confirmación. |
local_gpu_recommend_models | Devolver una ruta determinista y como máximo dos alternativas explicadas. |
local_gpu_list_profiles | Listar perfiles de casos de uso registrados y las capacidades actuales del backend. |
local_gpu_start_run | Persistir una intención confirmada, perfil, restricciones, elección de backend y presupuesto de rondas. |
local_gpu_get_run | Leer el manifiesto duradero y su recoverable_next_actions. |
local_gpu_branch_run | Crear una ejecución secundaria inmutable a partir de una ronda principal revisada y un contrato de conservar/cambiar. |
local_gpu_prepare_mask | Preparar una máscara de usuario o rectángulo/polígono y devolver una superposición JPEG limitada. |
local_gpu_confirm_mask | Confirmar una máscara preparada sin cambios después de la aprobación explícita del usuario. |
local_gpu_generate_round | Generar una ronda raíz o secundaria de modo fijo y opcionalmente devolver una vista previa JPEG limitada. |
local_gpu_record_review | Almacenar puntuaciones de rúbrica, comprobaciones visuales estructuradas requeridas, fallas graves, resultados de restricciones y preservación, crítica y próxima acción. |
local_gpu_finalize_run | Verificar la confirmación del usuario vinculada a la imagen y publicar la ronda elegible nominada como el PNG local final. |
local_gpu_cleanup_run | Eliminar intermedios o el directorio completo de ejecución confirmada. |
max_rounds debe estar desde 1 hasta 3. Solo las rondas PNG retenidas con éxito consumen ese presupuesto; un fallo del backend se registra como un intento sin consumir una ronda. Cada nueva revisión requiere full_resolution_inspected: true, ya sea que haya una persona prominente presente, y observaciones explícitas sobre la separación de extremidades, pies/contacto, manos/objetos sostenidos y texto/marcas de agua. Las comprobaciones de anatomía humana no pueden ser not_applicable; cualquier resultado de fail o uncertain requerido solo puede solicitar refinar o explorar. |
Una revisión elegible expone el estado de calidad candidate, nunca la aceptación, y vincula la ejecución, la ronda y el SHA-256 de la imagen retenida. El Agente muestra la imagen original, las limitaciones, el hash y el finalize:<run_id>:<round_number>:<image_sha256> exacto, y luego espera un mensaje posterior del usuario. local_gpu_finalize_run requiere esa confirmación exacta más el round_number nominado y el resumen. Revalida el candidato bajo el bloqueo de ejecución y luego publica esa ronda revisada nominada sin sustituir una ronda de mayor puntuación; solo el resultado publicado recibe accepted.
Un artefacto revisado no elegible nunca se publica. Refina o explora mientras quede presupuesto confirmado; de lo contrario, retenlo y solicita una nueva decisión del usuario sin publicación. Los manifiestos finalizados existentes y la ruta de compatibilidad de la capa inferior aún pueden contener needs_user_review, pero una revisión heredada no finalizada sin comprobaciones visuales estructuradas no puede producir un candidato de motor público.
local_gpu_list_profiles devuelve el catálogo combinado con ámbito y las capacidades actuales. local_gpu_start_run requiere el route_token exacto, el ámbito de autorización, el modelo, el backend, las dimensiones, el flujo de trabajo y el compilador que se mostraron. La deriva de identidad falla antes de la invocación del backend; las ejecuciones raíz e hijas nunca cambian de ruta en silencio.
Archivos de Ejecución, Reintento y Recuperación
El diseño duradero predeterminado es:
outputs/
  runs/
    <run_id>/
      manifest.json
      parent-source.png
      round-01.png
      round-01-preview.jpg
      final.png
      final-upscaled.png
      masks/
        mask-01.png
        mask-01-overlay.jpg
outputs/runs/<run_id>/manifest.json es la fuente de verdad para la entrada confirmada, intentos, rondas, revisiones, advertencias, metadatos finales y revisiones de estado. Una primera ronda exitosa retiene round-01.png y puede crear round-01-preview.jpg; las rondas posteriores usan el mismo patrón de vista previa con guiones. Los manifiestos heredados almacenados que hacen referencia a round-01.preview.jpg siguen siendo legibles y no se reescriben. La finalización publica final.png. Un archivo de vista previa es opcional: la respuesta MCP puede incluir la vista previa JPEG limitada, mientras que full_image_path identifica el PNG local de resolución completa. Una advertencia de vista previa o un fallo de codificación no descarta el PNG validado.
Una ejecución hija inmutable copia el PNG principal seleccionado a parent-source.png, registra el linaje y los hashes del padre, y nunca escribe el manifiesto principal. Img2img e inpaint usan esa fuente retenida. Inpaint además requiere un masks/mask-01.png confirmado; masks/mask-01-overlay.jpg se devuelve para aprobación primero. Cambiar los bytes de la fuente o la máscara invalida la confirmación.
Cada solicitud de generación necesita un idempotency_key. Repetir la misma clave con la misma solicitud devuelve la ronda completada o informa que el intento está ocupado; reutilizar la clave para entradas diferentes se rechaza. Después de una interrupción, llama a local_gpu_get_run y sigue recoverable_next_actions. El motor puede reclamar intentos obsoletos y reanudar la creación de vistas previas cuando ya se retuvo un PNG completo validado.
La limpieza es explícita. Tanto para intermediates como para all, la confirmación debe ser exactamente igual al run_id. El ámbito intermediates preserva el manifiesto y el archivo final publicado; all elimina el directorio de ejecución confirmado.
Postprocesado Opcional Anime Real-ESRGAN
El postprocesado 4x solo para anime es explícito y local. Configura la raíz de la herramienta solo con LOCAL_GPU_IMAGEGEN_REALESRGAN_DIR; el servidor acepta solo realesrgan-ncnn-vulkan.exe más uno de los pares de modelos compatibles, realesrgan-x4plus-anime o realesr-animevideov3-x4, bajo esa raíz. No acepta rutas de ejecutables arbitrarias ni nombres de modelos, y no descarga binarios ni modelos.
Ningún postprocesador se ejecuta automáticamente. Incluso upscale_policy: auto registra solo el permiso: el llamador debe pasar el objeto postprocess exacto a local_gpu_finalize_run, y el estilo confirmado debe ser anime. Una solicitud exitosa preserva el final.png original, devuelve final-upscaled.png y registra el modelo, la escala, las rutas de origen/salida, los hashes, las dimensiones y los tipos MIME en los metadatos finales del postprocesado. El postprocesado no disponible o fallido vuelve al final original con una advertencia estructurada. El comportamiento real del binario, GPU, calidad y rendimiento sigue sin verificar.
Uso Independiente
Genera a través de una WebUI ya en ejecución:
python .\scripts\generate_image.py `
  --backend webui `
  --prompt "a small robot reading a circuit diagram, clean concept art" `
  --width 1024 --height 1024 --seed 42
Crea un entorno Diffusers local al proyecto:
powershell -ExecutionPolicy Bypass -File .\scripts\install.ps1
Diffusers no descargará archivos de modelo faltantes por defecto. Después de revisar la licencia del modelo y el requisito de almacenamiento, opta por una ejecución específica:
.\.venv\Scripts\python.exe .\scripts\generate_image.py `
  --backend diffusers `
  --model stabilityai/sd-turbo `
  --allow-download `
  --prompt "a compact lunar research station, technical concept art" `
  --seed 42
Los archivos de la herramienta de compatibilidad usan por defecto outputs/. Anula esto con LOCAL_GPU_IMAGEGEN_OUTPUT_DIR o --output-dir. Las ejecuciones de alto nivel usan el diseño runs/<run_id>/ bajo esa raíz de salida.
Arquitectura
flowchart LR
    A["MCP client"] -->|"stdio JSON-RPC"| B["Thin MCP server"]
    B --> H["Discovery + trust + capability router"]
    H --> C["Frozen route + durable run engine"]
    C --> E["AUTOMATIC1111 / Forge adapter"]
    C --> I["Reviewed ComfyUI workflow adapter"]
    C --> F["Diffusers compatibility runner"]
    E --> G["Full local PNG + bounded preview"]
    I --> G
    F --> G
    G --> C
    C --> B
    B --> A
La capa de transporte posee JSON-RPC, esquemas, validación, despacho, tiempos de espera y resultados estructurados. El motor de ejecución posee la orquestación y delega el estado duradero a RunStore; la carga del backend y la generación de imágenes permanecen en scripts/generate_image.py.
Consulta Arquitectura para el flujo de control detallado y el modelo de errores.
Seguridad y Privacidad
- El proceso MCP no usa una API de imágenes en la nube específica de la aplicación.
- Un endpoint LAN WebUI/ComfyUI confirmado envía indicaciones e imágenes de origen a ese servidor. Loopback es local; cada endpoint LAN requiere confirmación de transmisión exacta, y los endpoints de internet público se rechazan.
- El descubrimiento no sigue enlaces ni carga cargas útiles de checkpoints. Los escaneos más amplios del sistema de archivos requieren un plan sin cambios, sin expirar y confirmación exacta.
- El estado de confianza permanece fuera de Git. La confianza privada nunca autoriza evidencia pública, y las credenciales se rechazan recursivamente.
scripts/install.ps1descarga paquetes de Python cuando el usuario lo ejecuta.- Las descargas de modelos y LoRA de Diffusers requieren
--allow-downloado MCPallow_download: true. - Deshabilitar el verificador de seguridad del modelo es explícito y está desactivado por defecto.
- Las imágenes de entrada y los archivos generados permanecen como archivos locales ordinarios; protege sus directorios con permisos del sistema operativo apropiados para su sensibilidad.
Consulta Seguridad antes de exponer una API WebUI más allá de localhost.
Pruebas
La suite no requiere GPU y no descarga modelos:
python -m unittest discover -s tests -v
python .\scripts\verify_mcp.py
La cobertura incluye inicialización/lista/ping del protocolo, el contrato exacto de diecisiete herramientas, descubrimiento/incorporación/confianza/enrutamiento limitados, contratos de adaptadores WebUI y ComfyUI, transiciones duraderas raíz/hija, comportamiento fijo de ruta/condicionamiento/agotamiento SDXL de dos regiones, confirmación de máscara, idempotencia, recuperación de intentos obsoletos, publicación atómica, manejo de vistas previas limitadas, el bucle anime simulado/sin modelo, los nueve briefs fijos y tres revisiones hijas, postprocesado con ejecutor falso y política de descarga.
Estado del Proyecto
Verificado:
- Inicialización MCP stdio, listado de herramientas, ping y contrato de herramientas
- Resultados estructurados de éxito/error de herramientas
- Quince herramientas de alto nivel de descubrimiento/incorporación/ejecución/revisión y dos herramientas de compatibilidad bajo cobertura simulada/sin modelo
- Briefing adaptativo de Skill del Agente, confirmación exacta del modelo, presupuesto de rondas exitosas y política de detención honesta solo con texto
- Identidad exacta del modelo local, confianza local del usuario, ruta determinista y contratos de rechazo de deriva
- Comportamiento explícito del adaptador Real-ESRGAN solo anime bajo pruebas de ejecutor falso
- Rutas de éxito/fallo de adaptadores WebUI y ComfyUI probadas por contrato
- Transiciones de manifiesto duraderas, idempotencia, recuperación, revisión, finalización y contratos de limpieza
- Tres contratos de Perfil más ejecuciones hijas inmutables de preservar/cambiar y geometría/máscaras de usuario confirmadas
- Geometría fija de copia/sujeto, condicionamiento regional, rechazo de deriva de ruta y una rebanada vertical regional sin modelo de dos rondas
- Identidad de control de dos etapas derivada del servidor, confirmación de confianza vinculada al control, rechazo de vinculación contradictoria y recuperación de ruta exacta sin modelo
- Una matriz de contratos de backend falso que cubre nueve briefs fijos y tres revisiones hijas
- Política de hub Diffusers local solo por defecto
- Contratos CLI instalables
serve,doctor,verify,configysetupde solo lectura por defecto, incluida una prueba de humo de rueda aislada - Análisis de contratos de configuración oficiales de Codex y Claude Code más lanzamientos stdio equivalentes de diecisiete herramientas; Claude Desktop sigue siendo una plantilla heredada solo de renderizado
Pendiente antes de una afirmación 1.0:
- Una matriz de aceptación real completa retenida 9+3 de host/visión
- Evidencia real de ejecución de binario/GPU Real-ESRGAN
- Evidencia adicional de sesiones de clientes nombrados generados más allá del resultado retenido de Codex, incluido Claude Code
- Datos medidos de rendimiento o VRAM
- Cualquier afirmación de preparación para producción
La matriz simulada/sin modelo es evidencia de protocolo determinista, no el resultado real retenido de Codex/visión/GPU. Ejercita nueve briefs fijos y tres revisiones hijas con un backend falso; no prueba la calidad visual. Las llamadas locales Z-Image y Anima a través del adaptador del proyecto se han observado, pero son validación de desarrollo local, no evidencia de aceptación pública. Los registros históricos de imágenes generadas siguen siendo material de auditoría técnica y no son visuales promocionales v0.9. La suite de pruebas no carga un modelo de producción, backend GPU o binario Real-ESRGAN. No se hace ninguna afirmación de producción, rendimiento, VRAM, superioridad de calidad de imagen, Star garantizado o generación más amplia de clientes nombrados.
El repositorio no tiene una imagen promocional v0.9 aprobada ni una matriz completa real de aceptación de imágenes 9+3. No hace ninguna afirmación generalizada de calidad de imagen, rendimiento o VRAM. Usa los comandos de preparación anteriores para inspeccionar el entorno objetivo.
Documentación
- Arquitectura y modelo de errores
- Solución de problemas
- Compatibilidad de clientes
- Límite de demostración del protocolo
- Lista de verificación de lanzamiento
- Notas de integración de Stable Diffusion
- Contribuir
- Registro de cambios
Licencia
Publicado bajo la Licencia MIT. Los pesos de los modelos, las aplicaciones de backend y las salidas generadas conservan sus propias licencias y términos; ninguno es relicenciado por este repositorio.