Personal Understanding
Memoria de cadena de evidencia para agentes de IA: capturas inmutables con hash SHA-256 en primer lugar, auditables y antifabricación. Habilidad local primero y servidor MCP para Claude Code, Codex y cualquier cliente MCP.
Documentación
Personal Understanding
Una memoria que recuerda como tú — por cadenas de evidencia y asociación, no por puntuaciones de similitud.
Primero lo textual · Cadena de evidencia · Recuerdo asociativo · Anti-fabricación · Primero local · Una carpeta, cero dependencias



中文文档 · Cómo funciona el recuerdo · Inicio rápido · Principios de diseño
agent-memory mcp claude codex skills local-first associative-recall personal-knowledge
El problema con todos los sistemas de memoria que has probado
La memoria típica de un agente tiene un secreto sucio: el modelo resume primero y almacena el resumen. Tus palabras se parafrasean, comprimen y mezclan con las interpretaciones del propio modelo desde el primer día. Seis meses después, "tú" eres una pila de resúmenes con pérdida — y cuando el modelo se equivoca contigo, ni siquiera puedes auditar por qué, porque la evidencia original ha desaparecido.
Y la recuperación subyacente es similitud. Aquí está la parte que la mayoría de los productos de memoria no dicen en voz alta:
Recordar no es similitud. Cuando te quejas "este juego es una basura, los golpes no tienen peso", un humano que te conoce piensa: una vez dijo que su referencia para la sensación de juego era Red Dead Redemption 2, y The Witcher 3 perdió contra él. Cero palabras coinciden entre la queja y ese recuerdo — una puntuación de similitud le da cero, y el recuerdo que más necesitas es invisible. El recuerdo humano es direccional y asociativo: piensas en lo opuesto de una cosa, su razón, el mismo núcleo mental un nivel de abstracción más arriba. Eso no es lo que calcula una base de datos vectorial.
Personal Understanding arregla ambas mitades:
Guarda las palabras exactas primero. Recuerda por cadenas de evidencia y propagación en grafo, no por similitud. Prueba cada camino.
Cada mensaje personal se captura textualmente e inmutablemente (hash SHA-256, marca de tiempo, etiqueta de sesión) antes de que ocurra cualquier otra cosa. La comprensión estructurada se construye sobre la evidencia, cada hecho derivado enlaza de vuelta a la cita de la que proviene. Y el recuerdo pasa por una pila medida de tres capas que puede sacar a la superficie registros con cero solapamiento léxico — con el camino de asociación mostrado, para que el modelo pueda juzgarlo en lugar de confiar en una puntuación desnuda. Cuando el agente te recuerda mal, lo auditas. Cuando no sabe, lo dice.
Qué lo hace diferente
| Herramientas de memoria típicas | Personal Understanding | |
|---|---|---|
| Qué se almacena primero | el resumen del modelo | tus palabras exactas — inmutables, con hash |
| Modelo de recuerdo | similitud sobre resúmenes | tres canales léxicos + propagación asociativa en grafo, camino de evidencia visible |
| Hechos derivados trazables a la fuente | raramente | ✓ cada registro enlaza de vuelta a su texto verbatim |
| Las conjeturas del modelo marcadas como conjeturas | no | ✓ capa de hipótesis, candidate por defecto, nunca promovida silenciosamente |
| Resúmenes antiguos con pérdida | reutilizados silenciosamente | ✓ marcados como deuda de resumen — la recuperación revela "esta parte proviene de un resumen antiguo" |
| Dice "guardado" cuando el guardado falló | ocurre | ✗ imposible — una puerta dura (session_check) debe salir con 0 antes de que se pueda afirmar "archivo actualizado" |
| Fechas inventadas, personas fusionadas, aristas causales falsas | posible | ✗ prohibido por política escrita y aplicado por validadores |
| Tiempo de ejecución | servidor + base de datos vectorial + embeddings | una carpeta, solo stdlib de Python |
| Dónde viven tus datos | a menudo en su nube | tu máquina. Punto. |
Vélo funcionar — tus palabras entran, prueba sale
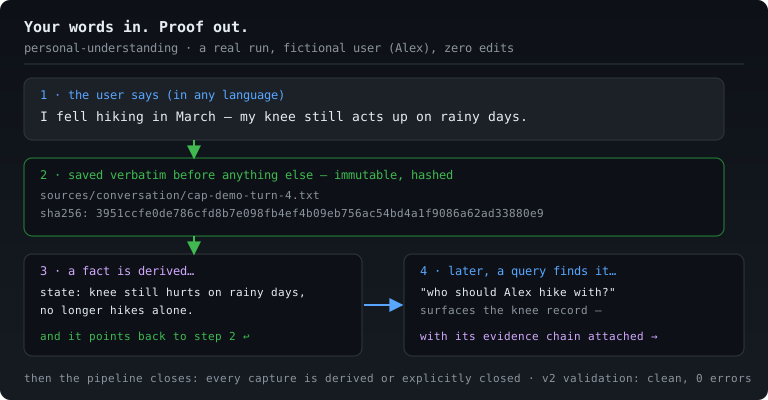
Una ejecución real del pipeline (usuario ficticio "Alex", salida CLI real, cero ediciones): llega un mensaje, se captura textualmente con su SHA-256, un hecho derivado enlaza de vuelta a esa cita exacta, y una consulta asociativa posterior lo saca a la superficie a través de la cadena de evidencia.
¿Por qué no usar simplemente la memoria integrada de tu agente?
Los agentes más nuevos ya incluyen "memoria" — si eso te basta, úsala. Este proyecto existe para las personas que chocan con sus límites:
| Memoria integrada del agente | Personal Understanding | |
|---|---|---|
| Propiedad de los datos | bloqueada en la cuenta del proveedor, raramente exportable, desaparece al cambiar de herramienta | una carpeta de texto plano en tu máquina — léela, haz grep, respáldala, muévela |
| Portabilidad | la memoria solo funciona dentro de ese producto | un archivo, cualquier cliente MCP — Claude, Codex, ZCode, VS Code, lo que venga después |
| Auditabilidad | caja negra — no puedes ver qué se almacenó, ni por qué respondió así | cada hecho derivado enlaza a la cita exacta; el rastro de recuperación muestra por qué apareció cada registro, y qué se retuvo deliberadamente |
| Recuperación | recuerdo difuso por resúmenes | tres canales + recuerdo asociativo que termina en tus palabras originales |
| Privacidad | tu historial personal en sus servidores | solo local — sin telemetría, sin llamadas a la nube |
La memoria del proveedor optimiza para una conversación más fluida dentro de su producto. Este proyecto optimiza para una memoria que tú posees, que se mueve contigo entre herramientas, y que puede probar de dónde vino cada hecho. Productos diferentes — que la memoria del proveedor mejore no hace que esta sea redundante.
Bajo el capó: cómo funciona realmente el recuerdo
La mayoría de los README de memoria se detienen en "usamos embeddings". Aquí está toda la pila, porque la mecánica es el producto.
Capa 0 — léxico autoentrenado (higiene de consultas). Cada consulta se tokeniza contra un diccionario incluido (jieba, MIT) más un léxico que el archivo entrena sobre sí mismo: cualquier cadena de 2 a 4 caracteres que aparezca en ≥2 textos del archivo se convierte en palabra, así los nombres propios que ningún diccionario general conoce (弦一郎, 艾迪芬奇, 晕3D) se reconocen automáticamente. Las porciones fuera de vocabulario conservan su recuerdo pero con tope de peso para que los accidentes entre palabras (郎我) ya no puedan superar a los términos reales. Causa raíz medida que esto arregló: la consulta 巫师3 se divide en 巫师 + 3, y un 3 suelto coincidía con fechas dentro de los IDs de registro — una vez le dio a un registro de licencia de conducir el primer puesto para una consulta sobre Witcher.
Capa 1 — recuerdo léxico de tres canales. Los eventos de línea de tiempo, las tarjetas de hechos/modelos y las tarjetas de entidades se puntúan por separado (ponderación IDF, normalización por longitud, democión de anclas) en lugar de una mezcla única — una queja sobre la sensación de juego llega a la tarjeta de hecho incluso cuando ningún evento coincide. Cada sonda registra un rastro de decisión: qué se seleccionó, qué se retuvo y por qué.
Capa 2 — propagación asociativa (el recuerdo que hacen los humanos). Las entidades y las tarjetas de concepto (sensación-de-juego, dinero-y-culpa, límites-del-cuerpo, gusto-lector…) forman un grafo. Una propagación PageRank personalizada — local, con tope de hubs para que los nodos populares no disfracen popularidad como asociación — saca a la superficie registros con los que la consulta comparte cero palabras, cada uno con su camino via visible:
- "los golpes de este juego se sienten como papel" →
concept: gameplay-feel→ el registro de anclaje de sensación Witcher-3-vs-RDR2 (sin palabra compartida — exactamente el recuerdo que haría un amigo) - "sequía de libros, recomiéndame algo" →
concept: reading-taste→ tu historial de lectura y tu ancla de gusto - "recomiéndame un juego" →
concept: narrative-games→ la regla dura de que el mareo por 3D es una exclusión a nivel corporal — el lado opuesto del deseo, a una arista de distancia
La pila se evalúa en una matriz de uso simulado de 16 rondas (consultas con tono de usuario real en 8 dominios de vida, calificadas por modelo); cada versión la re-ejecuta. Cero regresiones de recuerdo esperado hasta 2.6.0, mientras que los dos casos de "todos los canales fallaron" anteriores pasaron de nada a aparecer.
¿Por qué no embeddings? Son la herramienta correcta a escala de archivo, y el diseño deja un hueco para ellos. Pero a escala de archivo personal, los fallos medidos son léxicos y estructurales, no semánticos — y una puntuación de similitud no es auditable por naturaleza: devuelve un número, nunca un camino. Aquí, cuando un recuerdo aparece, por qué apareció siempre se muestra.
El mismo mensaje, dos recuerdos muy diferentes
Sin Personal Understanding — una implementación de memoria típica:
Tú: Hoy por fin toqué mi primera canción completa en la guitarra. Tres semanas hasta que la interprete en la boda de mi primo — honestamente menos nervioso que antes. IA: ¡Eso es genial, felicidades! 🎸 ¡Sigue así!
Lo que se almacenó:
"user played guitar, feeling positive."Un resumen con pérdida. Sin fuente, sin fecha, sin personas, sin forma de verificarlo. El mes que viene desaparece — o peor, se parafrasea silenciosamente en algo que nunca dijiste.
Con Personal Understanding — el mismo mensaje:
Tú: Hoy por fin toqué mi primera canción completa en la guitarra. Tres semanas hasta que la interprete en la boda de mi primo — honestamente menos nervioso que antes. IA: (primero: captura tu mensaje completo textualmente — con hash SHA-256, marca de tiempo, etiqueta de sesión — antes que cualquier otra cosa) (luego: deriva y enlaza —
event"primera canción completa en la guitarra" · salienciasupporting· enlazado aSaray al objetivo de la boda · actualiza tu estado actual: ansiedad por la actuación ↓) IA: La primera canción completa es un hito real. La última vez, actuar en la boda te ponía nervioso — ¿cómo te sientes ahora que faltan tres semanas?Cada afirmación se remonta a tus palabras exactas. Pregunta "¿de dónde sale eso?" y el agente te muestra la cita original — no una paráfrasis de una paráfrasis. Y cuando llega la semana de la boda, el archivo se pone en contacto por sí solo.
Destacados
- 🗣️ Captura primero lo textual — el mensaje completo, palabra por palabra, antes de cualquier resumen, división o interpretación. Las correcciones añaden nuevas capturas; nada se sobrescribe silenciosamente jamás.
- 🔁 Cierre de derivación — una captura exitosa no es una actualización terminada. Cada captura debe dividirse en registros, enlazarse y cerrarse — o cerrarse explícitamente como "nada nuevo" con una razón declarada. Los huérfanos no pueden colarse.
- 🧠 Recuerdo progresivo similar al humano —
survey(mapa de enrutamiento compacto) →probe(expansión a lo largo de entidades, tarjetas de concepto y vecinos temporales) →deep(verificar la cita exacta). Sin volcados vectoriales, sin búsqueda solo por palabras clave. - 🕸️ Recuerdo asociativo con caminos visibles — los recuerdos con cero solapamiento aparecen a través de un grafo de tarjetas de concepto con el camino de asociación adjunto; el modelo juzga el enlace, nada llega como una puntuación inexplicada.
- 📻 Escalera de recuerdo en frío — para momentos de "no recuerdo, hablamos de algo así…": sondea desde cualquier pista, camina por vecinos temporales, luego navega una ventana de tiempo como hojeando un álbum de fotos antiguo.
- 🔬 Capa de hipótesis causales — "¿por qué soy así?" obtiene una respuesta estructurada: afirmación, mecanismo, apoyos, contraejemplos, explicaciones competidoras, alcance, confianza — siempre
candidate, nunca presentada como hecho. - ⏰ Seguimientos proactivos — "veamos en unos días" se convierte en un bucle rastreado. Cuando vence, el agente vuelve con el contexto original, no con un recordatorio sin contexto.
- 🚦 Puertas duras, no vibraciones — validación de tres estados (
clean/warnings/failed), escrituras atómicas en todas partes,session_checkcomo puerta de salida no cero antes de cualquier afirmación de "el archivo está actualizado". Las lecturas que no pueden corromper el archivo tienen un camino degradado auditado; las escrituras nunca. - 📉 Contabilidad de deuda de resumen — el material heredado que perdió su fuente se etiqueta, se cuenta y se revela en la recuperación. Nunca puede hacerse pasar por texto verbatim.
- 📊 Línea de tiempo del pipeline y panel de auditoría — reproduce la vida completa de un turno (decisión de puerta → captura → cierre → cada consulta de recuperación, asociación y candidato retenido) como una sola página de solo lectura, o navega el panel completo.
- 🔌 Plug-and-play para tu cliente — un instalador idempotente detecta y registra automáticamente un servidor MCP local en clientes Claude, Codex, VS Code / Cursor / Windsurf / Cline / Trae, ZCode y configuraciones genéricas de
.agents. - 💾 Copias de seguridad con integridad — instantáneas con manifiesto SHA-256, soporte para espejo en segunda ubicación (cualquier remoto rclone), y una revisión de saliencia trimestral que degrada elegantemente los pesos importados obsoletos en lugar de dejar que se fosilicen.
Arquitectura
flowchart LR
    A["user message"] --> B{"turn preflight<br/>(router)"}
    B -->|"personal content"| C["immutable verbatim capture<br/>+ SHA-256 · session · source"]
    C --> D["derivation ledger<br/>(pending)"]
    D --> E["derive: events · entities · concept cards<br/>context cards · hypotheses · follow-ups"]
    E --> F["finalize:<br/>derived / nothing-new"]
    B --> G["probe: lexicon-hygiened query"]
    G --> H["three-channel lexical recall<br/>timeline · cards · entities"]
    G --> I["associative spread (PPR)<br/>zero-overlap candidates + via path"]
    H --> J["deep = verbatim only<br/>(summary debt disclosed)"]
    F --> K["session_check<br/>hard gate · must exit 0"]
    I --> K
    J --> K
    K --> L["answer"]
    L --> M["feedback loop<br/>helpful / missed / corrected"]
    M -.->|quarterly| N["salience review<br/>+ deep semantic review"]
En disco son archivos planos que puedes leer, buscar con grep y respaldar: sources/conversation/ (verbatim inmutable + hashes) y memory/v2/ (fragmentos, línea de tiempo, entidades, tarjetas de conceptos, contextos, seguimientos, hipótesis, trazas de decisiones) — con registros heredados mantenidos como capa de compatibilidad y marcados honestamente como summary_only.
Inicio rápido
# 1. clone into your client's skills directory
git clone https://github.com/caix84476-netizen/personal-understanding.git \
    ~/.claude/skills/personal-understanding      # or ~/.codex/skills/ , or your client's equivalent

# 2. bootstrap the archive skeleton (directories + generic domain branches; idempotent)
python scripts/init_archive.py

# 3. register the local MCP server (auto-detects clients; idempotent)
python scripts/install_mcp.py --auto            # Windows: just double-click register-mcp.cmd

# 4. restart your client session — the personal_* tools go live

# 5. open the audit dashboard / replay any turn's pipeline any time
python scripts/open_dashboard.py                # Windows: double-click open-dashboard.cmd
python scripts/pipeline_view.py --latest 5
Requisitos: Python 3.10+ · solo biblioteca estándar, cero instalaciones con pip · Windows / macOS / Linux.
¿Prefieres pip? El servidor MCP + el instalador también están en PyPI: pip install personal-understanding, luego personal-understanding-install para registrar el servidor MCP local. El paquete pip incluye solo la parte de Python — para el cerebro completo de la habilidad (SKILL.md + panel), usa los pasos de clonación anteriores. A partir de 2.2.1, el wheel ya no es una instantánea obsoleta — cada archivo empaquetado es byte-idéntico al árbol fuente, verificado de nuevo en cada lanzamiento. Queda una advertencia: personal-understanding-install registra el servidor pero no inicializa una raíz de archivo, así que empieza desde cero con python -m personal_understanding.init_archive. Los pasos de clonación anteriores siguen siendo la ruta recomendada para la habilidad completa.
Luego simplemente habla con normalidad: "Me he sentido…", "recuerda que…", "¿por qué sigo…?" — la descripción de la habilidad se activa con contenido personal, captura tus palabras y toma el control desde ahí. Pregunta "¿qué recuerdas sobre…?", o "¿de dónde viene eso?" y sigue la cadena de evidencia.
Tus datos siguen siendo tuyos
- Todo se procesa localmente, en la carpeta de la habilidad. Sin telemetría, sin llamadas a la nube, sin embeddings enviados a terceros.
- El
.gitignoreincluido bloqueamemory/,sources/ybackups/— para que puedas controlar versiones de tu carpeta de habilidad y nunca comprometer tu archivo privado por accidente. - Las etiquetas de sensibilidad (
private/highly-private) controlan la relevancia, no el secreto para ti: preguntas no relacionadas nunca filtran material privado no relacionado.
Principios de diseño
Estas son políticas escritas, aplicadas por validadores — no aspiraciones:
- Fidelidad verbatim primero — ningún resumen se hace pasar por las palabras del usuario;
summary_onlyse marca como tal para siempre. - La recuperación debe ser auditable — la similitud sola nunca decide; los candidatos asociativos llevan su ruta de grafo, y cada sonda registra lo que se seleccionó y lo que se retuvo deliberadamente.
- Sin certeza fabricada — las fechas inciertas siguen siendo inciertas; los pronombres vagos no se convierten en personas; los eventos únicos nunca se convierten en causas; los bordes de asociación son semántica declarada, nunca inventados para un grafo más bonito.
- Las palabras más nuevas superan a los archivos antiguos — las correcciones construyen cadenas
supersedes/contradicts; nada se borra silenciosamente. - Un solo eje de saliencia —
pivotal / key / supporting / passingen una escala única de 0–3; los pesos importados admiten que son heurísticas. - El silencio no es retroalimentación — solo correcciones y confirmaciones explícitas, con evidencia citable, alimentan el bucle de retroalimentación.
- Estructura limpia ≠ semánticamente correcto — la revisión profunda existe precisamente porque los validadores no pueden captar el significado.
De dónde viene
No es un marco pensado en una tarde — un archivo de trabajo refinado mediante uso diario y una docena de rondas de endurecimiento (ver el CHANGELOG): un error de decaimiento de saliencia que una vez destrozó el frontmatter es por lo que todas las escrituras ahora son atómicas y revisadas; la encuesta solía cargar ~818 KB de catálogo heredado por turno — ahora es un mapa de enrutamiento de ~90 KB (~230 ms); la capa asociativa existe porque su autor seguía chocando con el muro de que "la recuperación no es similitud" — el changelog de 2.6.0 documenta las causas raíz medidas, los diseños probados y rechazados, y la regresión que demostró que la eliminación era incorrecta antes de elegir la degradación.
Estado
- Versión actual: v2.8.0 — versión de adelgazamiento: SKILL.md 44KB→20KB contrato central con referencias indexadas bajo demanda, herramientas MCP 13→11 (derivation_status absorbido en validate, add_hypothesis absorbido en add_record kind=causal_hypothesis; ambos mantienen punteros de migración), session_check modo ligero por defecto (puerta de turno en ms, validación completa de biblioteca vía light=false). Esquema estable; contratos de comportamiento sin cambios.: las escrituras ya no reconstruyen en línea (isError responde exactamente "¿aterrizó esta escritura?", las vistas se reconstruyen perezosamente en lectura), vistas/recuperaciones limitadas con metadatos de truncamiento deterministas, guardia de volteo finalize + visibilidad pendiente, paridad de esquema en la ruta de escritura con el auditor, gobernanza de sesión obsoleta, y tres defectos reales capturados por los nuevos documentos de aceptación (bloqueo de reconstrucción en ruta de lectura, ingestión de stale_days=0 falso, cortocircuito de degradación de puerta de estructura). Esquema estable (
memory/v2/v2.0.0); mantenido activamente. También en PyPI. - Funciona con cualquier cliente compatible con MCP. El cerebro de la habilidad (
SKILL.md) está escrito en chino y funciona con archivos en cualquier idioma; la recuperación está optimizada para texto mixto chino/latino y degrada con gracia en otros casos. - Hoja de ruta: páginas de panel editables, clasificación de recuperación en frío más rica, canal lateral vectorial opcional para archivos muy grandes (conectable por diseño), archivo cifrado en reposo opcional.
Contribuciones
Se aceptan issues y PRs — especialmente: instaladores de nuevos clientes para install_mcp.py, mejoras del panel y matrices de evaluación para idiomas más allá del chino.
Licencia
MIT © 2026 caix84476-netizen
Si Personal Understanding te ahorra tener que reexplicarte a tu IA por enésima vez, una estrella ⭐ ayuda a otros a encontrarlo.