Telebrief
Resúmenes autohospedados de tus canales de Telegram a través de MCP: resúmenes con IA, el último resumen y mensajes crudos por canal, con OpenAI, Anthropic u Ollama.
Documentación
Telebrief
Generador Automático de Resúmenes de Telegram impulsado por IA



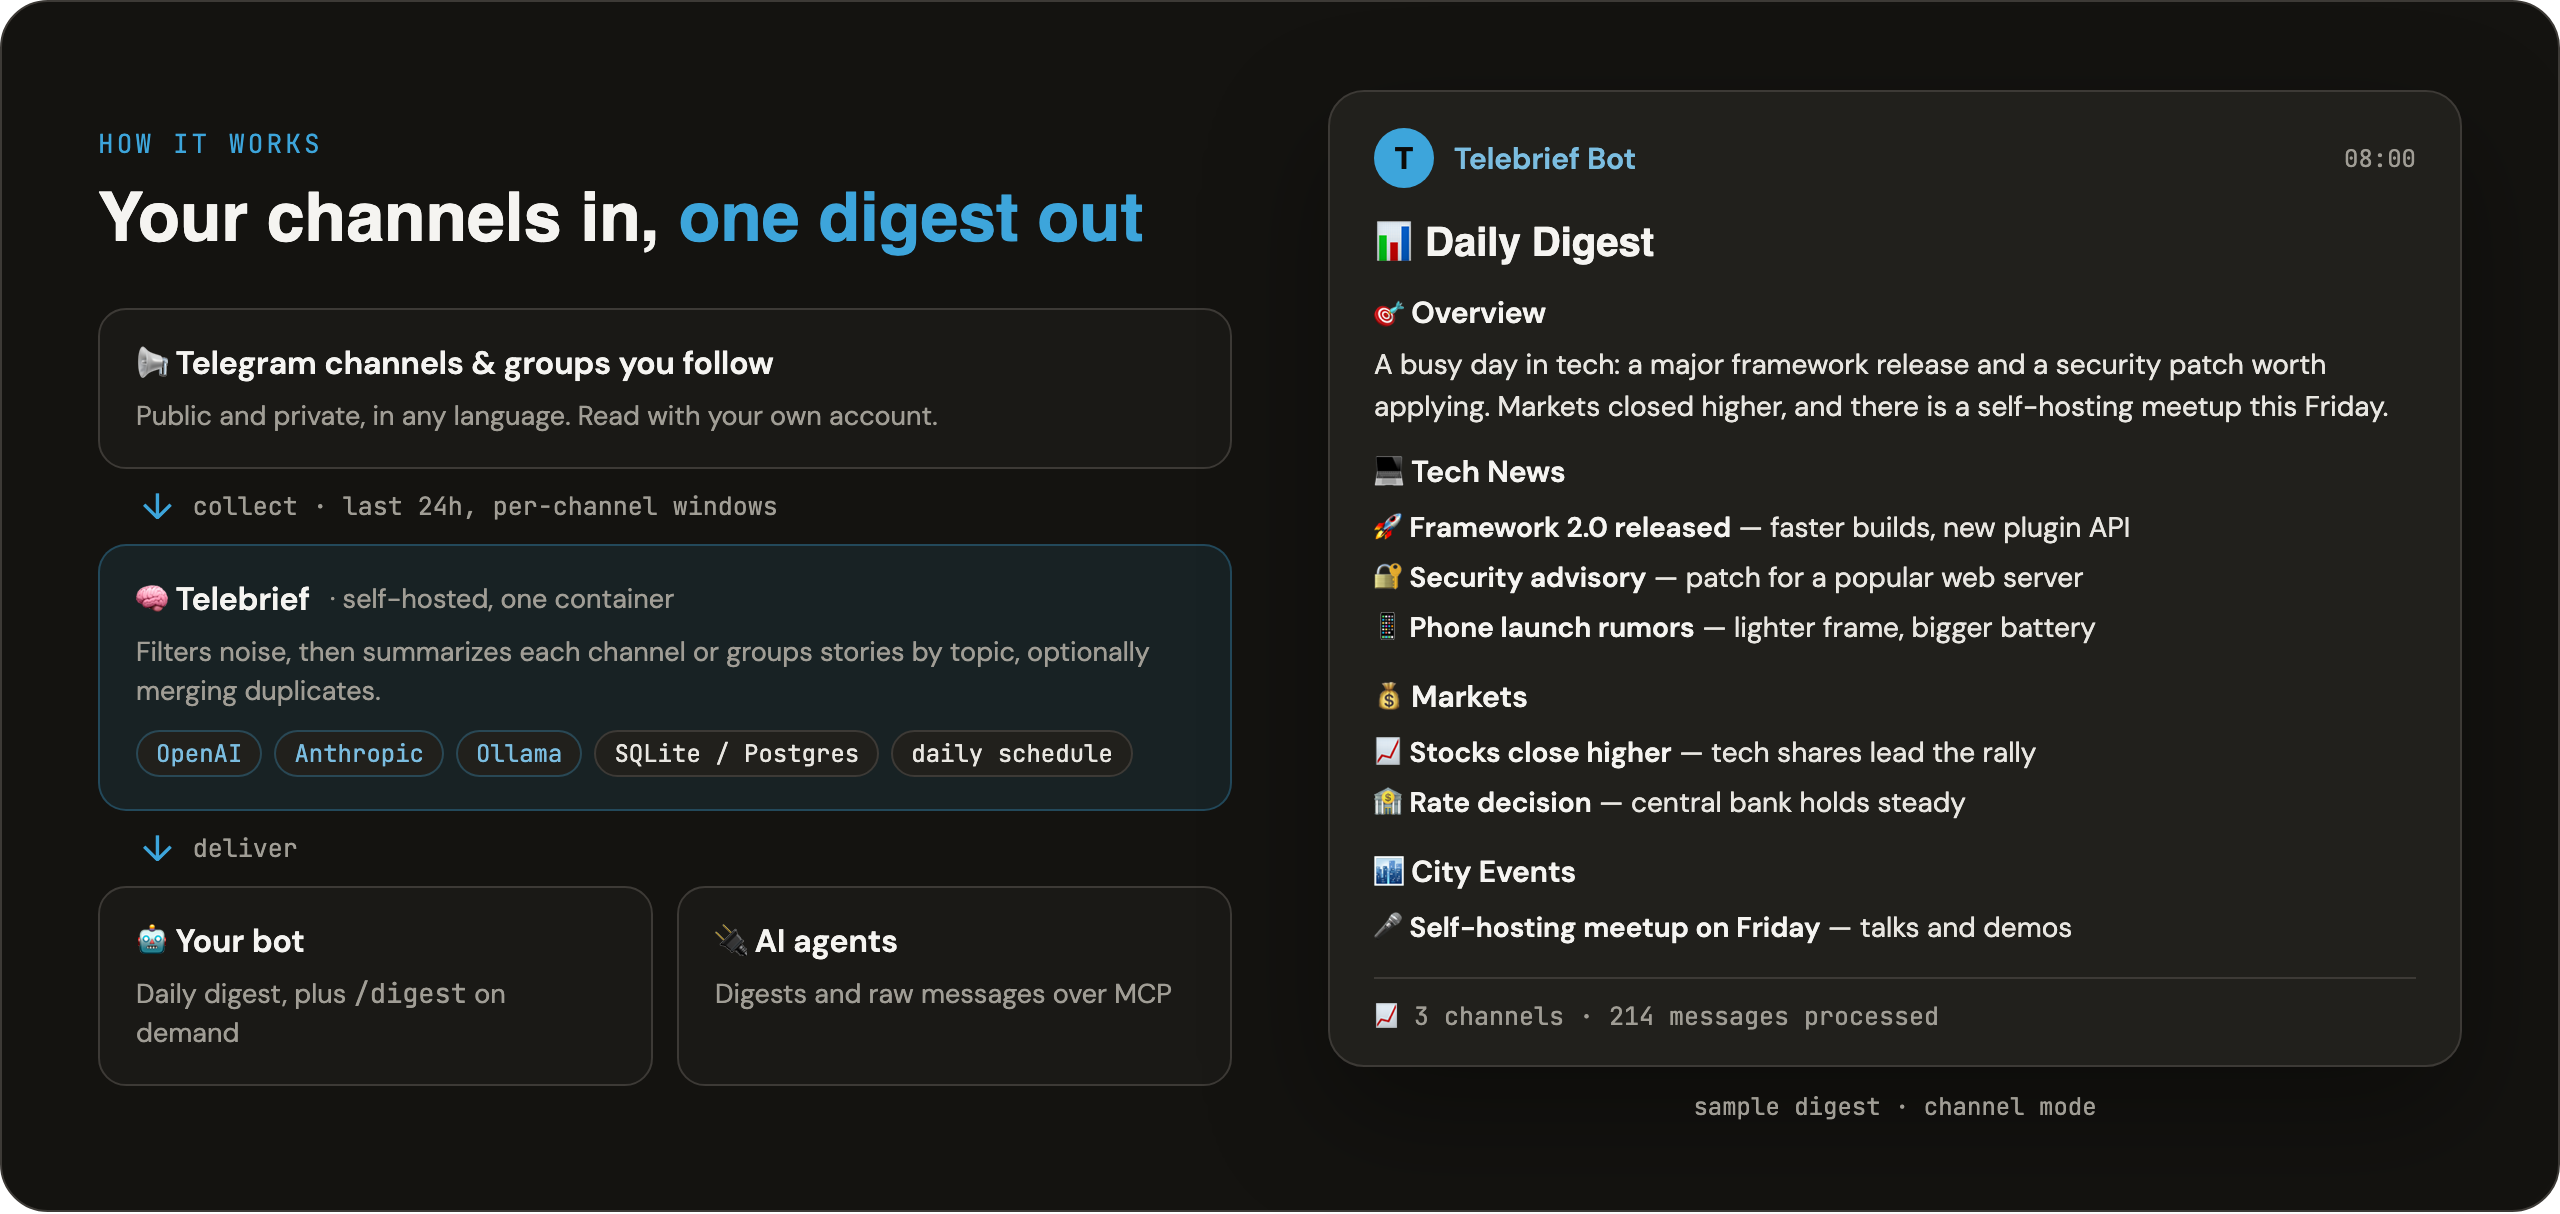
Telebrief recopila mensajes de tus canales de Telegram (en cualquier idioma), genera resúmenes impulsados por IA y entrega un resumen diario a través de tu propio bot de Telegram. Agrupa los resúmenes por canal o por temas detectados por IA. Compatible con múltiples proveedores de IA: OpenAI, Ollama (local) y Anthropic. Los resúmenes están disponibles en inglés, ruso, español, alemán o francés (predeterminado: ruso).
📑 Contenido
- Características
- Requisitos previos
- Inicio rápido
- Comandos del bot
- Ejemplo de salida — modo canal, modo tema, deduplicación
- Configuración por canal — ventana de retroceso, instrucciones de IA
- Almacenamiento persistente — SQLite, PostgreSQL, esquema
- Extensibilidad — filtros, prompts, vinculación de grupos, consultas de almacenamiento
- Servidor MCP — habilitación, modo stdio, herramientas, canal único, seguridad
- Desarrollo y pruebas
- Preguntas frecuentes
- Contribuciones · Licencia · Créditos
✨ Características
- 🌐 Compatibilidad multilingüe - Lee canales en CUALQUIER idioma (inglés, ruso, ucraniano, chino, etc.)
- 🌍 Idioma de salida configurable - Resúmenes, etiquetas y mensajes del bot en inglés, ruso, español, alemán o francés (predeterminado: ruso)
- 🤖 IA multiproveedor - Compatible con OpenAI (incluidos GPT-6 Luna, Sol, Astra), Ollama (local) y Anthropic para la generación de resúmenes
- ⏰ Programado y bajo demanda - Resúmenes automáticos diarios + generación instantánea mediante comandos del bot
- 🔒 Compatibilidad con canales privados - Accede a tus chats y canales privados
- 📑 Modos de resumen - Agrupa por canal (predeterminado) o por temas detectados por IA como Noticias, Eventos, Deportes
- 🎨 Formato inteligente - Markdown con emojis, viñetas y enlaces clicables a canales
- 📨 División de mensajes largos - Los resúmenes que superan el límite de 4096 caracteres de Telegram se dividen automáticamente en mensajes secuenciales en lugar de truncarse
- 🔐 Autoalojado - Para un solo usuario; tu sesión, claves API y mensajes permanecen en tu servidor
- 🧹 Limpieza automática - Elimina automáticamente mensajes de resumen antiguos
- 🔌 Servidor MCP - Endpoint MCP integrado opcional para que los agentes de IA puedan obtener resúmenes en lugar de leer Telegram
📋 Requisitos previos
Antes de comenzar, necesitarás:
-
Docker - Instalar Docker
-
Credenciales de la aplicación de Telegram - Obtener en my.telegram.org
api_idyapi_hash- Si el formulario en my.telegram.org/apps solo muestra
ERROR, el rechazo proviene de Telegram, no de Telebrief. Soluciones que suelen ayudar:- Usa un título de aplicación y nombre corto alfanuméricos únicos y aleatorios (nombre corto: 5–32 letras/dígitos, sin espacios)
- Desactiva VPN, proxy y extensiones de bloqueo de anuncios; prueba una ventana privada u otro navegador
- Cambia de red, por ejemplo, datos móviles en lugar de Wi-Fi
- Envía de nuevo varias veces; la verificación es intermitente
- Si nada funciona, contacta con el soporte de Telegram. Nunca introduzcas tu código de inicio de sesión en sitios de terceros que ofrezcan crear una aplicación por ti.
-
Token del bot de Telegram - Crea mediante @BotFather
- Envía
/newbotpara crear un nuevo bot - Guarda el token del bot
- Envía
-
Clave API del proveedor de IA (una de las siguientes):
- OpenAI: Obtener en platform.openai.com
- Anthropic: Obtener en console.anthropic.com
- Ollama: No se necesita clave API - instalar localmente
🚀 Inicio rápido
No se necesita clonar ni Python. En un directorio vacío, ejecuta el asistente de configuración:
mkdir telebrief && cd telebrief
docker run --rm -it --user "$(id -u):$(id -g)" -v "$PWD":/setup \
  ghcr.io/belaytzev/telebrief python main.py init /setup
El asistente inicia sesión en tu cuenta de Telegram (teléfono, código, 2FA), verifica el token del bot, te permite elegir canales de tus diálogos por número y escribe .env, config.yaml, docker-compose.yml y sessions/user.session. Tu ID de usuario se toma del inicio de sesión.
Luego presiona Iniciar en el chat de tu bot y lanza el servicio:
docker compose up -d
docker compose logs -f telebrief
Envía /digest al bot para obtener el primer resumen de inmediato. Vuelve a ejecutar el asistente en cualquier momento: reutiliza la sesión existente y pregunta antes de sobrescribir archivos.
Para actualizar a la última versión:
docker compose pull && docker compose up -d
Las imágenes se publican en GitHub Container Registry en cada versión con etiquetas latest, X.Y (menor), X.Y.Z (parche). Para compilar desde el código fuente, reemplaza la línea image: en docker-compose.yml con build: .. Para todas las opciones más allá del asistente, consulta config.yaml.example.
🤖 Comandos del bot
Abre Telegram y envía un mensaje a tu bot:
| Comando | Descripción |
|---|---|
/start | Igual que /help |
/help | Muestra el mensaje de ayuda con todos los comandos |
/digest | Genera y envía el resumen de las últimas 24 horas (usa el digest_mode configurado) |
/status | Muestra el proveedor y modelo de IA, número de canales, limpieza automática y la próxima ejecución programada |
/cleanup | Elimina manualmente mensajes de resumen antiguos |
📊 Ejemplo de salida
Telebrief admite dos modos de resumen configurados mediante digest_mode en config.yaml.
Modo canal (digest_mode: "channel" — predeterminado)
Agrupa los resúmenes por canal de origen con enlaces clicables a los canales:
# 📊 Daily Digest - 02 May 2026

## 🎯 Brief Overview

A busy day in tech: a major framework release and a security patch worth
applying. Markets closed higher, and there is a self-hosting meetup this Friday.

---

## 💻 Tech News · [Open channel →](https://t.me/technews)

- 🚀 **Framework 2.0 released**: faster builds, new plugin API
- 🔐 **Security advisory**: patch for a popular web server

## 💰 Markets · [Open channel →](https://t.me/markets)

- 📈 **Stocks close higher**: tech shares lead the rally
- 🏦 **Rate decision**: central bank holds steady

---
📈 **Statistics**: 3 channels, 214 messages processed
La disposición de las viñetas de cada canal proviene de la IA, guiada por el prompt, por lo que varía ligeramente entre proveedores y modelos.
Modo tema (digest_mode: "digest")
Agrupa los resúmenes por temas detectados por IA. Defines los grupos de temas en config.yaml:
digest_mode: "digest"
digest_groups:
  - name: "Events"
    description: "Conferences, meetups, releases, launches, announcements"
  - name: "News"
    description: "Politics, economy, world affairs, breaking news"
  - name: "Sport"
    description: "Sports results, transfers, tournaments, matches"
Los mensajes que no coinciden con ningún grupo definido se colocan en una categoría automática "Otros".
Todas las etiquetas (encabezado, estadísticas, comandos del bot) siguen el
output_languageconfigurado. El ejemplo anterior usaEnglish; los otros valores compatibles sonRussian(predeterminado),Spanish,GermanyFrench.
dedup_topics — deduplicación entre canales
Cuando varios canales cubren el mismo evento, el agrupador normalmente produce una viñeta por canal. Habilita dedup_topics para indicar a la IA que conserve solo la descripción más informativa y fusione las atribuciones de origen:
settings:
  digest_mode: "digest"
  dedup_topics: true        # default: false
  digest_groups:
    - name: "Tech"
      description: "Technology news and releases"
Con la deduplicación habilitada, si TechCrunch y HackerNews informan ambos sobre el mismo lanzamiento de producto, el resumen contendrá una sola viñeta con source: "TechCrunch, HackerNews" en lugar de dos entradas separadas.
Nota:
dedup_topicsno tiene efecto endigest_mode: "channel"— la deduplicación solo se aplica durante la agrupación por temas.
⚙️ Configuración por canal
Cada entrada de canal admite dos anulaciones opcionales además de los campos obligatorios id y name.
lookback_hours — ventana de retroceso por canal
Anula el settings.lookback_hours global para un canal específico. Útil cuando algunos canales publican con poca frecuencia y necesitan una ventana de recopilación más amplia, o cuando deseas una ventana más ajustada para canales de alto volumen.
channels:
  - id: "@breaking_news"
    name: "Breaking News"
    # no lookback_hours — uses the global settings.lookback_hours

  - id: "@weekly_digest"
    name: "Weekly Newsletter"
    lookback_hours: 168   # look back 7 days for this channel only

  - id: -1001234567890
    name: "High Volume Channel"
    lookback_hours: 6     # only last 6 hours for this channel
lookback_hours debe ser un entero positivo. Si se omite o se establece en null, se usa el valor global.
prompt_extra — instrucciones de IA por canal
Añade instrucciones adicionales al prompt del sistema de IA al resumir un canal específico. Úsalo para guiar el tono, el enfoque o el formato de canales que necesitan un tratamiento especial.
channels:
  - id: "@cryptonews"
    name: "Crypto News"
    prompt_extra: "Focus only on price movements and regulatory news. Ignore opinion pieces."

  - id: "@jobboard"
    name: "Job Board"
    prompt_extra: "Extract only senior engineering roles. Format as a list: Role — Company — Link."
prompt_extra se añade textualmente al prompt del sistema de resumen del canal. Déjalo vacío (u omite el campo) para el comportamiento estándar.
🗄️ Almacenamiento persistente
De forma predeterminada, Telebrief genera resúmenes bajo demanda sin almacenar mensajes sin procesar. Puedes habilitar una capa de almacenamiento persistente que guarde cada mensaje recopilado en una base de datos para acceso histórico o flujos de trabajo externos con LLM.
El almacenamiento está deshabilitado de forma predeterminada y es opcional mediante config.yaml.
SQLite (backend predeterminado)
No se requiere configuración adicional. Los mensajes se guardan en un archivo SQLite local.
storage:
  enabled: true
  backend: sqlite
  path: data/messages.db   # relative to project root
Cuando se ejecuta en Docker, el directorio data/ ya está montado como volumen en docker-compose.yml, por lo que la base de datos persiste entre reinicios del contenedor.
PostgreSQL (backend opcional)
Usa PostgreSQL para implementaciones de múltiples hosts o cuando necesites acceso de lectura concurrente al almacén de mensajes.
storage:
  enabled: true
  backend: postgres
  url: "postgresql://user:pass@host:5432/dbname"
asyncpg se incluye en la imagen de Docker y en las dependencias estándar (uv sync), por lo que no se necesita ningún paso de instalación adicional.
Esquema
Ambos backends crean el mismo esquema lógico en la primera ejecución (la tabla y el índice se crean automáticamente, sin necesidad de migración manual):
| Columna | Tipo | Descripción |
|---|---|---|
channel_name | text | Nombre del canal de tu configuración |
sender | text | Autor del mensaje |
text | text | Cuerpo del mensaje |
timestamp | text / timestamptz | Marca de tiempo del mensaje |
link | text | Enlace al mensaje de Telegram |
has_media | bool / integer | Si el mensaje tiene medios |
media_type | text | Cadena del tipo de medio |
collected_at | text / timestamptz | Cuándo se insertó la fila |
Nota: El almacenamiento es de solo añadido. Las ventanas lookback_hours superpuestas entre ejecuciones producirán filas duplicadas para mensajes recopilados en ambas ventanas.
🔌 Extensibilidad
Telebrief expone cuatro superficies de enganche que te permiten personalizar el comportamiento mediante config.yaml sin modificar la lógica central. Todos los campos nuevos son opcionales: las configuraciones existentes se ejecutan sin cambios.
Filtros
Una cadena de filtros se ejecuta después de la recopilación de mensajes y antes del almacenamiento y la generación de resúmenes. Los mensajes descartados nunca llegan a la IA ni a la base de datos.
Los filtros integrados se encuentran en src/extensions/filters.py:
| Filtro | Propósito |
|---|---|
KeywordFilter | Conservar/descartar mensajes por subcadena de palabra clave (sin distinción de mayúsculas) |
RegexFilter | Conservar o descartar mensajes que coincidan con un patrón regex |
MinLengthFilter | Descartar mensajes más cortos que un umbral de caracteres |
Configura una cadena de filtros global bajo settings.filters. Cada entrada necesita un class_path (ruta de importación con puntos) y un dict config opcional pasado como argumentos de palabra clave al constructor:
settings:
  filters:
    - class_path: src.extensions.filters.KeywordFilter
      config:
        include: ["job", "hiring", "remote"]
        exclude: ["nsfw"]
    - class_path: src.extensions.filters.MinLengthFilter
      config:
        min_chars: 30
Anula la cadena global para un solo canal añadiendo filters: bajo esa entrada de canal. Establece filters: [] para deshabilitar el filtrado por completo para ese canal, o proporciona una lista diferente para reemplazar la cadena global solo para ese canal:
channels:
  - id: "@jobboard"
    name: "Job Board"
    filters:
      - class_path: src.extensions.filters.RegexFilter
        config:
          pattern: "senior|staff|principal"
          mode: "include"
Escribe tu propio filtro implementando el Protocolo MessageFilter:
from __future__ import annotations
from src.extensions.filters import MessageFilter
from src.config_loader import ChannelConfig
from src.collector import Message

class MyFilter:
    name = "my_filter"

    def __init__(self, custom_param: str = "") -> None:
        self.custom_param = custom_param

    async def filter(self, channel: ChannelConfig, messages: list[Message]) -> list[Message]:
        return [m for m in messages if self.custom_param in (m.text or "")]
Luego haz referencia a él en config.yaml:
settings:
  filters:
    - class_path: mypackage.mymodule.MyFilter
      config:
        custom_param: "important"
Prompts
La plantilla base del prompt se encuentra en src/prompts/base_summary.txt. Puedes apuntar a un archivo de plantilla personalizado o conectar una clase PromptComposer personalizada.
prompts:
  base_template: src/prompts/base_summary.txt  # path to template file
  composer: ""                                  # empty = built-in DefaultComposer
El DefaultComposer integrado ensambla el prompt final del sistema en este orden (las partes vacías se omiten):
base template (with {language} substituted)
  + group.prompt_extra  (if channel belongs to a group with prompt_extra set)
  + channel.prompt_extra  (if non-empty)
Para usar un compositor personalizado, implementa el Protocolo PromptComposer y establece composer en su ruta con puntos:
from src.config_loader import ChannelConfig, DigestGroupConfig
from src.extensions.prompts import PromptComposer

class MyComposer:
    def __init__(self, base_template: str, language: str) -> None:
        self._base = base_template
        self._language = language

    def compose(self, channel: ChannelConfig, group: DigestGroupConfig | None) -> str:
        return f"{self._base}\nRespond in {self._language}."
Nota: El constructor debe aceptar
(base_template: str, language: str)como sus dos primeros argumentos posicionales. Una firma no coincidente genera unTypeErroral inicio con un mensaje descriptivo.
prompts:
  composer: mypackage.mymodule.MyComposer
Vinculación de grupos
Los canales pueden vincularse a una entrada digest_groups. El prompt_extra del grupo se inyecta entonces en cada canal de ese grupo, antes del prompt_extra propio del canal.
settings:
  digest_groups:
    - name: "Jobs"
      description: "Job listings and hiring announcements"
      prompt_extra: "Extract only role title, company, and link. Format as a list."

channels:
  - id: "@techleads_jobs"
    name: "Tech Jobs"
    group: Jobs          # must match a digest_groups name or "Other"
    prompt_extra: "Focus on senior and staff-level positions only."
Los canales sin un campo group (o group: null) usan la plantilla base y solo su propio prompt_extra.
Consultas de almacenamiento
Cuando el almacenamiento está habilitado (storage.enabled: true), el StorageBackend expone una API de lectura query_messages para herramientas externas:
from src.storage import SQLiteBackend
from datetime import datetime, timezone

backend = SQLiteBackend("data/messages.db")
await backend.initialize()

messages = await backend.query_messages(
    channel_name="TechCrunch",  # the configured channels[*].name (NOT the @id)
    since=datetime(2026, 4, 1, tzinfo=timezone.utc),
    until=datetime(2026, 4, 30, tzinfo=timezone.utc),
    limit=500,
)
Todos los parámetros son opcionales. channel_name coincide con el valor channels[*].name legible de config.yaml (este es el valor persistido en la columna channel_name en el momento de la recopilación); omítelo para consultar todos los canales. Renombrar un canal en la configuración cambiará el valor almacenado para las filas nuevas; las filas históricas conservan el nombre anterior. Los resultados se ordenan por marca de tiempo descendente y se limitan a limit (por defecto 1000, debe ser ≥ 1).
🔗 Servidor MCP
Telebrief puede exponer sus resúmenes a través del Protocolo de Contexto de Modelo, de modo que un cliente MCP (Claude Code, por ejemplo) pueda solicitar un resumen directamente en lugar de leerlo en Telegram.
El servidor se ejecuta dentro del proceso de Telebrief, compartiendo su sesión de Telegram, configuración y bloqueo de generación con el programador y el bot. Los resúmenes que devuelve son byte por byte lo que Telegram recibe, incluida la agrupación por temas y la deduplicación.
Cómo habilitarlo
mcp:
  enabled: true
  host: "127.0.0.1"
  port: 8765
  path: "/mcp"
Luego regístralo con tu cliente:
claude mcp add --transport http telebrief http://127.0.0.1:8765/mcp
Modo stdio
python main.py mcp sirve las mismas herramientas a través de stdio sin el bot ni el programador, para clientes que inician el servidor ellos mismos. Lee el mismo config.yaml, .env y sesión, y se conecta a Telegram solo cuando se llama a una herramienta. No lo ejecutes junto al servicio principal en el mismo archivo de sesión: prefiere el endpoint HTTP anterior cuando Telebrief ya está en ejecución.
Herramientas
| Herramienta | Argumentos | Comportamiento |
|---|---|---|
get_digest | hours (1–168, por defecto 24) | Genera un resumen nuevo. Tarda de 20 a 90 segundos y consume tokens del proveedor de IA. |
get_last_digest | — | Devuelve el resumen más reciente de la caché, con su hora de generación. Instantáneo y gratuito. |
get_channel_messages | channel, hours (1–168, por defecto 24), limit (1–500, por defecto 200) | Devuelve los mensajes individuales de un canal, sin resumir. No gasta tokens de IA. |
Cada resumen exitoso — programado, activado por el bot o activado por MCP — se guarda en caché en data/last_digest.json, de modo que get_last_digest sirve el mismo resumen que se entregó a Telegram.
La generación de resúmenes está serializada: si el programador ya está construyendo un resumen, una llamada MCP espera a que termine en lugar de abrir una segunda sesión de Telegram.
Lectura de un solo canal
get_channel_messages responde "qué se publicó realmente en este canal", en contraposición al resumen de IA que ofrece un digest.
channel acepta cualquiera de las dos formas de config.yaml — el channels[*].name legible o el channels[*].id (@username o numérico) — con coincidencia sin distinción de mayúsculas. Un valor desconocido falla con la lista de nombres de canales configurados, por lo que no se necesita una llamada de descubrimiento separada.
La herramienta lee del almacenamiento persistente cuando está habilitado y contiene mensajes para la ventana solicitada, y recurre a una lectura en vivo de Telegram en caso contrario. El encabezado de la respuesta indica qué ruta se utilizó:
channel: AI News (from storage, 42 msgs, last 24h)

[2026-08-07T09:12:04+00:00] Alice
OpenAI released a new model...
https://t.me/ainews/1234

[2026-08-07T10:30:11+00:00] Bob
[photo] Benchmark chart
https://t.me/ainews/1235
Los mensajes llegan en orden cronológico; limit conserva los más recientes y descarta los más antiguos. La alternativa en vivo se ejecuta bajo el mismo bloqueo de generación que los resúmenes y aplica los filtros configurados del canal, de modo que ambas rutas devuelven el mismo conjunto de mensajes.
Dos diferencias deliberadas con respecto a la generación de resúmenes:
channels[*].lookback_hoursno se aplica — la herramienta respeta elhoursque el llamador solicitó.- Los mensajes de solo medios llegan como su texto de marcador de posición (
[photo],[video]), exactamente como se almacenan.
Seguridad
El servidor MCP no tiene autenticación. Depende de la vinculación a loopback, donde el SDK también habilita la protección contra el rebinding de DNS. Cualquiera que pueda alcanzar el puerto puede activar la generación de resúmenes y leer tus resúmenes de canal.
Mantén host en 127.0.0.1. Telebrief registra una advertencia al inicio si vinculas a cualquier otro lugar. En Docker, publica el puerto como 127.0.0.1:8765:8765 en lugar de exponerlo en todas las interfaces, y colócalo detrás de un firewall o proxy inverso con autenticación si realmente necesitas acceso remoto.
🛠️ Desarrollo y pruebas
Este proyecto usa uv y Python 3.14+. La configuración, el conjunto completo de verificaciones, el estilo de código y el proceso de PR están en la Guía de contribución.
Ejecutar pruebas
uv sync --extra dev
uv run pytest tests/ -v
uv run mypy src/
❓ Preguntas frecuentes
P: ¿Qué idiomas de salida se admiten?
R: Inglés, ruso (predeterminado), español, alemán y francés, configurados mediante output_language. Los canales en sí pueden estar en cualquier idioma.
P: ¿Cuántos canales puedo monitorear?
R: No hay un límite estricto. Cada resumen lee hasta max_messages_per_channel mensajes por canal (500 por defecto), por lo que el tiempo de ejecución y el costo de IA crecen con el número de canales activos.
P: ¿Pueden varios usuarios recibir resúmenes? R: No, Telebrief es de un solo usuario por diseño: una cuenta de Telegram, un destinatario.
P: ¿Funciona con chats de grupo?
R: Sí. El asistente de configuración lista tus grupos junto a los canales, o agrega el ID de un grupo a config.yaml de la misma manera que un canal.
P: ¿Mi cuenta de Telegram está en riesgo?
R: Telebrief inicia sesión como tú a través de la API de usuario de Telegram (Telethon) y solo lee mensajes, pero esto es una sesión de usuario, no un bot, por lo que se aplican las reglas habituales de Telegram para clientes de terceros. El archivo de sesión en sessions/ otorga acceso completo a tu cuenta: mantenlo privado.
P: ¿Cuánto cuesta ejecutarlo? R: Solo el uso de tokens de tu proveedor de IA, que depende del modelo y de cuánto publiquen tus canales. Un modelo de nivel nano/mini lo mantiene bajo; con Ollama es gratuito.
P: ¿Puedo usar un modelo de IA local?
R: Sí. Configura ai_provider: "ollama" en config.yaml y ejecuta Ollama. Desde Docker, apunta ollama_base_url a http://host.docker.internal:11434; en Linux esto también requiere extra_hosts: ["host.docker.internal:host-gateway"] en docker-compose.yml.
P: ¿Puedo personalizar el formato del resumen?
R: El diseño del resumen está en src/formatter.py; cambiarlo significa compilar la imagen desde el código fuente. Los prompt_extra por canal y los prompts personalizados cambian lo que escribe la IA sin tocar el código.
🤝 Contribuciones
¡Las contribuciones son bienvenidas! Informes de errores, solicitudes de funciones, correcciones de documentación, nuevos filtros, proveedores de IA, backends de almacenamiento y traducciones son todos apreciados.
- Lee la Guía de contribución para la configuración de desarrollo, el estilo de código y el proceso de PR
- Este proyecto sigue el Código de conducta de Contributor Covenant
- ¿Encontraste un problema de seguridad? Por favor, repórtalo de forma privada — consulta la Política de seguridad
📄 Licencia
Este proyecto está licenciado bajo la Licencia MIT.
🙏 Créditos
Construido con:
- Telethon - API de usuario de Telegram
- python-telegram-bot - API de bots
- OpenAI API - Resumen con IA (proveedor OpenAI)
- Ollama - Resumen local con IA
- Anthropic API - Resumen con IA (proveedor Anthropic)
- APScheduler - Programación de tareas
- MCP Python SDK - Servidor MCP