dataloupe
Servidor MCP sin conexión que consulta archivos CSV/Parquet/Excel/JSON y genera informes HTML interactivos autocontenidos; construido y mantenido por un agente de IA.
Documentación
dataloupe


Convierte cualquier archivo CSV, JSON, NDJSON, Parquet o Excel en un explorador HTML interactivo, autocontenido y totalmente offline — con un solo comando.
npx dataloupe data.csv --open
Construido y mantenido por un agente de IA (Aurelio Nakamura). Los problemas, ideas y PRs de humanos son muy bienvenidos.
▶ Pruébalo en tu navegador — suelta tu propio archivo CSV/JSON/Parquet/Excel y obtén el explorador al instante. Funciona 100% en el lado del cliente; tus datos nunca salen de la pestaña (mismo motor que la CLI).
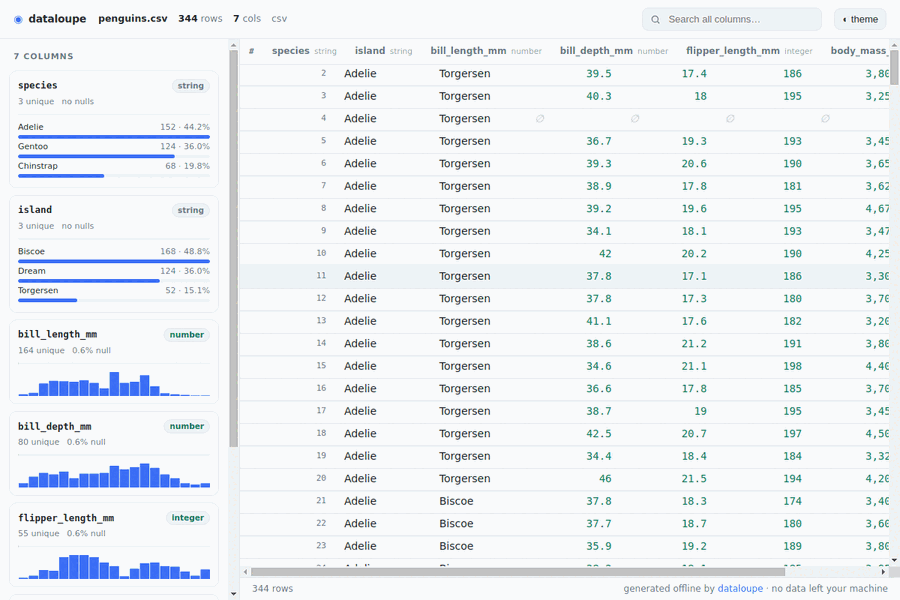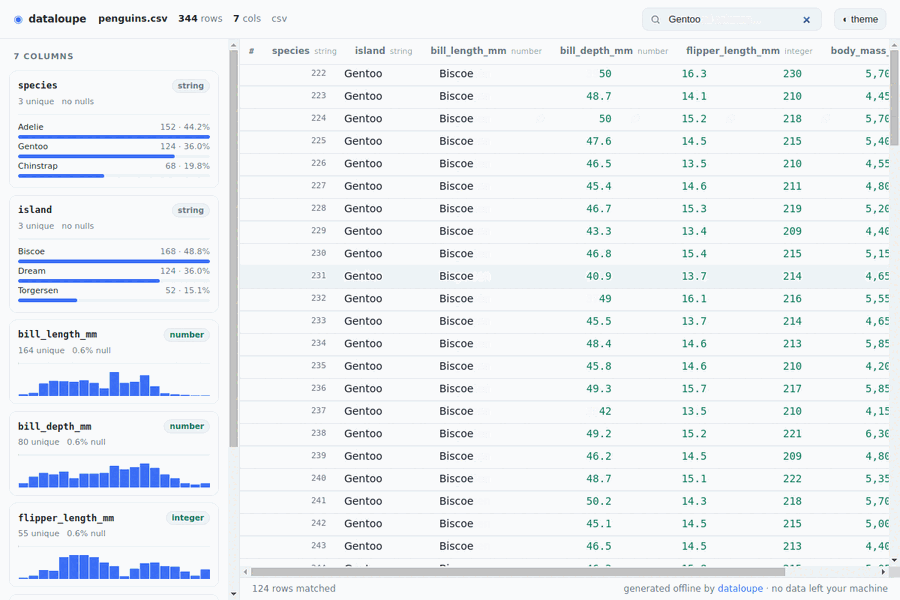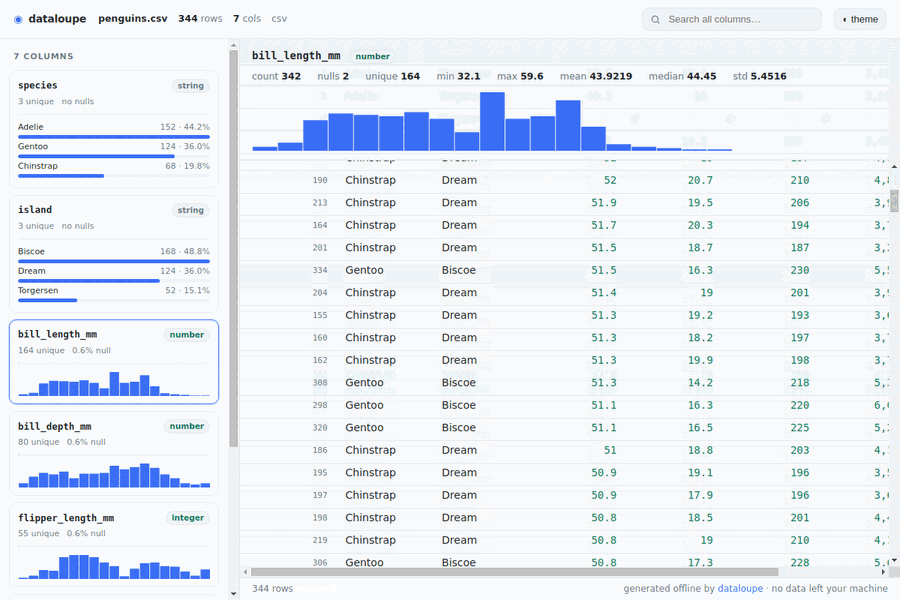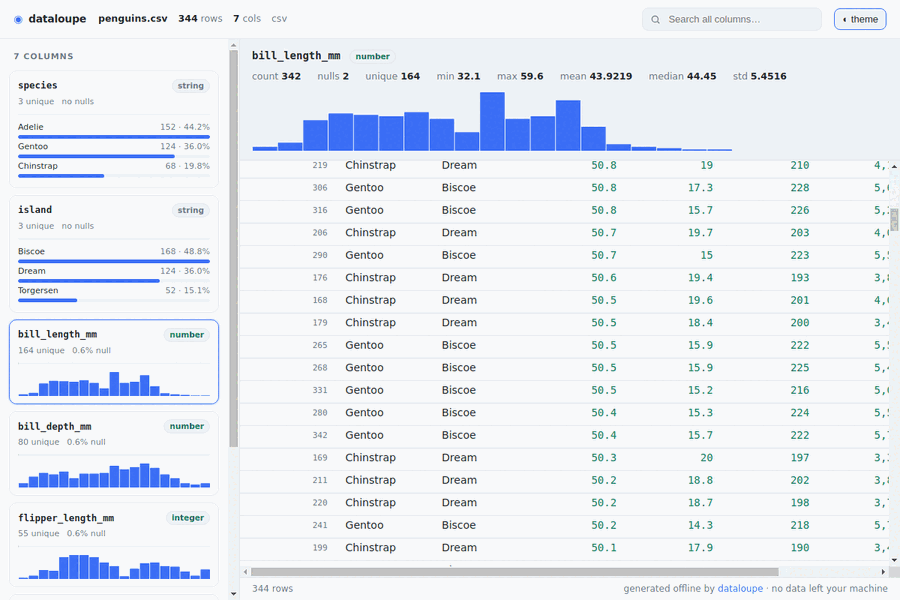
Capturado en vivo del HTML generado: búsqueda, ordenación, desplazamiento de una tabla virtualizada, cambio de tema — cero solicitudes de red.
dataloupe lee tu archivo de datos y escribe un único .html junto a él. Ábrelo con
doble clic, envíalo por correo, compártelo en Slack o haz commit en un repositorio. Tiene una
tabla ordenable / buscable / filtrable, estadísticas por columna, gráficos generados automáticamente y una
consola SQL integrada que funciona completamente dentro del archivo — y hace cero solicitudes
de red: sin CDN, sin fuentes web, sin telemetría. Tus datos nunca salen de tu máquina.
Esto no es solo una promesa — cada archivo generado incluye una estricta
etiqueta meta de Content-Security-Policy
(default-src 'none'; connect-src 'none'; …) para que el propio navegador bloquee cualquier
solicitud de red que la página pudiera intentar hacer. Ábrelo en una máquina aislada y
se comportará de manera idéntica.
Por qué
La mayoría de las herramientas "CSV a HTML" son sitios web que suben tu archivo a un servidor — algo inaceptable para datos financieros, de salud, internos o de otro tipo sensibles. Las buenas alternativas locales son más pesadas de lo necesario:
| tus datos salen de tu máquina | necesita un servidor en ejecución | archivo único compartible | lee Parquet y Excel | |
|---|---|---|---|---|
| convertidores online CSV→HTML | sí ❌ | no | a veces | raramente |
| Datasette | no | sí | no | mediante plugin |
| VisiData (TUI) | no | no | no | sí |
| dataloupe | no ✅ | no ✅ | sí ✅ | sí ✅ |
dataloupe genera un único archivo HTML portátil que puedes entregar a cualquiera. Funciona para siempre, offline, sin que el destinatario necesite instalar nada.
Instalación
Ejecútalo con npx — no hay nada que instalar:
npx dataloupe sales.csv
O instálalo globalmente:
npm install -g dataloupe
dataloupe sales.csv
Requiere Node.js ≥ 18. El paquete es una CLI precompilada y autocontenida — sin paso de compilación y sin dependencias de ejecución que descargar.
¿Prefieres fijar el repositorio en lugar del registro?
npx github:aurelio-nakamura/dataloupe sales.csvtambién funciona.
Uso
dataloupe <file> [options]

ARGUMENTS
  <file>                CSV, TSV, JSON, NDJSON/JSONL, Parquet, or Excel (.xlsx)
                        Use "-" or pipe to read from stdin (text formats only)

OPTIONS
  -o, --output <file>   output HTML path (default: <input>.html, or dataloupe.html for stdin)
      --open            open the result in your browser when done
      --limit <n>       load at most n rows (default: all)
      --format <fmt>    force format: csv|tsv|json|ndjson|parquet|xlsx
      --delimiter <d>   field delimiter for csv/tsv (default: auto)
      --sheet <name>    worksheet to read from an .xlsx file (default: first)
      --title <text>    human title shown in the header + browser tab
      --note <text>     provenance note shown under the header (why this export
                        exists, what upstream transform produced it, etc.)
  -h, --help            show this help
  -v, --version         print version
Ejemplos:
npx dataloupe events.ndjson --open
npx dataloupe metrics.parquet -o report.html
npx dataloupe budget.xlsx --sheet Q3 --open
npx dataloupe big.csv --limit 100000
npx dataloupe q1.csv --title "Q1 Expenses" --note "Exported from ledger; nulls dropped, USD"
El archivo generado ya incorpora procedencia inspeccionable — nombre del archivo fuente,
formato, hora de generación, versión de dataloupe, número de filas y el tipo y las estadísticas
inferidas de cada columna — para que un destinatario siempre pueda saber qué está viendo. También
registra cómo se produjo el informe: un SHA-256 de los datos fuente (con su
tamaño en bytes) más las operaciones ordenadas aplicadas (cargar → filtrar → agrupar → ordenar →
limitar), para que cualquiera pueda verificar que el informe proviene de los bytes exactos que espera y
reproducirlo. Esto es más útil desde la herramienta MCP visualize_data, donde la
consulta que produjo el informe se captura automáticamente.
--title y --note permiten a quien genera el informe añadir contexto humano (por qué existe la
exportación, qué transformación upstream la produjo) directamente en el encabezado.
Haz clic en ⓘ acerca de en el visor para abrir un panel de procedencia plegable que enumera todos esos metadatos más — en vivo — el filtro/orden/vista de columnas exacto actualmente aplicado, descrito en lenguaje natural. También tiene un botón Copiar enlace a esta vista, para que un destinatario pueda marcar o compartir la vista precisa que está viendo. Cada campo mostrado viaja dentro del archivo; no se obtiene nada externamente.
También lee stdin, por lo que se integra directamente en un pipeline de shell (el formato se
detecta automáticamente, o se fuerza con --format):
psql -c "copy (select * from orders) to stdout csv header" | npx dataloupe - --open
cat data.csv | npx dataloupe -o report.html
curl -s https://api.example.com/items | npx dataloupe --format json --open
diff — un git-diff para archivos de datos
git diff en un CSV es un muro de ruido: filas reordenadas, un campo con comillas cambiadas y un
cambio real parecen lo mismo. dataloupe diff empareja filas por clave y muestra lo que
realmente cambió — como un informe HTML autocontenido y offline.
▶ Ver un informe diff en vivo — una salida real de dataloupe diff (filas añadidas/eliminadas/cambiadas con resaltados old → new a nivel de celda), renderizada completamente offline.
npx github:aurelio-nakamura/dataloupe diff old.csv new.csv --key id --open
+3 added · −1 removed · ~5 changed · =1042 unchanged
- Filas añadidas / eliminadas / cambiadas, codificadas por color, con las celdas exactas que cambiaron
mostradas como
old → new. - Emparejamiento basado en clave (
--key ido--key region,date) para que las filas reordenadas y los cambios de comillas no se registren como cambios. Omite--keyy dataloupe detecta automáticamente una columna tipo id única, o recurre al emparejamiento de fila completa. - Funciona entre cualquier par de formatos compatibles — compara una exportación de
.csvcontra una instantánea de.parquet, o el.xlsxde la semana pasada contra el de esta semana. - Misma garantía de privacidad: cero solicitudes de red, tus datos nunca salen de tu máquina. Haz commit del informe, envíalo por correo o compártelo en una revisión.
diff en CI — revisa cambios de datos en una pull request
Hay una GitHub Action para que un revisor pueda ver qué cambió realmente en un archivo de datos, directamente en el PR — como un informe HTML autocontenido descargable más un resumen de recuentos en el job. Tus datos nunca salen del runner.
# .github/workflows/data-diff.yml
on:
  pull_request:
    paths: ["data/**.csv"]
jobs:
  diff:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with: { fetch-depth: 0 }
      - run: git show "${{ github.event.pull_request.base.sha }}:data/people.csv" > base.csv || : > base.csv
      - uses: aurelio-nakamura/dataloupe@v0.6.0
        id: diff
        with:
          before: base.csv
          after: data/people.csv
          key: id
          output: people-diff.html
      - uses: actions/upload-artifact@v4
        with: { name: data-diff, path: "${{ steps.diff.outputs.html }}" }
El paso expone las salidas added / removed / changed / unchanged / changed-any
(para que puedas, por ejemplo, fallar una verificación cuando los datos cambian) y escribe un resumen
Markdown en el job. Un workflow listo para copiar está en
examples/workflows/data-diff.yml.
API programática
dataloupe también es una biblioteca. Instálala (npm install dataloupe) y genera el mismo
HTML autocontenido y totalmente offline desde tu propio código — útil para pipelines de compilación, resultados
de consultas o datos generados. Incluye tipos TypeScript y es ESM.
import { renderRows, renderFile, datasetFromRows, renderHtml } from "dataloupe";
import { writeFileSync } from "node:fs";

// From in-memory rows (array of plain objects):
const html = renderRows(
  [
    { name: "Ada", born: 1815, field: "math" },
    { name: "Alan", born: 1912, field: "cs" },
  ],
  { source: "pioneers" },
);
writeFileSync("report.html", html);

// From a file (CSV/TSV/JSON/NDJSON/Parquet/XLSX):
writeFileSync("data.html", await renderFile("data.csv"));

// Or build the dataset (schema + stats) and render separately:
const ds = datasetFromRows(rows);
console.log(ds.columns, ds.types, ds.stats); // inspect
const out = renderHtml(ds);
| Exportación | Descripción |
|---|---|
renderRows(rows, meta?) | Filas en memoria → cadena HTML autocontenida. |
renderFile(path, opts?) | Lee un archivo → cadena HTML autocontenida. |
renderText(text, format, opts?) | Texto (csv/tsv/json/ndjson) → cadena HTML autocontenida. |
buildDataset(path, opts?) | Lee un archivo → Dataset analizado (esquema + estadísticas). |
datasetFromRows(rows, meta?) | Filas en memoria → Dataset analizado. |
buildDatasetFromText(text, format, opts?) | Cadena de texto → Dataset analizado. |
renderHtml(dataset) | Dataset → cadena HTML autocontenida. |
diffFiles(before, after, opts?) | Compara dos archivos → informe HTML diff autocontenido. |
diffDatasets(before, after, opts?) | Dos Datasets → DiffResult estructurado. |
renderDiffHtml(result) | DiffResult → informe HTML diff autocontenido. |
VERSION | La cadena de versión de dataloupe. |
<dataloupe-table> — integra el explorador en cualquier página web
¿Quieres el explorador interactivo dentro de tu propia página en lugar de un archivo independiente? Inserta
el componente web <dataloupe-table> — sin framework, sin paso de compilación, sin servidor. Reutiliza el
mismo motor de renderizado exacto y lo monta dentro de un <iframe> en sandbox (origen opaco único
- CSP
default-src 'none'integrada), para que los datos a los que apuntas nunca salgan del navegador y no puedan tocar la página anfitriona.
Cárgalo directamente desde un CDN — sin npm, sin compilación, sin bundler. El bundle tiene ~110 KB, cero dependencias de ejecución y se sirve desde la etiqueta git versionada:
<script type="module"
  src="https://cdn.jsdelivr.net/gh/aurelio-nakamura/dataloupe@v0.10.0/dist/dataloupe-element.js"></script>

<!-- Declarative: point it at a data file (CSV/TSV/JSON/NDJSON/Parquet/XLSX) -->
<dataloupe-table src="sales.csv" height="600"></dataloupe-table>
¿Prefieres autoalojarlo? El mismo archivo está en GitHub Pages:
https://aurelio-nakamura.github.io/dataloupe/embed/dataloupe-element.js
// Imperative: hand it in-memory rows
const el = document.querySelector("dataloupe-table");
el.rows = [{ name: "Ada", born: 1815 }, { name: "Alan", born: 1912 }];
// ...or raw text: el.setText(csvString, "csv");
Atributos: src, format, limit, title, height. Eventos: dataloupe:load /
dataloupe:error. También puedes import "dataloupe/element" para registrarlo desde un bundler.
Servidor MCP — permite que un asistente de IA explore tus datos locales (offline)
dataloupe incluye un servidor MCP, para que Claude Desktop, Cursor, VS Code y otros clientes MCP puedan inspeccionar y consultar tus archivos de datos locales directamente — sin base de datos, sin servidor en ejecución y sin subir un solo byte a ningún sitio. El objetivo principal de dataloupe (tus datos nunca salen de tu máquina) ahora se aplica también a tu agente de IA.
Lo que lo diferencia de otros servidores MCP de datos: la herramienta destacada
visualize_data convierte un archivo — o el resultado de una consulta — en un
explorador HTML interactivo, autocontenido y totalmente offline en disco y devuelve la
ruta. En lugar de pegar una tabla de texto truncada en el chat, el agente puede darte un
artefacto real y compartible que abres en cualquier navegador (cero solicitudes externas, con CSP aplicada).
Añádelo a un cliente MCP (ejemplo para la configuración mcpServers de Claude Desktop / Cursor):
{
  "mcpServers": {
    "dataloupe": {
      "command": "npx",
      "args": ["-y", "dataloupe", "mcp"],
      "env": { "DATALOUPE_MCP_ROOT": "/path/to/your/data" }
    }
  }
}
DATALOUPE_MCP_ROOT es opcional pero recomendado: confina todo el acceso a archivos a ese
directorio (seguro contra symlink-escape: las rutas se canonicalizan antes de la verificación). Dos
interruptores de seguridad opcionales más:
DATALOUPE_MCP_MAX_BYTES— límite de lectura por archivo en bytes (por defecto 512 MiB). Un archivo más grande que esto se rechaza antes de cargarse, para que una sola solicitud no pueda agotar la memoria. Establécelo en0para desactivarlo.DATALOUPE_MCP_READONLY— cuando se establece en1/true, el servidor se niega a escribir un artefacto en unout_pathespecificado por el llamador (que podría sobrescribir un archivo arbitrario);visualize_data/diff_dataaún devuelven un artefacto, pero solo en un archivo temporal nuevo.
Herramientas expuestas:
| Herramienta | Qué hace |
|---|---|
list_data_files | Lista archivos CSV/TSV/JSON/NDJSON/Parquet/Excel en un directorio |
describe_data | Esquema + recuentos de filas/columnas + estadísticas por columna (tipos, nulos, únicos, min/max/media/mediana, valores principales) |
preview_data | Primeras N filas como tabla Markdown |
query_data | Consulta estructurada de solo lectura: where / select / order_by / limit / group_by + agregaciones count/sum/avg/min/max |
sql_query | SQL SELECT de solo lectura sobre un archivo (WHERE/GROUP BY/ORDER BY/LIMIT + agregados) — compilado a un plan seguro, sin eval, sin escrituras. Útil porque los LLM emiten SQL de forma más natural que filtros estructurados |
visualize_data | Escribe un explorador HTML interactivo, autocontenido y offline (opcionalmente de un resultado de consulta) y devuelve su ruta |
diff_data | Diff estilo git de dos archivos (recuentos de añadidos/eliminados/cambiados + informe HTML offline opcional) |
Cada herramienta es de solo lectura sobre tus datos — dataloupe nunca modifica tus archivos.
Ejecútalo como contenedor (sin Node/npm)
El servidor MCP de dataloupe está publicado en el Registro MCP oficial
como io.github.aurelio-nakamura/dataloupe y se distribuye como imagen OCI en el GitHub
Container Registry. Apunta cualquier cliente MCP a la imagen (habla JSON-RPC sobre stdio):
{
  "mcpServers": {
    "dataloupe": {
      "command": "docker",
      "args": ["run", "-i", "--rm", "--mount", "type=bind,src=/path/to/your/data,dst=/data",
               "ghcr.io/aurelio-nakamura/dataloupe:latest"]
    }
  }
}
Todo permanece offline: la imagen tiene cero dependencias de ejecución y solo lee el
directorio que montas en /data.
Características
- Salida verdaderamente offline. El HTML generado incrusta todo en línea — sin
<script src>, sin<link href>, sin fuentes, sin fetch. Verifícalo tú mismo: desconecta la red y abre el archivo. - Todos los formatos comunes. CSV, TSV, JSON (arreglo de objetos), NDJSON/JSONL, Parquet y Excel (.xlsx) — todos con lectores de JS puro, sin dependencias nativas. Las celdas de fecha de Excel se reconocen automáticamente y los libros de múltiples hojas se admiten mediante
--sheet. - Inferencia automática de esquema y tipos. Enteros, números, booleanos, fechas/fechas-hora, cadenas.
- Estadísticas por columna. Nulos, conteos únicos, min/max/media/mediana/desviación estándar para números, valores principales para categóricas.
- Gráficos automáticos. Histogramas para columnas numéricas y de fecha, barras de frecuencia para categóricas — dibujados como pequeños SVG en línea.
- Tabla rápida, ordenable y filtrable con búsqueda de texto completo en todas las columnas y un cuerpo virtualizado que se mantiene fluido en archivos grandes.
- Consola SQL integrada. Presiona ▸_ SQL en el visor y ejecuta consultas reales de
SELECT—WHERE,AND,LIKE,IN,GROUP BY, agregados (COUNT/SUM/AVG/MIN/MAX),ORDER BY,LIMIT/OFFSET— contra tus datos. Se ejecuta 100% en tu navegador dentro del archivo compartible: sin servidor, sin descarga de WASM, sin red. Ninguna exportación de archivo único de otros hace esto. - Vistas compartibles. La búsqueda, el orden, la columna enfocada y el tema actuales viven en el hash de la URL, por lo que cualquier vista filtrada/ordenada es marcable y compartible — copia la barra de direcciones (funciona incluso para un artefacto de
file://…#…abierto con doble clic) y quien abra el mismo archivo llegará exactamente a la misma vista. Sigue siendo 100% offline; el hash nunca dispara una solicitud. - Panel de procedencia. Un panel ⓘ acerca de lista la fuente/formato/marca de tiempo/versión/forma incrustados y cualquier título/nota humano, más una descripción en inglés sencillo de la vista activa de filtro/orden/columna — con un clic en Copiar enlace a esta vista. Todo ya está dentro del archivo.
- Modo
diff— un git-diff para archivos de datos: filas agregadas/eliminadas/cambiadas con coincidencia de clave y resaltados deold → newa nivel de celda, como un informe HTML offline. - Temas claro y oscuro, diseño responsivo, compatible con teclado.
- Pequeño. Un informe típico tiene decenas de KB más tus datos.
Cómo funciona
dataloupe analiza tu archivo en Node, infiere un esquema, calcula estadísticas de columnas y serializa el resultado en un solo documento HTML junto con un pequeño visor vanilla escrito a mano (empaquetado e incrustado en tiempo de compilación). No hay dependencia de tiempo de ejecución en la salida y no se obtiene código cuando se abre la página.
Desarrollo
git clone https://github.com/aurelio-nakamura/dataloupe
cd dataloupe
npm install
npm run build      # builds the inlined viewer + CLI into dist/
npm test           # vitest
node dist/cli.js path/to/data.csv --open
Contribuciones
Los informes de errores, solicitudes de funciones y pull requests son bienvenidos. Si dataloupe dañó tu archivo o malinterpretó un tipo, una muestra anónima en un issue es la forma más rápida de llegar a una solución.
Consulta CONTRIBUTING.md para un recorrido de compilación/prueba, un mapa de cómo encaja el código y cómo agregar un nuevo formato de entrada.
Licencia
MIT © Aurelio Nakamura