codearia-sieve
Convierte una página web en un estado listo para decisiones para agentes de IA: fechas como campos ISO, números con unidades como hechos, fragmentos con presupuesto de tokens y anclas de regreso a la página, y la factura de tokens (página mediana 53,718 → 1,106 tokens). Determinista, sin modelo, sin clave API; se combina con modelos de decisión como Jev. Instalación: npx -y codearia-sieve.
Documentación
codearia-sieve
Analiza una página web y la convierte en el formato exacto que un modelo de decisión necesita.
Fechas como fechas. Números con unidades. Texto en fragmentos que caben en la ventana del modelo, cada uno apuntando a su origen.
Una sola llamada — y la factura de tokens, antes y después.




npx codearia-sieve          # MCP server for Claude Code, Cursor and any agent
npm i codearia-sieve        # or the library
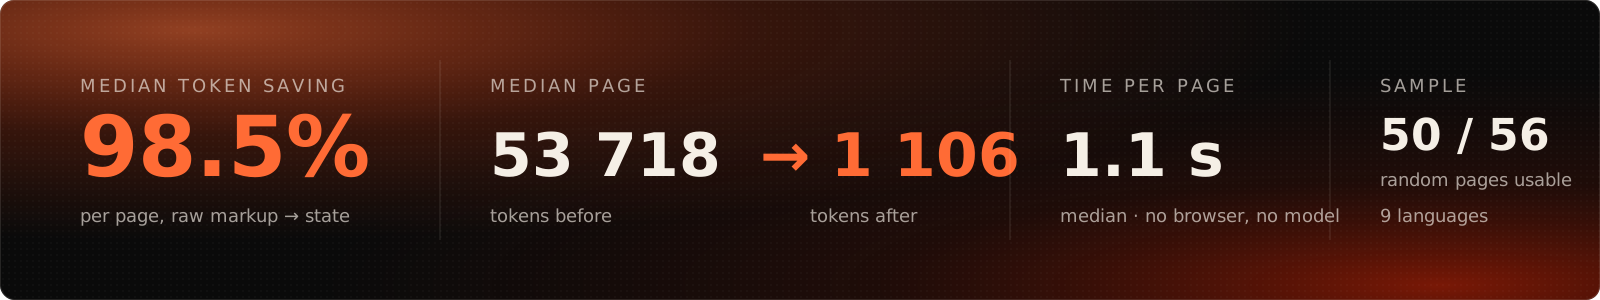
Medido, no prometido. Una ejecución en vivo sobre páginas aleatorias elegidas el mismo día — noticias frescas de fuentes RSS en varios idiomas, artículos aleatorios de Wikipedia, documentación, blogs, sitios gubernamentales, recetas, tiendas. Cada fila está en bench/analytics/, y npm run analytics vuelve a ejecutar todo el proceso. El resultado se puso luego frente a un modelo de decisión: ver Verificado por un juez.
Qué hace
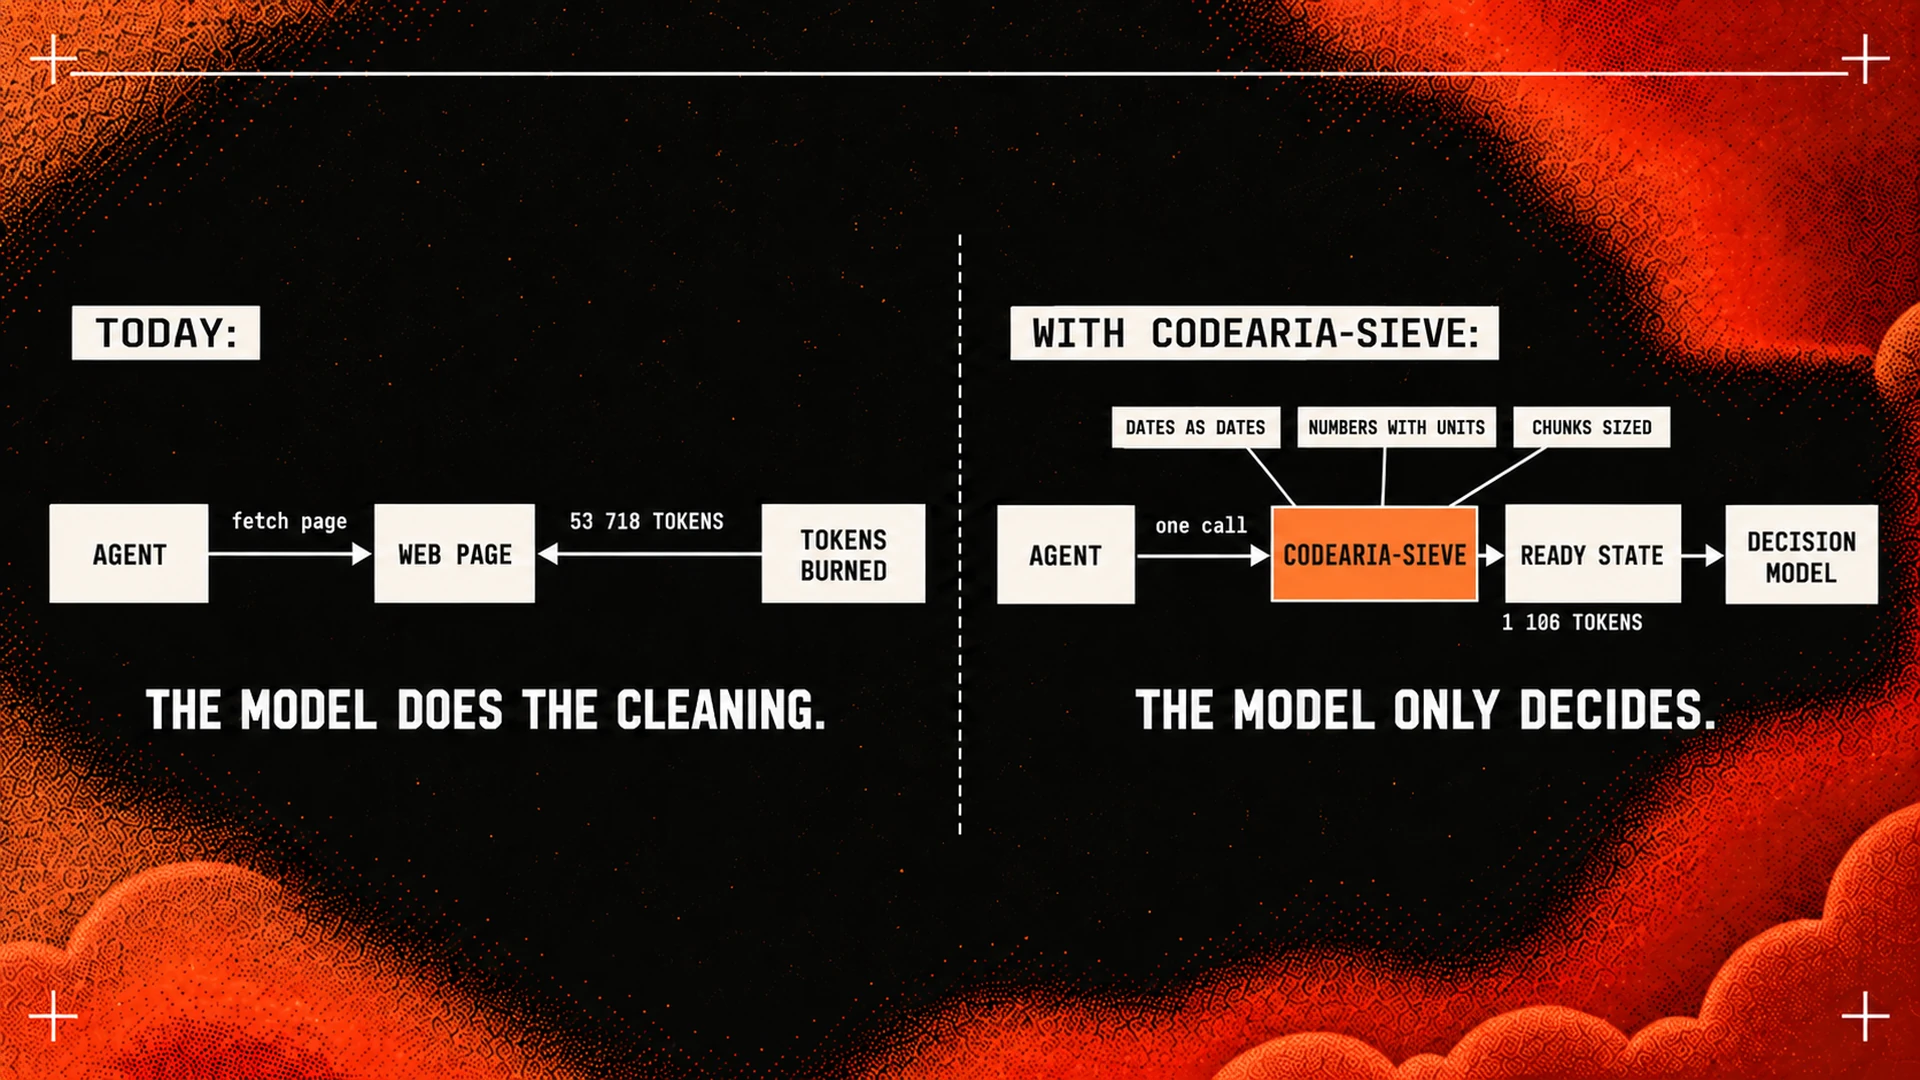
Un agente que necesita una página web la descarga completa: navegación, banner de cookies, pie de página, espacios publicitarios, un megabyte de marcado de framework. Luego un modelo que paga por token escarba en el montón buscando un párrafo.
codearia-sieve hace la excavación antes de que el modelo vea nada — y devuelve la página como estado, no como prosa:
|
Las fechas se convierten en fechas
|
Los números se convierten en hechos
|
El texto se convierte en fragmentos que caben Cada fragmento conoce su tamaño en tokens y caracteres, los bloques de los que se construyó y el |
Todo lo demás — menús, pies de página, banners, filas de etiquetas, "leer más" — se elimina, y con trace: true obtienes la lista de lo que se eliminó y por qué.
Para quién es
Personas que construyen agentes y han visto la factura. Cada página descargada cuesta decenas de miles de tokens antes de que el agente haya leído una palabra. Mediana de página en la muestra: 53 718 tokens de entrada, 1 106 de salida.
Personas que ejecutan modelos de decisión baratos. Clasificadores, clasificadores de ranking, modelos de Sistema Uno como Jev que juzgan en lugar de escribir. Son casi gratuitos y muy rápidos, y tienen bordes duros: no pueden contar, leen las fechas como texto y su precisión cae cuando el material irrelevante llena el contexto. Cada herramienta de "página a markdown" prepara entrada para un lector. Esta prepara entrada para un juez.
Personas que necesitan respuestas verificables. Un veredicto de texto extraído no es demostrable a menos que cada pieza apunte a su fuente. Aquí cada hecho nombra su bloque y cada fragmento lleva un ancla.
Cómo funciona
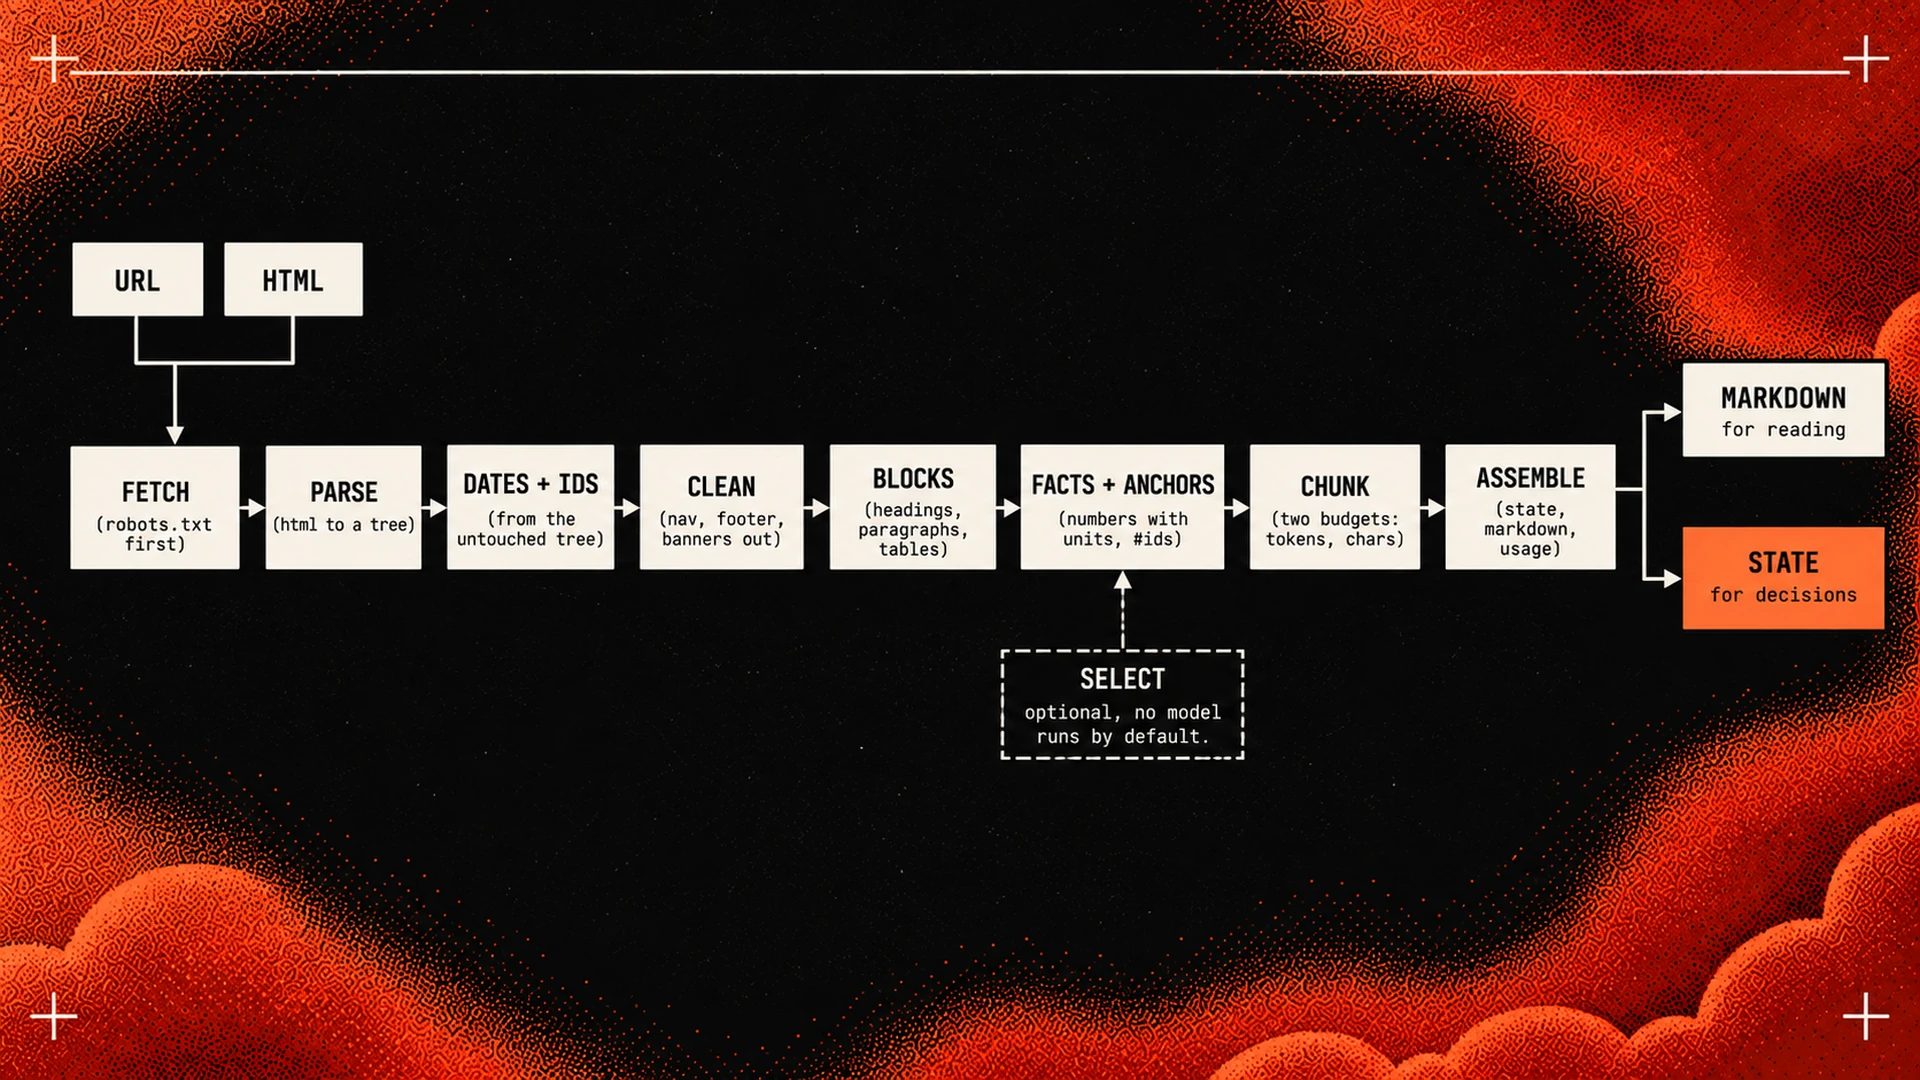
Ocho pasos de código ordinario. Ningún modelo se ejecuta a menos que lo conectes. El mismo HTML da el mismo JSON, byte por byte.
- Descarga —
robots.txtprimero; una negativa se informa, no se evita. HTTP simple, user agent honesto. - Análisis — HTML a un DOM con
linkedom. Sin navegador. - Fechas e ids del árbol intacto — la limpieza elimina
<head>, firmas y atributos, así que ambos se leen antes de que se ejecute. - Limpieza — Defuddle elimina el cromo; Readability toma el control si vuelve vacío. Los elementos en línea reciben un espacio primero, así que
<span>20 Sept</span><span>10 min</span>nunca se convierte en202610 min. - Bloques — encabezados, párrafos, listas, tablas, código, citas, en orden, con ids posicionales. Las páginas antiguas configuradas con
<br><br>se convierten en párrafos también; las filas de tabla conservan sus encabezados de columna. - Hechos y anclas — ids restaurados; los números se convierten en hechos solo junto a una unidad; los rangos conservan ambos extremos.
- Fragmentación — codiciosa, en orden, bajo dos presupuestos a la vez: 20 000 tokens y 50 000 caracteres por defecto.
- Ensamblaje —
state,markdown,usage,warningsy el rastro bajo petición.
Cómo se ve el resultado
const r = await sieve({ kind: 'url', url: 'https://docs.typesafe.ai/models' });

r.state.title         // "Models"
r.state.facts[0]      // { value: 42, unit: "USD_per_billion", label: "price_btok_mtok",
                      //   context: "Price (per Btok / per Mtok) | jev-1.13.0: $42 / $0.042", from: "b3" }
r.state.facts[1]      // { value: 0.042, unit: "USD_per_million", … }   — paired by position
r.state.chunks[0]     // { id: "c1", tokens: 1210, chars: 5357, anchor: "Current models",
                      //   headings: ["Current models", "Pricing", …], blocks: ["b1", …, "b36"], text: "…" }
r.usage               // { rawTokens: 127413, stateTokens: 1211,
                      //   visibleChars: 4939, stateChars: 5357, chunks: 1, ms: 1503 }
r.warnings            // []
r.markdown            // the same article, for a human or a generative model
Los resultados esperados nunca lanzan excepciones. Vuelven como advertencias, cada una con nombre:
| Advertencia | Significado |
|---|---|
robots-disallowed | el sitio pide a los rastreadores que se mantengan fuera; no descargamos |
blocked | un desafío de bot o una negativa (403, 405, 429, "Solo un momento…"), con el estado |
http-error | un 404 o un 500 que aun así mostró una página de error; no es la página que pediste |
paywall | la página marca su artículo como no gratuito; obtuviste el adelanto |
empty-without-js | el contenedor del artículo está vacío y un script lo llenaría |
thin-content | una página grande que produjo poca prosa — una portada, un listado |
block-split | un bloque excedió el presupuesto y se cortó en límites de oración |
facts-capped | la página tiene más hechos que los 500 listados — una larga tabla de tarifas, por ejemplo |
Úsalo desde un agente
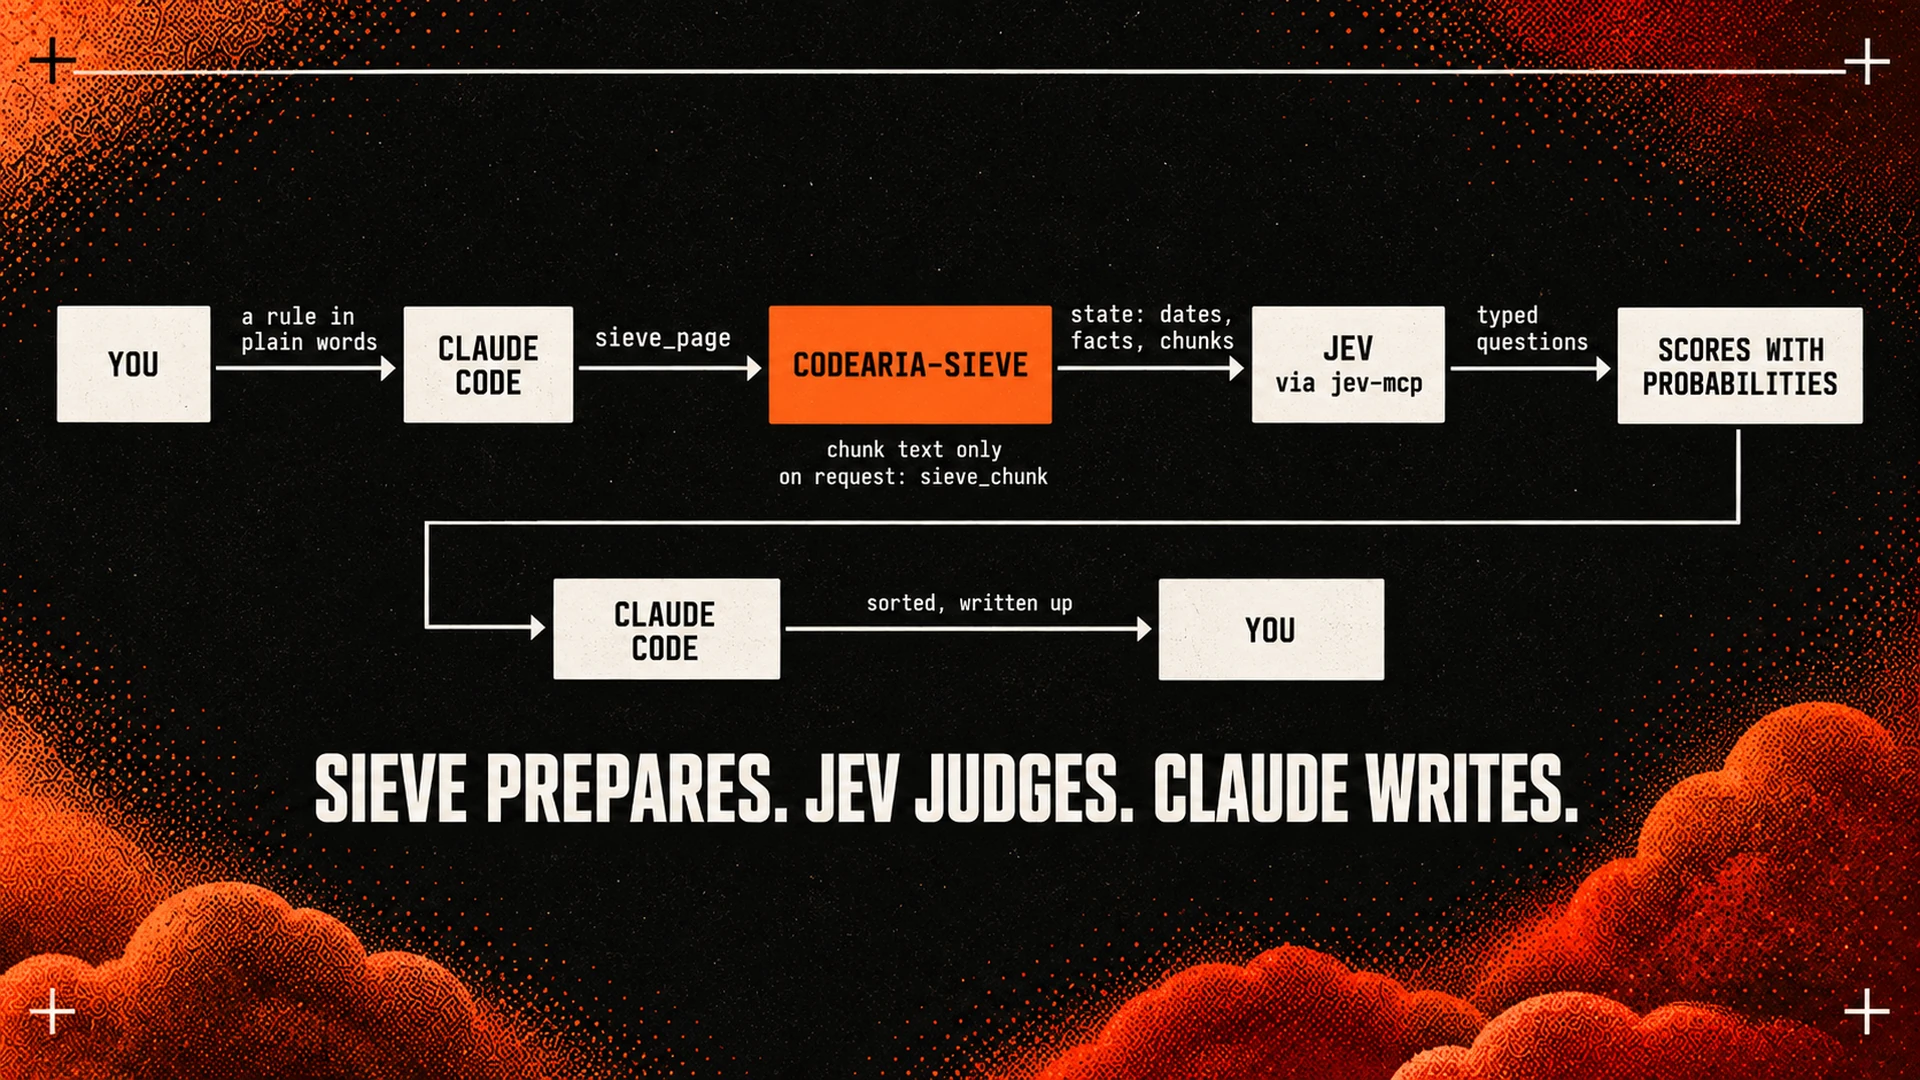
Dices lo que quieres en palabras simples. El agente encuentra las páginas, llama a sieve_page para cada una, entrega el estado a un modelo de decisión con una pregunta tipada y redacta el resultado. Sieve prepara. El juez juzga. El agente escribe.
{ "mcpServers": { "sieve": { "command": "npx", "args": ["-y", "codearia-sieve"] } } }
Listado en el Registro oficial de MCP como io.github.AntonG87/codearia-sieve; los clientes que leen el registro pueden instalarlo por nombre.
|
Devuelve |
El texto de un fragmento del último resultado para esa URL, sin volver a descargar. Primero el resumen, luego solo lo necesario — la herramienta aplica su propia idea a sí misma. |
Se combina con jev-mcp: los fragmentos están dimensionados para caber en sus campos, así que el estado va directo a una pregunta tipada.
Verificado por un juez
La afirmación es que un modelo de decisión recibe una entrada mejor de Sieve que de texto crudo. Así que el resultado se entregó a uno. examples/jev.ts maneja ambos servidores MCP con el cliente oficial — codearia-sieve prepara seis páginas (documentación de API, una nota de versión, dos artículos de Wikipedia en dos idiomas, dos páginas de precios), Jev las juzga a través de jev-mcp. Misma ejecución, 21 de septiembre de 2026:
| Pregunta a Jev | Entrada de Sieve | Resultado |
|---|---|---|
jev_classify — ¿qué tipo de página es esta? | título + encabezado del primer fragmento, bajo el límite de 2 000 caracteres de la herramienta | 6 de 6 correctos; 5 automáticos, 1 marcado para revisión — una página que es a la vez documentación y tarjeta de tarifas |
jev_verify — ¿está realmente cada hecho extraído en la página? | cada hecho como afirmación, sus fragmentos como evidencia | 11 de 11 verificados, todos automáticos, confianza 0.86–1.0 |
jev_extract — ¿cuándo se publicó? | primer fragmento, una regex de fecha, una descripción | coincide con Sieve donde la página declara una fecha; Sieve también lee JSON-LD y <meta>, que Jev nunca ve |
La primera pasada de esta prueba hizo su trabajo al revés: Jev envió tres hechos para revisión y contradijo uno. Los cuatro se rastrearon hasta Sieve — una fila de tabla etiquetada por su encabezado de columna en lugar de su encabezado de fila, dos tarifas en un encabezado sin emparejar, y una "256 с." bibliográfica rusa leída como segundos. Corregido, probado, reejecutado: 11 de 11. Un juez que puede decirte cuándo tu analizador está equivocado es el punto de todo el emparejamiento.
TYPESAFE_API_KEY=… node --experimental-strip-types examples/jev.ts
Úsalo como biblioteca
import { sieve } from 'codearia-sieve';

await sieve({ kind: 'url', url });                    // fetch it
await sieve({ kind: 'html', html, url });             // already have it; url only for anchors

await sieve(input, {
  budget:    { maxTokens: 8000, maxChars: 30000 },    // chunk limits
  trace:     true,                                    // everything discarded, and why
  tokenizer: myTokenizer,                             // o200k by default; swap for your model's
  fetcher:   myFetcher,                               // your transport, or a file reader in tests
  now:       () => fixedDate,                         // injected clock: identical output on identical input
  selector:  mySelector, task: 'is this about pricing?', // relevance judge; nothing runs without one
});
parseDate, findDates y los límites del proveedor (JEV, JEV_MCP, DEFAULT_BUDGET) también se exportan.
Dónde se detiene
- Portadas, listados y páginas de producto no tienen artículo que encontrar. Obtienes los titulares y una advertencia
thin-content, no una victoria falsa. - Artículos renderizados por JavaScript vuelven como
empty-without-jscuando el contenedor está vacío. Un sitio que envía un adelanto y transmite el resto no se puede distinguir sin un navegador; obtienes el adelanto. - Las páginas con mucho texto ahorran menos. Una novela completa ahorra un 22 %, un RFC un 84 %: no hay envoltorio que eliminar y el texto se conserva completo. Así funciona la herramienta.
- Una cuadrícula de precios no es una tabla. Un hecho sabe de qué bloque vino, no bajo qué columna de plan está; Sieve no adivina el emparejamiento. Envía el fragmento — una página de precios son alrededor de mil tokens después de la limpieza — y deja que el juez lo lea:
examples/pricing-watch.ts. - Los tokens se cuentan con o200k como aproximación. Las páginas de más de un megabyte reciben un conteo muestreado y
usage.rawTokensEstimated: true.
Desarrollo
npm install
npm test                    # 71 tests, offline, a few seconds
npm run demo -- <url>       # the token bill for one page
npm run bench               # the 20-page benchmark set
npm run analytics           # the 56-page random sample: rows, CSV, summary
Notas de diseño — visión y arquitectura — están en docs/.
MIT © 2026 Anton Evelson · Codearia Academy