NeoCoder
Permite a los asistentes de IA utilizar un grafo de conocimiento Neo4j para flujos de trabajo de codificación estandarizados, actuando como un manual de instrucciones dinámico y memoria de proyecto.
Documentación
NeoCoder: Flujo de Trabajo de Codificación con IA Guiado por Neo4j
Una implementación de servidor MCP que permite a asistentes de IA como Claude utilizar un grafo de conocimiento Neo4j como su "manual de instrucciones" dinámico y memoria de proyecto principal para flujos de trabajo de codificación estandarizados.
NeoCoder: Sistema Híbrido de Razonamiento y Flujo de Trabajo con IA
Una implementación avanzada de servidor MCP que combina grafos de conocimiento Neo4j, bases de datos vectoriales Qdrant y orquestación sofisticada de IA para crear un sistema de razonamiento híbrido para gestión del conocimiento, análisis de investigación y flujos de trabajo estandarizados.
Descripción General
NeoCoder implementa un sistema revolucionario de Razonamiento Aumentado por Contexto que va mucho más allá del RAG tradicional (Generación Aumentada por Recuperación) al combinar:
Arquitectura Principal:
- Grafos de Conocimiento Neo4j - Hechos estructurados autoritativos, relaciones y flujos de trabajo
- Bases de Datos Vectoriales Qdrant - Búsqueda semántica, detección de similitudes y comprensión contextual
- Orquestación MCP - Enrutamiento inteligente entre fuentes de datos con síntesis y citación
- Síntesis F-Contracción - Fusión dinámica de conocimiento que preserva la atribución de fuentes
Capacidades Clave:
- Razonamiento Híbrido de Conocimiento: Combina sin problemas hechos estructurados con contexto semántico
- Extracción Dinámica de Conocimiento: Procesa documentos, código y conversaciones en estructuras de conocimiento interconectadas
- Análisis Basado en Citaciones: Cada afirmación rastreada hasta su fuente en múltiples bases de datos
- Sistema Multi-Incarnación: Modos especializados para codificación, investigación, soporte de decisiones y gestión del conocimiento
- Plantillas de Flujo de Trabajo Inteligentes: Procedimientos guiados por Neo4j con pasos de verificación obligatorios
Características Revolucionarias:
🧠 Enrutamiento Inteligente de Consultas: La IA determina automáticamente la fuente de datos óptima (grafo, vectorial o híbrida) 🔬 Motor de Análisis de Investigación: Procesa artículos académicos con grafos de citación y contenido semántico ⚡ Procesamiento F-Contracción: Fusiona dinámicamente conceptos similares preservando la procedencia 🎯 Razonamiento Aumentado por Contexto: Genera ideas imposibles con fuentes de datos únicas 📊 Auditorías Completas: Seguimiento total de la síntesis de conocimiento y ejecución de flujos de trabajo 🛡️ Gestión de Procesos Lista para Producción: Limpieza automática, manejo de señales y seguimiento de recursos para prevenir fugas de procesos 🔧 Manejo Mejorado de Herramientas: Inicialización asíncrona robusta con gestión adecuada de tareas en segundo plano
Nuevo de una idea que tuve- Marco Ecológico Lotka-Volterra integrado en la Incarnación de Grafo de Conocimiento
Gestión de Procesos y Fiabilidad
NeoCoder implementa una gestión integral de procesos siguiendo las mejores prácticas de MCP:
- Manejadores de Señales: Manejo adecuado de SIGTERM/SIGINT para apagados elegantes
- Seguimiento de Recursos: Seguimiento automático de procesos, conexiones Neo4j y tareas en segundo plano
- Limpieza de Zombis: Detección activa y limpieza de instancias de servidor huérfanas
- Gestión de Memoria: Prevención de fugas de recursos mediante patrones de limpieza adecuados
- Gestión de Tareas en Segundo Plano: Manejo seguro de inicialización asíncrona y operaciones concurrentes
- Agrupación de Conexiones: Gestión eficiente del controlador Neo4j con limpieza automática
Comandos de Monitoreo
Utilice estas herramientas para monitorear la salud del servidor:
get_cleanup_status()- Ver el uso de recursos y el estado de limpiezacheck_connection()- Verificar la conectividad y permisos de Neo4j
Inicio Rápido
Requisitos Previos
-
Neo4j: Ejecutándose localmente o instancia remota (para grafos de conocimiento estructurados)
-
Qdrant: Base de datos vectorial para búsqueda semántica y embeddings (para razonamiento híbrido)
-
Python 3.10+: Para ejecutar el servidor MCP
-
uv: El gestor de paquetes de Python para servidores MCP
-
Claude Desktop: Para usar con Claude AI
-
MCP-Desktop-Commander: Invaluable para operaciones de CLI y sistema de archivos
-
Para el Ecosistema Lotka-Volterra y capacidades generalmente mejoradas-
-
wolframalpha-llm-mcp: ¡realmente agradable!
-
mcp-server-qdrant-enhanced: Mi servidor mcp qdrant mejorado
-
Opcional para más utilidad
Esta incarnación todavía está en desarrollo
-
Para la Incarnación de Análisis de Código: AST/ASG: Actualmente necesita desarrollo y una reescritura de la incarnación
-
Obtenga una clave API gratuita de WolframAlpha:
Para obtener una clave API gratuita (AppID) para Wolfram|Alpha, debe registrarse para obtener un Wolfram ID y luego registrar una aplicación en el Portal de Desarrolladores de Wolfram|Alpha.
Cree un Wolfram ID: Si aún no tiene uno, cree un Wolfram ID en https://account.wolfram.com/login/create
Navegue al Portal de Desarrolladores: Una vez que tenga un Wolfram ID, inicie sesión en el Portal de Desarrolladores de Wolfram|Alpha https://developer.wolframalpha.com/portal/myapps
Regístrese para su primer AppID: Haga clic en el botón "Sign up to get your first AppID".
Complete el diálogo de creación de AppID: Proporcione un nombre y una descripción simple para su aplicación.
Reciba su AppID: Después de completar la información necesaria, se le presentará su clave API, también denominada AppID.
La API de Wolfram|Alpha es gratuita para uso no comercial, y obtiene hasta 2,000 solicitudes por mes.
Cada aplicación requiere su propio AppID único.
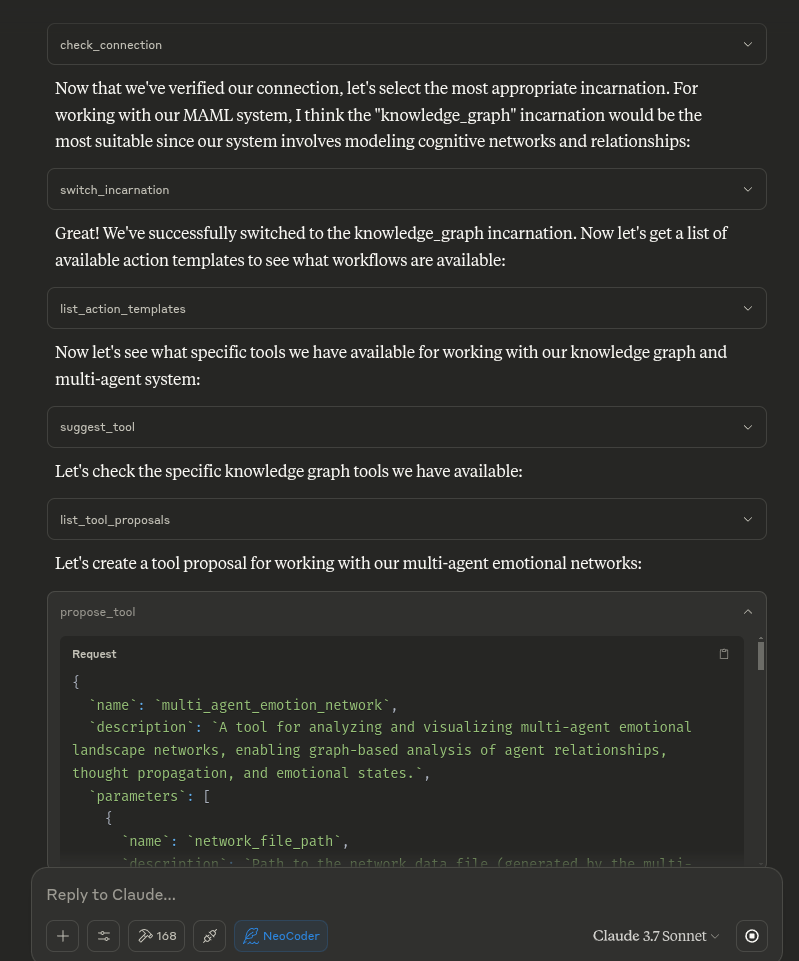
El servidor MCP ejecuta el código Python, cerrando la brecha entre el grafo Neo4j y el asistente de IA (por ejemplo, Claude)
Instalación
1. Clonar el repositorio
git clone https://github.com/angrysky56/NeoCoder-neo4j-ai-workflow.git
cd NeoCoder-neo4j-ai-workflow
2. Configurar Python y el entorno virtual
Asegúrese de tener pyenv y uv instalados.
pyenv install 3.11.12  # if not already installed
pyenv local 3.11.12
uv venv
source .venv/bin/activate
3. Instalar dependencias
uv pip install -e '.[dev,docs,gpu]'
4. Iniciar Neo4j y Qdrant
- Neo4j:
Inicie su servidor Neo4j (local o remoto).
Conexión predeterminada:
bolt://localhost:7687
Parámetros de conexión de Neo4j:
-
URL:
bolt://localhost:7687(predeterminado) -
Nombre de usuario:
neo4j(predeterminado) -
Contraseña: La contraseña de su base de datos Neo4j
-
Base de datos:
neo4j(predeterminado)Establezca las credenciales mediante variables de entorno si es necesario:
NEO4J_URLNEO4J_USERNAMENEO4J_PASSWORDNEO4J_DATABASE
-
Qdrant: Para almacenamiento persistente de Qdrant, use este comando Docker (recomendado):
docker run -p 6333:6333 -p 6334:6334 \
  -v "$(pwd)/qdrant_storage:/qdrant/storage:z" \
  qdrant/qdrant
Esto almacenará los datos de Qdrant en una carpeta
qdrant_storageen el directorio de su proyecto.
5. (Opcional) Usuarios de VS Code
- Abra la Paleta de Comandos (
Ctrl+Shift+P), seleccione Python: Select Interpreter y elija.venv/bin/python.
- Debería instalarse automáticamente al usar la configuración; ya no estoy seguro, no lo he probado y algunas dependencias son bastante grandes.
Inicio Rápido Potencial- jaja perdón
Recomendado: Integración con Claude Desktop:
Configure Claude Desktop agregando lo siguiente a su
claude-app-config.json:
{
  "mcpServers": {
    "neocoder": {
      "command": "uv",
      "args": [
        "--directory",
        "/your-path-to/NeoCoder-neo4j-ai-workflow",
        "run",
        "mcp_neocoder"
      ],
      "env": {
        "NEO4J_URL": "bolt://localhost:7687",
        "NEO4J_USERNAME": "neo4j",
        "NEO4J_PASSWORD": "your-neo4j-password-here",
        "NEO4J_DATABASE": "neo4j",
        "LOG_LEVEL": "INFO",
        "MCP_TRANSPORT": "stdio",
        "PYTHONUNBUFFERED": "1"
      }
    }
  }
}
Importante: La contraseña en esta configuración debe coincidir con la contraseña de su base de datos Neo4j.
De lo contrario, instale las dependencias: Solución rápida de problemas:
- Si ve errores sobre paquetes faltantes, verifique que su
.venvesté activado y que esté usando la versión correcta de Python. - Si necesita restablecer su entorno, puede eliminar
.venvy repetir los pasos anteriores. - ¿No puede conectarse a la base de datos? Instale neo4j Desktop y QDRANT. Asegúrese de que estén ejecutándose. NEO4J requiere que se establezca una contraseña.
docker pull qdrant/qdrant

docker run -p 6333:6333 -p 6334:6334 \
    -v "$(pwd)/qdrant_storage:/qdrant/storage:z" \
    qdrant/qdrant
¡Ahora está listo para usar NeoCoder con razonamiento híbrido completo de Ecosistema Lotka-Volterra Neo4j y Qdrant!
Prompt de sistema sugerido
> **System Instruction:** You are an AI assistant integrated with a Neo4j knowledge graph that defines our standard procedures and tracks project changes.
>
> **Your Core Interaction Loop:**
> 1.  **Identify Task & Keyword:** Determine the action required (e.g., fix a bug -> `FIX`).
> 2.  **Consult the Hub:** If unsure about keywords or process, start by querying `:AiGuidanceHub {id: 'main_hub'}` for guidance and links to best practices or other guides.
> 3.  **Retrieve Instructions:** Formulate a Cypher query to fetch the `steps` from the current `:ActionTemplate` matching the keyword (e.g., `MATCH (t:ActionTemplate {keyword: 'FIX', isCurrent: true}) RETURN t.steps`). Execute this query.
> 4.  **Execute Guided Workflow:** Follow the retrieved `steps` meticulously. This includes reviewing project READMEs, implementing changes, and critically:
> 5.  **Perform Verification:** Execute the testing steps defined in the template. **ALL required tests MUST pass before you consider the task complete.**
> 6.  **Record Completion (Post-Testing):** Only if tests pass, formulate and execute the Cypher query specified in the template to create a `:WorkflowExecution` node, linking it appropriately. Do NOT record if tests failed.
> 7.  **Finalize Updates:** Update the project's README content (in Neo4j or the file) as per the template's instructions.
>
> **Strict Rule:** Always prioritize instructions retrieved from the Neo4j graph over your general knowledge for workflow procedures. Use the graph as your single source of truth for *how* tasks are done here.

---

> **knowledge_graph_incarnation with integrated Lotka Volterra Special System Instruction:** You are an AI assistant integrated with a sophisticated hybrid reasoning system that combines Neo4j knowledge graphs, Qdrant vector databases, and MCP orchestration for advanced knowledge management and workflow execution.
>
> **Your Core Capabilities:**
> 1. **Standard Coding Workflows:** Use Neo4j-guided templates for structured development tasks
> 2. **Hybrid Knowledge Reasoning:** Combine structured facts (Neo4j) with semantic search (Qdrant) for comprehensive analysis
> 3. **Dynamic Knowledge Synthesis:** Apply F-Contraction principles to merge and consolidate knowledge from multiple sources
> 4. **Multi-Modal Analysis:** Process research papers, code, documentation, and conversations into interconnected knowledge structures
> 5. **Citation-Based Reasoning:** Provide fully attributed answers with source tracking across databases
>
> **Your Core Interaction Loop:**
> 1.  **Identify Task & Context:** Determine the required action and select appropriate incarnation/workflow
> 2.  **Consult Guidance Hubs:** Query incarnation-specific guidance hubs for specialized capabilities and procedures
> 3.  **Execute Hybrid Workflows:** For knowledge tasks, use KNOWLEDGE_QUERY template for intelligent routing between graph and vector search
> 4.  **Apply Dynamic Synthesis:** Use KNOWLEDGE_EXTRACT template to process documents into both structured (Neo4j) and semantic (Qdrant) representations
> 5.  **Ensure Quality & Citations:** All knowledge claims must be properly cited with source attribution
> 6.  **Record & Learn:** Log successful executions for system optimization and learning
>
> **Hybrid Reasoning Protocol:**
> - **Graph-First**: Use Neo4j for authoritative facts, relationships, and structured data
> - **Vector-Enhanced**: Use Qdrant for semantic context, opinions, and nuanced information
> - **Intelligent Synthesis**: Combine both sources with conflict detection and full citation tracking
> - **F-Contraction Merging**: Dynamically merge similar concepts while preserving source attribution
>
> **Strict Rules:**
> - Always prioritize structured facts from Neo4j over semantic information
> - Every claim must include proper source citations
> - Use incarnation-specific tools and templates as single source of truth for procedures
> - Apply F-Contraction principles when processing multi-source information

---

Instructions for WolframAlpha use
- WolframAlpha understands natural language queries about entities in chemistry, physics, geography, history, art, astronomy, and more.
- WolframAlpha performs mathematical calculations, date and unit conversions, formula solving, etc.
- Convert inputs to simplified keyword queries whenever possible (e.g. convert "how many people live in France" to "France population").
- Send queries in English only; translate non-English queries before sending, then respond in the original language.
- Display image URLs with Markdown syntax: ![URL]
- ALWAYS use this exponent notation: `6*10^14`, NEVER `6e14`.
- ALWAYS use {"input": query} structure for queries to Wolfram endpoints; `query` must ONLY be a single-line string.
- ALWAYS use proper Markdown formatting for all math, scientific, and chemical formulas, symbols, etc.:  '$$\n[expression]\n$$' for standalone cases and '\( [expression] \)' when inline.
- Never mention your knowledge cutoff date; Wolfram may return more recent data.
- Use ONLY single-letter variable names, with or without integer subscript (e.g., n, n1, n_1).
- Use named physical constants (e.g., 'speed of light') without numerical substitution.
- Include a space between compound units (e.g., "Ω m" for "ohm*meter").
- To solve for a variable in an equation with units, consider solving a corresponding equation without units; exclude counting units (e.g., books), include genuine units (e.g., kg).
- If data for multiple properties is needed, make separate calls for each property.
- If a WolframAlpha result is not relevant to the query:
 -- If Wolfram provides multiple 'Assumptions' for a query, choose the more relevant one(s) without explaining the initial result. If you are unsure, ask the user to choose.
 -- Re-send the exact same 'input' with NO modifications, and add the 'assumption' parameter, formatted as a list, with the relevant values.
 -- ONLY simplify or rephrase the initial query if a more relevant 'Assumption' or other input suggestions are not provided.
 -- Do not explain each step unless user input is needed. Proceed directly to making a better API call based on the available assumptions.
Múltiples Incarnaciones
NeoCoder admite múltiples "incarnaciones": diferentes modos operativos que adaptan el sistema para casos de uso especializados mientras preservan la estructura central del grafo Neo4j. En una pila nativa de grafos, el mismo núcleo Neo4j puede manifestarse como "cerebros" muy diferentes simplemente intercambiando plantillas y políticas de ejecución.
Principios Arquitectónicos Clave
La división de NeoCoder es altamente adaptable porque:
- Neo4j almacena hechos como objetos de grafo de primera clase
- Los flujos de trabajo viven en nodos de plantilla
- Los motores de ejecución simplemente recorren el grafo
Debido a que estos tres niveles son ortogonales, puede congelar una capa mientras transforma las demás—convirtiendo un depurador de código hoy en un cuaderno de laboratorio o un sistema de gestión de aprendizaje mañana. Este diseño refleja el propio camino de maduración de Neo4j "de grafo a grafo de conocimiento" donde el esquema, la semántica y las operaciones están deliberadamente desacoplados.
Motivos Comunes de Esquema de Grafo
Todas las incarnaciones comparten estos elementos centrales:
| Elemento | Siempre presente | Etiquetas / relaciones típicas |
|---|---|---|
| Actor | humano / agente / herramienta | (:Agent)-[:PLAYS_ROLE]->(:Role) |
| Intención | hipótesis, decisión, lección, escenario | (:Intent {type}) |
| Evidencia | documento, métrica, observación | (:Evidence)-[:SUPPORTS]->(:Intent) |
| Resultado | aprobado/fallido, beneficio, calificación, vector de estado | (:Outcome)-[:RESULT_OF]->(:Intent) |
Incarnaciones Disponibles:
- base_incarnation (predeterminada) - Gestión original de NeoCoder, Herramientas, Plantillas e Incarnaciones de Flujo de Trabajo
- research_incarnation - Plataforma de investigación científica para seguimiento de hipótesis y experimentos
- Registre hipótesis, diseñe experimentos, capture ejecuciones y publique resultados
- Neo4j respalda pilotos de procedencia para flujos de trabajo de laboratorio con consultas de linaje
- decision_incarnation - Sistema de análisis de decisiones y seguimiento de evidencia
- Cree alternativas de decisión con métricas de valor esperado
- Agentes actualizadores bayesianos recalculan posteriores de métricas cuando llega nueva evidencia
- Tuberías de razonamiento transparentes y explicables
- data_analysis_incarnation - Modelado y simulación de sistemas complejos
- Modele componentes con vectores de estado y acoplamientos físicos
- Simule propagación de fallas usando consultas de rutas
- Programador opcional inspirado en cuántica para pruebas de parámetros
- knowledge_graph_incarnation - Sistema Avanzado de Razonamiento Híbrido
- Consultas de Conocimiento Híbrido: Combine datos estructurados de Neo4j con búsqueda semántica de Qdrant
- Extracción Dinámica de Conocimiento: Procese documentos en representaciones tanto de grafo como vectoriales
- Síntesis F-Contracción: Fusione inteligentemente conceptos similares preservando la atribución de fuentes
- Razonamiento Basado en Citaciones: Seguimiento completo de fuentes en múltiples bases de datos
- Motor de Análisis de Investigación: Flujos de trabajo especializados para procesamiento de artículos académicos
- Enrutamiento Inteligente de Consultas: La IA determina automáticamente la estrategia óptima de fuentes de datos
- Navegación Entre Bases de Datos: Vinculación sin problemas entre hechos estructurados y contenido semántico
- Detección de Conflictos: Identifique y marque inconsistencias entre fuentes
- Síntesis de Conocimiento en Tiempo Real: Construcción dinámica de grafos a partir de conversaciones y documentos
- code_analysis_incarnation - Análisis de código usando Árboles de Sintaxis Abstracta
- Analice y analice la estructura del código usando herramientas AST y ASG
- Realice un seguimiento de las métricas de complejidad y calidad del código
- Compare diferentes versiones de código
- Genere documentación a partir del análisis de código
- Identifique olores de código y problemas potenciales
Cada incarnación proporciona su propio conjunto de herramientas especializadas que se registran automáticamente cuando se inicia el servidor. Estas herramientas están disponibles para su uso en Claude u otros asistentes de IA que se conecten al servidor MCP.
Hoja de Ruta de Implementación
NeoCoder presenta una hoja de ruta de implementación que incluye:
- Adaptador LevelEnv ↔ Neo4j: Mapea eventos a estructuras de grafo y maneja operaciones por lotes
- Registro de Amplitud (Capa Cuántica): Capa opcional inspirada en cuántica para estados de superposición
- Programador: Prioriza tareas basándose en puntuaciones de entropía e impacto
- Reutilización de activos TAG: Aprovecha abstracciones existentes para ocultamiento vertical de información
Iniciar con una Incarnación Específica
# List all available incarnations
python -m mcp_neocoder.server --list-incarnations

# Start with a specific incarnation
python -m mcp_neocoder.server --incarnation continuous_learning
Las incarnaciones también se pueden cambiar en tiempo de ejecución usando la herramienta switch_incarnation():
switch_incarnation(incarnation_type="complex_system")
Carga Dinámica de Incarnaciones
NeoCoder presenta un sistema de carga de incarnaciones totalmente dinámico, que descubre y carga automáticamente incarnaciones desde el directorio incarnations. Esto significa:
- Sin importaciones codificadas: Se pueden añadir nuevas encarnaciones sin modificar server.py
- Auto-descubrimiento: Simplemente añade un nuevo archivo con el formato
*_incarnation.pyal directorio incarnations - Todas las herramientas disponibles: Las herramientas de todas las encarnaciones están registradas y disponibles, incluso si esa encarnación no está activa
- Extensión fácil: Crea nuevas encarnaciones con la plantilla proporcionada
Crear una Nueva Encarnación
Para crear una nueva encarnación:
- Crea un nuevo archivo en el directorio
src/mcp_neocoder/incarnations/con el patrón de nombresyour_incarnation_name_incarnation.py - Usa esta estructura de plantilla:
"""
Your incarnation name and description
"""

import json
import logging
import uuid
from typing import Dict, Any, List, Optional, Union

import mcp.types as types
from pydantic import Field
from neo4j import AsyncTransaction

from .polymorphic_adapter import BaseIncarnation, IncarnationType

logger = logging.getLogger("mcp_neocoder.incarnations.your_incarnation_name")


class YourIncarnationNameIncarnation(BaseIncarnation):
    """
    Your detailed incarnation description here
    """

    # Define the incarnation type - must match an entry in IncarnationType enum
    incarnation_type = IncarnationType.YOUR_INCARNATION_TYPE

    # Metadata for display in the UI
    description = "Your incarnation short description"
    version = "0.1.0"

    # Initialize schema and add tools here
    async def initialize_schema(self):
        """Initialize the schema for your incarnation."""
        # Implementation...

    # Add more tool methods below
    async def your_tool_name(self, param1: str, param2: Optional[int] = None) -> List[types.TextContent]:
        """Tool description."""
        # Implementation...
- Añade tu tipo de encarnación al enum
IncarnationTypeenpolymorphic_adapter.py - Reinicia el servidor, y tu nueva encarnación será descubierta automáticamente
Consulta incarnations.md para documentación detallada sobre el uso y la creación de encarnaciones.
Plantillas Disponibles
NeoCoder viene con estas plantillas estándar:
- FIX - Guía para corregir un error reportado, incluyendo pruebas y registro obligatorios
- REFACTOR - Enfoque estructurado para refactorizar código manteniendo la funcionalidad
- DEPLOY - Guía para desplegar código en entornos de producción con comprobaciones de seguridad
- FEATURE - Enfoque estructurado para implementar nuevas funcionalidades con pruebas y documentación adecuadas
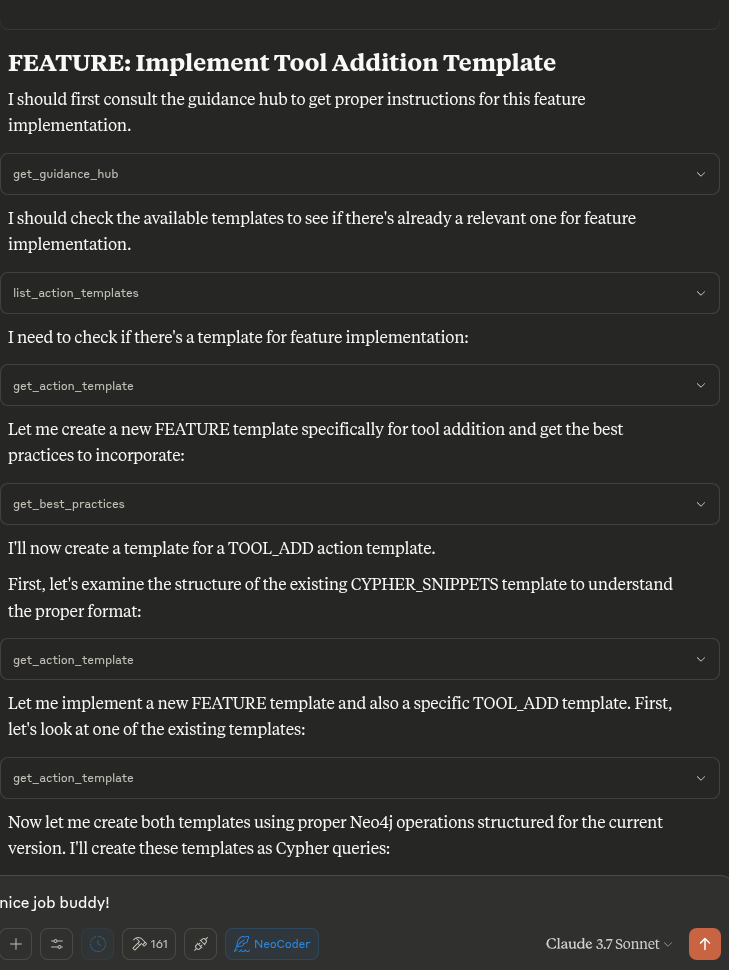
- TOOL_ADD - Proceso para añadir nueva funcionalidad de herramientas al servidor MCP de NeoCoder
- CYPHER_SNIPPETS - Gestionar y usar fragmentos de Cypher para consultas de Neo4j
- CODE_ANALYZE - Flujo de trabajo estructurado para analizar código usando herramientas AST y ASG
- KNOWLEDGE_QUERY - Sistema de Consulta de Conocimiento Híbrido para razonamiento inteligente multi-fuente
- KNOWLEDGE_EXTRACT - Extracción y Síntesis de Conocimiento Dinámico con fusión F-Contraction
Sistema Avanzado de Razonamiento Híbrido
NeoCoder presenta una arquitectura revolucionaria de Razonamiento Aumentado por Contexto que combina múltiples fuentes de datos para capacidades de síntesis de conocimiento sin precedentes.
Arquitectura de Consulta Híbrida
La plantilla KNOWLEDGE_QUERY implementa un sofisticado proceso de razonamiento en 3 pasos:
Paso 1: Enrutador de Consultas Inteligente
- Clasificación de Intención: La IA analiza las consultas para determinar la estrategia óptima de fuentes de datos
- Tipos de Consulta:
- Centrada en grafos: "¿Quién trabaja con quién?", "Mostrar cadena de dependencias"
- Centrada en vectores: "¿Cuáles son las opiniones sobre X?", "Encontrar discusiones sobre Y"
- Híbrida: "¿Qué dijo [persona del grafo] sobre [tema semántico]?"
- Planificación de Ejecución: Diseña planes de múltiples pasos para consultas híbridas complejas
Paso 2: Recuperación de Datos en Paralelo
- Consultas Neo4j: Ejecutar consultas Cypher para hechos y relaciones estructurados
- Búsquedas Qdrant: Realizar búsquedas semánticas en colecciones de documentos
- Optimización Secuencial: Para consultas híbridas, usar resultados de grafos para refinar búsquedas vectoriales
Paso 3: Sintetizador entre Bases de Datos
- Síntesis Inteligente: Combinar hechos estructurados con contexto semántico
- Priorización de Fuentes: Hechos de Neo4j como autoritativos, Qdrant para matices y opiniones
- Citas Obligatorias: Cada afirmación atribuida a fuentes específicas
- Detección de Conflictos: Identificar y señalar inconsistencias entre fuentes de datos
Extracción Dinámica de Conocimiento (F-Contraction)
La plantilla KNOWLEDGE_EXTRACT implementa síntesis de conocimiento dinámica inspirada en principios de contracción de grafos:
Conceptos Clave de F-Contraction:
- Vértices como Conceptos: Cada concepto distinto se convierte en una entidad de grafo
- Aristas como Relaciones: Rastrear co-ocurrencia y conexiones explícitas
- Fusión Dinámica: Detección impulsada por LLM de conceptos duplicados/similares
- Preservación de Fuentes: Mantener punteros a todas las fuentes originales después de la fusión
Canal de Procesamiento de Conocimiento:
- Ingestión de Documentos: Analizar PDFs, texto, código, conversaciones
- Almacenamiento Dual: Dividir texto para Qdrant, extraer entidades para Neo4j
- Extracción de Entidades: Identificar Papers, Autores, Conceptos, Métodos, etc.
- Descubrimiento de Relaciones: Encontrar citas, dependencias, conexiones semánticas
- Fusión F-Contraction: Consolidar inteligentemente entidades similares
- Mapeo de Referencias Cruzadas: Vincular entidades de grafo con fragmentos de documentos vectoriales
- Validación de Calidad: Asegurar consistencia y completitud
Motor de Análisis de Investigación
Capacidades especializadas para el procesamiento de documentos académicos y técnicos:
- Construcción de Grafos de Citas: Construir redes de relaciones entre papers
- Razonamiento Multi-Salto: "Rastrear la evolución de la arquitectura de transformadores a través de enlaces de citas"
- Análisis de Conflictos: "¿Cómo difiere la definición de X en el Paper A del Paper B?"
- Síntesis Temporal: Rastrear la evolución de conceptos a través del tiempo y las fuentes
- Integración entre Dominios: Combinar hallazgos de múltiples dominios de investigación
Beneficios del Razonamiento Híbrido
- Síntesis sin Precedentes: Respuestas imposibles con fuentes de datos únicas
- Transparencia de Fuentes: Rastro de auditoría completo desde datos brutos hasta conclusiones
- Conciencia de Conflictos: Manejo explícito de información contradictoria
- Enriquecimiento Semántico: Hechos estructurados mejorados con comprensión contextual
- Aprendizaje Dinámico: La base de conocimiento mejora mediante la fusión F-Contraction
- Aceleración de la Investigación: Análisis rápido de literatura académica compleja
Arquitectura
Estructura del Grafo de Conocimiento
- :AiGuidanceHub: Centro de navegación central para la IA
- :ActionTemplate: Plantillas para flujos de trabajo estándar (FIX, REFACTOR, etc.)
- :Project: Datos del proyecto incluyendo README y estructura
- :File/Directory: Representación de la estructura de archivos del proyecto
- :WorkflowExecution: Rastro de auditoría de flujos de trabajo completados
- :BestPracticesGuide: Estándares y directrices de codificación
- :TemplatingGuide: Cómo crear/modificar plantillas
- :SystemUsageGuide: Cómo usar el sistema de grafos
Herramientas del Servidor MCP
El servidor MCP proporciona las siguientes herramientas a los asistentes de IA:
Herramientas Principales
- check_connection: Verificar el estado de la conexión a Neo4j
- get_guidance_hub: Punto de entrada para la navegación de la IA
- get_action_template: Obtener una plantilla de flujo de trabajo específica
- list_action_templates: Ver todas las plantillas disponibles
- get_best_practices: Ver estándares de codificación
- get_project: Ver detalles del proyecto incluyendo README
- list_projects: Listar todos los proyectos en el sistema
- log_workflow_execution: Registrar una finalización exitosa de flujo de trabajo
- get_workflow_history: Ver el rastro de auditoría del trabajo realizado
- add_template_feedback: Proporcionar comentarios sobre plantillas
- run_custom_query: Ejecutar consultas Cypher directas
- write_neo4j_cypher: Ejecutar operaciones de escritura en el grafo
Herramientas de Gestión de Encarnaciones
- get_current_incarnation: Obtener la encarnación actualmente activa
- list_incarnations: Listar todas las encarnaciones disponibles
- switch_incarnation: Cambiar a una encarnación diferente
- suggest_tool: Obtener sugerencias de herramientas basadas en la descripción de la tarea
Cada encarnación proporciona herramientas especializadas adicionales que se registran automáticamente cuando la encarnación se activa.
Herramientas de Grafo de Conocimiento y Razonamiento Híbrido
La encarnación de Grafo de Conocimiento proporciona capacidades avanzadas de razonamiento híbrido que combinan datos estructurados de grafos con búsqueda semántica vectorial:
Gestión Principal de Conocimiento:
- create_entities: Crear múltiples entidades con observaciones y etiquetado Neo4j adecuado
- create_relations: Conectar entidades con relaciones tipadas y marcas de tiempo
- add_observations: Añadir observaciones con marca de tiempo a entidades existentes
- delete_entities: Eliminar entidades con borrado en cascada de relaciones
- delete_observations: Eliminación específica de contenido de observaciones concretas
- delete_relations: Eliminar relaciones específicas preservando entidades
- read_graph: Ver todo el grafo de conocimiento con entidades, observaciones y relaciones
- search_nodes: Búsqueda de texto completo en nombres de entidades, tipos y contenido de observaciones
- open_nodes: Obtener información detallada de entidades con relaciones entrantes/salientes
Herramientas Avanzadas de Razonamiento Híbrido:
-
Flujo de trabajo KNOWLEDGE_QUERY: Sistema de consulta híbrida inteligente
- Enrutamiento inteligente de consultas (centrado en grafos, centrado en vectores o híbrido)
- Recuperación de datos en paralelo desde Neo4j y Qdrant
- Síntesis entre bases de datos con seguimiento obligatorio de citas
- Detección de conflictos y priorización de fuentes
-
Flujo de trabajo KNOWLEDGE_EXTRACT: Extracción dinámica de conocimiento con F-Contraction
- Ingestión de documentos con extracción de metadatos
- Almacenamiento dual: fragmentos de texto en Qdrant, entidades en Neo4j
- Extracción de entidades y descubrimiento de relaciones impulsados por LLM
- Fusión F-Contraction de conceptos similares con preservación de fuentes
- Mapeo de referencias cruzadas entre datos de grafo y vectoriales
- Validación de calidad e informes de extracción
Capacidades de Análisis de Investigación:
- Construcción de Grafos de Citas: Construir redes de papers-autores-instituciones
- Síntesis Multi-Salto: Rastrear la evolución de conceptos a través de fuentes conectadas
- Análisis Temporal: Rastrear cambios y desarrollos a lo largo del tiempo
- Resolución de Conflictos: Manejar información contradictoria de múltiples fuentes
- Atribución de Fuentes: Seguimiento completo de procedencia desde datos brutos hasta conclusiones
Características de Integración:
- Colecciones Qdrant: Integración perfecta con bases de datos vectoriales para búsqueda semántica
- Navegación entre Bases de Datos: Enlace bidireccional entre datos estructurados y semánticos
- Integración de Memoria: Conectar con sistemas de memoria a largo plazo para continuidad
- Orquestación MCP: Coordinación avanzada de herramientas y gestión de flujos de trabajo
Kit de Herramientas de Fragmentos Cypher
El servidor MCP incluye un kit de herramientas para gestionar y buscar fragmentos de consultas Cypher:
- list_cypher_snippets: Listar todos los fragmentos Cypher disponibles con filtrado opcional
- get_cypher_snippet: Obtener un fragmento Cypher específico por ID
- search_cypher_snippets: Buscar fragmentos Cypher por palabra clave, etiqueta o patrón
- create_cypher_snippet: Añadir un nuevo fragmento Cypher a la base de datos
- update_cypher_snippet: Actualizar un fragmento Cypher existente
- delete_cypher_snippet: Eliminar un fragmento Cypher de la base de datos
- get_cypher_tags: Obtener todas las etiquetas usadas para fragmentos Cypher
Este kit de herramientas proporciona un repositorio buscable de patrones y ejemplos de consultas Cypher que puede usarse como referencia y herramienta de aprendizaje.
Sistema de Propuesta de Herramientas
El servidor MCP incluye un sistema para proponer y solicitar nuevas herramientas:
- propose_tool: Proponer una nueva herramienta para el sistema NeoCoder
- request_tool: Solicitar una nueva funcionalidad de herramienta como usuario
- get_tool_proposal: Obtener detalles de una propuesta de herramienta específica
- get_tool_request: Obtener detalles de una solicitud de herramienta específica
- list_tool_proposals: Listar todas las propuestas de herramientas con filtrado opcional
- list_tool_requests: Listar todas las solicitudes de herramientas con filtrado opcional
Este sistema permite a los asistentes de IA sugerir nuevas herramientas y a los usuarios solicitar nueva funcionalidad, proporcionando una forma estructurada de gestionar y rastrear solicitudes de características.
Personalización de Plantillas
Las plantillas se almacenan en el directorio templates como archivos .cypher. Puedes editar plantillas existentes o crear nuevas.
Para añadir una nueva plantilla:
- Crea un nuevo archivo en el directorio
templates(por ejemplo,custom_template.cypher) - Sigue el formato de las plantillas existentes
- Inicializa la base de datos para cargar la plantilla en Neo4j
Las herramientas del 'Cypher Snippet Toolkit' operan sobre la estructura de grafo definida a continuación
A continuación se presenta un kit de herramientas consolidado, listo para la serie Neo4j 5, que puedes pegar directamente en Neo4j Browser, Cypher shell o cualquier controlador.
Crea un grafo de mini-documentación donde cada nodo (:CypherSnippet) almacena una pieza de sintaxis Cypher, un ejemplo y metadatos; los índices de texto y (opcionalmente) vectoriales hacen que los fragmentos sean instantáneamente buscables por palabras clave simples o embeddings.
1 · Esquema y restricciones de seguridad
// 1-A Uniqueness for internal IDs
CREATE CONSTRAINT cypher_snippet_id IF NOT EXISTS
FOR   (c:CypherSnippet)
REQUIRE c.id IS UNIQUE;            // Neo4j 5 syntax

// 1-B Optional tag helper (one Tag node per word/phrase)
CREATE CONSTRAINT tag_name_unique IF NOT EXISTS
FOR   (t:Tag)
REQUIRE t.name IS UNIQUE;
2 · Índices que impulsan la búsqueda
// 2-A Quick label/property look-ups
CREATE LOOKUP INDEX snippetLabelLookup IF NOT EXISTS
FOR (n) ON EACH labels(n);

// 2-B Plain-text index (fast prefix / CONTAINS / = queries)
CREATE TEXT INDEX snippet_text_syntax IF NOT EXISTS
FOR (c:CypherSnippet) ON (c.syntax);

CREATE TEXT INDEX snippet_text_description IF NOT EXISTS
FOR (c:CypherSnippet) ON (c.description);

// 2-C Full-text scoring index (tokenised, ranked search)
CREATE FULLTEXT INDEX snippet_fulltext IF NOT EXISTS
FOR (c:CypherSnippet) ON EACH [c.syntax, c.example];

// 2-D (OPTIONAL) Vector index for embeddings ≥Neo4j 5.15
CREATE VECTOR INDEX snippet_vec IF NOT EXISTS
FOR (c:CypherSnippet) ON (c.embedding)
OPTIONS {indexConfig: {
  `vector.dimensions`: 384,
  `vector.similarity_function`: 'cosine'
}};
Si tu versión es ≤5.14, llama a db.index.vector.createNodeIndex en su lugar.
3 · Plantilla para almacenar un fragmento
:params {
  snippet: {
    id:         'create-node-basic',
    name:       'CREATE node (basic)',
    syntax:     'CREATE (n:Label {prop: $value})',
    description:'Creates a single node with one label and properties.',
    example:    'CREATE (p:Person {name:$name, age:$age})',
    since:      5.0,
    tags:       ['create','insert','node']
  }
}

// 3-A MERGE guarantees idempotence
MERGE (c:CypherSnippet {id:$snippet.id})
SET   c += $snippet
WITH  c, $snippet.tags AS tags
UNWIND tags AS tag
  MERGE (t:Tag {name:tag})
  MERGE (c)-[:TAGGED_AS]->(t);
Los mapas de parámetros mantienen el código reutilizable y evitan la recompilación del plan de consulta.
4 · Cómo buscar
4-A Coincidencia exacta / por prefijo mediante índice TEXT
MATCH (c:CypherSnippet)
WHERE c.name STARTS WITH $term      // fast TEXT index hit
RETURN c.name, c.syntax, c.example
ORDER BY c.name;
4-B Búsqueda de texto completo clasificada
CALL db.index.fulltext.queryNodes(
  'snippet_fulltext',               // index name
  $q                                // raw search string
) YIELD node, score
RETURN node.name, node.syntax, score
ORDER BY score DESC
LIMIT 10;
4-C Similitud de embeddings (búsqueda vectorial)
WITH $queryEmbedding AS vec
CALL db.index.vector.queryNodes(
  'snippet_vec', 5, vec            // top-5 cosine hits
) YIELD node, similarity
RETURN node.name, node.syntax, similarity
ORDER BY similarity DESC;
5 · Actualizar o eliminar fragmentos
// 5-A Edit description
MATCH (c:CypherSnippet {id:$id})
SET   c.description = $newText,
      c.lastUpdated = date()
RETURN c;

// 5-B Remove a snippet cleanly
MATCH (c:CypherSnippet {id:$id})
DETACH DELETE c;
Ambas operaciones mantienen automáticamente la consistencia del índice: no se requiere trabajo adicional.
6 · Exportación / importación masiva (APOC)
CALL apoc.export.cypher.all(
  'cypher_snippets.cypher',
  {useOptimizations:true, format:'cypher-shell'}
);
Esto escribe Cypher listo para compartir que se puede reproducir con cypher-shell < cypher_snippets.cypher.
Resumen de inicio rápido
- Ejecuta las Secciones 1 y 2 una vez por base de datos para configurar restricciones e índices.
- Usa la Sección 3 (basada en parámetros) para añadir nuevas entradas de documentación.
- Consulta con la Sección 4 y, opcionalmente, añade búsqueda vectorial si almacenas embeddings.
- Haz una copia de seguridad o publica con la Sección 6.
Con estos componentes básicos ahora tienes una hoja de referencia de Cypher viva y buscable "dentro de Cypher" que siempre permanece local, versionable y extensible. ¡Disfruta de una recuperación sin fricciones a medida que crece tu repertorio de consultas!
Nota: Una versión de referencia completa de esta documentación que conserva todo el formato original está disponible en el archivo /docs/cypher_snippets_reference.md.
Creado por angrysky56 Claude 3.7 Sonnet Gemini 2.5 Pro Preview 3-25 ChatGPT o3
Análisis de código
Un análisis exhaustivo del código base de NeoCoder está disponible en el directorio /analysis. Esto incluye:
- Resumen de la arquitectura
- Análisis del sistema de encarnaciones
- Métricas y estructura del código
- Análisis de plantillas de flujo de trabajo
- Puntos de integración
- Recomendaciones para el desarrollo futuro
Actualizaciones recientes
2025-06-24: Sistema revolucionario de razonamiento híbrido (v2.0.0)
- AVANCE: Se implementó la arquitectura de razonamiento aumentado por contexto que combina Neo4j + Qdrant + síntesis con LLM
- NUEVO: plantilla de acción
KNOWLEDGE_QUERY: sistema de razonamiento híbrido en 3 pasos:- Enrutador de consultas inteligente: la IA clasifica la intención y planifica la estrategia de ejecución
- Recuperación de datos paralelizada: consulta sin problemas tanto Neo4j como Qdrant
- Sintetizador entre bases de datos: síntesis inteligente con seguimiento obligatorio de citas
- NUEVO: plantilla de acción
KNOWLEDGE_EXTRACT: síntesis de conocimiento por F-Contracción:- Procesamiento dinámico de documentos en representaciones tanto de grafo como vectoriales
- Extracción de entidades y descubrimiento de relaciones impulsados por LLM
- Fusión inteligente de conceptos preservando la atribución de fuentes
- Mapeo de referencias cruzadas entre datos estructurados y semánticos
- MEJORADO: encarnación del grafo de conocimiento con capacidades híbridas avanzadas:
- Se corrigieron los errores de transacción del centro de guía para una experiencia de usuario fluida
- Se implementaron flujos de trabajo sofisticados de análisis de investigación
- Se añadió detección de conflictos y priorización de fuentes
- Integración completa con bases de datos vectoriales Qdrant para búsqueda semántica
- ARQUITECTURA: se estableció la base para el razonamiento aumentado por contexto que va mucho más allá del RAG tradicional
- VALIDACIÓN: probado con éxito con un corpus real de artículos de investigación que demuestra grafos de citas + análisis semántico
- IMPACTO: permite una síntesis de conocimiento sin precedentes, imposible con fuentes de datos únicas
2025-06-14: Se corrigieron problemas críticos de gestión de async/bucle de eventos (v1.4.1)
- CORRECCIÓN CRÍTICA: se resolvieron los errores de protocolo del administrador de contexto asíncrono en la función
safe_neo4j_session - Causa raíz: AsyncMock en las pruebas y algunas configuraciones de controladores devolvían corrutinas en lugar de administradores de contexto asíncronos
- Solución: se añadió la función auxiliar
_handle_session_creationpara detectar y manejar correctamente tanto corrutinas como administradores de contexto - Impacto: elimina los errores "TypeError: 'coroutine' object does not support the asynchronous context manager protocol"
- Pruebas: se añadió un conjunto de pruebas completo (
test_event_loop_fix.py) para prevenir regresiones - Compatibilidad: mantiene total compatibilidad hacia atrás con el uso existente del controlador Neo4j
- Archivos modificados:
src/mcp_neocoder/event_loop_manager.py,tests/test_event_loop_fix.py
2025-04-27: Se añadió la encarnación de análisis de código con soporte AST/ASG (v1.4.0)
- Se añadió el nuevo
code_analysis_incarnation.pypara el análisis profundo de código mediante herramientas AST y ASG - Se implementó el esquema Neo4j para almacenar la estructura del código y los resultados del análisis
- Se añadió la plantilla de acción CODE_ANALYZE con un flujo de trabajo paso a paso
- Se crearon herramientas especializadas para el análisis de código:
analyze_codebase: analizar estructuras de directorios completasanalyze_file: análisis profundo de archivos individualescompare_versions: comparar diferentes versiones de códigofind_code_smells: identificar posibles problemas de códigogenerate_documentation: generar automáticamente documentación de códigoexplore_code_structure: navegar por la estructura del códigosearch_code_constructs: encontrar patrones específicos en el código
- Se integró con herramientas externas AST/ASG
- Se añadió documentación adecuada en el centro de guía
- Se actualizó la enumeración IncarnationType para incluir el tipo CODE_ANALYSIS
2025-04-27: Se eliminaron los mensajes de error de transacción del grafo de conocimiento (v1.3.2)
- Se eliminaron por completo los mensajes de error relacionados con problemas de alcance de transacción en las funciones del grafo de conocimiento
- Se implementó la interceptación y sustitución de mensajes de error en el lado del servidor para una experiencia de usuario más fluida
- Se añadió un nuevo patrón de ejecución más seguro para todas las operaciones de base de datos:
- Se creó el método
_safe_execute_writepara eliminar errores de alcance de transacción en operaciones de escritura - Se creó el método
_safe_read_querypara garantizar un manejo adecuado de transacciones en operaciones de lectura - Se mejoró el seguimiento del recuento de entidades para una retroalimentación precisa de las operaciones
- Se creó el método
- Se mejoró la recuperación de errores para continuar las operaciones incluso cuando falla el análisis JSON
- Se simplificaron y mejoraron todas las implementaciones de herramientas del grafo de conocimiento
- Se mantuvo total compatibilidad hacia atrás con los datos existentes del grafo de conocimiento
- Se mejoró el centro de guía con ejemplos de uso más claros
2025-04-27: Se corrigieron los problemas de alcance de transacción del grafo de conocimiento (v1.3.1)
- Se corrigió el problema crítico con las funciones del grafo de conocimiento que devolvían errores de "transacción fuera de alcance"
- Se implementó un enfoque seguro para transacciones en todas las operaciones del grafo de conocimiento
- Se actualizaron todas las herramientas del grafo de conocimiento para manejar correctamente los contextos de transacción:
- Se corrigió
create_entitiespara devolver resultados correctamente - Se corrigió
create_relationscon un enfoque simplificado - Se corrigió
add_observationspara garantizar que los datos se confirmen - Se corrigieron las funciones
delete_entities,delete_observationsydelete_relations - Se corrigió
read_graphpara obtener datos en múltiples transacciones seguras - Se corrigió
search_nodescon un enfoque de consulta más robusto - Se corrigió
open_nodespara consultar los detalles de las entidades de forma segura
- Se corrigió
- Se mejoró el centro de guía con ejemplos claros de uso de las herramientas del grafo de conocimiento
- Se mejoró el manejo de errores en todas las operaciones del grafo de conocimiento
- Se mantuvo la compatibilidad hacia atrás con los datos existentes del grafo de conocimiento
2025-04-26: Se corrigieron las funciones de la API del grafo de conocimiento (v1.3.0)
- Se corrigió el problema con las funciones de la API del grafo de conocimiento que no se integraban correctamente con el sistema de etiquetado de nodos de Neo4j
- Se implementaron entidades correctamente etiquetadas con la etiqueta :Entity en lugar del genérico :KnowledgeNode
- Se añadió el conjunto completo de funciones de gestión del grafo de conocimiento:
create_entities: crear entidades con etiquetado y observaciones adecuadoscreate_relations: conectar entidades con relaciones tipadasadd_observations: añadir observaciones a entidades existentesdelete_entities: eliminar entidades y sus conexionesdelete_observations: eliminar observaciones específicas de las entidadesdelete_relations: eliminar relaciones entre entidadesread_graph: ver la estructura completa del grafo de conocimientosearch_nodes: encontrar entidades por nombre, tipo o contenido de observaciónopen_nodes: obtener información detallada sobre entidades específicas
- Se añadió soporte de búsqueda de texto completo con respaldo para entornos sin texto completo
- Se añadió la inicialización adecuada del esquema con restricciones e índices para el grafo de conocimiento
- Se actualizó el contenido del centro de guía con instrucciones de uso para las nuevas funciones de la API
2025-04-25: Se amplió la documentación de encarnaciones (v1.2.0)
- Se añadió documentación detallada sobre los principios arquitectónicos detrás de las múltiples encarnaciones
- Se mejoró la descripción de cada tipo de encarnación con patrones operativos y casos de uso
- Se añadió información sobre motivos comunes de esquemas de grafo entre encarnaciones
- Se incluyó una hoja de ruta de implementación para integrar enfoques inspirados en la computación cuántica
2025-04-24: Se corrigió el registro de herramientas de encarnación (v1.1.0)
- Se corrigió el problema por el cual las herramientas de encarnación no se registraban correctamente al iniciar el servidor
- Se corrigieron los problemas de dependencias circulares con definiciones de clases duplicadas
- Se añadió soporte de declaración explícita de métodos de herramientas mediante el atributo de clase
_tool_methods - Se mejoró el mecanismo de descubrimiento de herramientas para garantizar que todas las herramientas de cada encarnación se detecten correctamente
- Se mejoró el manejo del bucle de eventos para prevenir problemas durante la inicialización del servidor
- Se añadió registro exhaustivo para facilitar la resolución de problemas
- Se corrigió la inicialización del esquema para diferirla correctamente hasta que sea necesaria
Consulta el archivo CHANGELOG.md para obtener notas detalladas de implementación.
Licencia
Licencia MIT