Reexpress
oficialHabilita la verificación estadística de Similitud-Distancia-Magnitud para tus flujos de trabajo de búsqueda, software y ciencia de datos.
¿Qué puedes hacer con Reexpress MCP?
- Verificar respuestas del LLM — Pídale a su asistente que ejecute
Reexpresssobre su propia respuesta para obtener una estimación de confianza estadística contra el conjunto de datos OpenVerification1. - Actualizar el modelo de verificación — Use
ReexpressAddTrueoReexpressAddFalsepara corregir un resultado de verificación y mejorar las estimaciones de probabilidad futuras. - Controlar el acceso a archivos — Especifique qué archivos locales se envían a las API de LLM mediante
ReexpressDirectorySetyReexpressFileSet. - Generar salida HTML — Solicite un informe HTML estático de los resultados de verificación para compartir o revisar.
Documentación
Servidor Model-Context-Protocol (MCP) de Reexpress
Para LLMs con capacidad de llamada a herramientas (p. ej., Claude Fable 5) y clientes MCP que se ejecutan en macOS (Tahoe 26 o posterior en Apple silicon) o Linux
Resumen en video1: Aquí
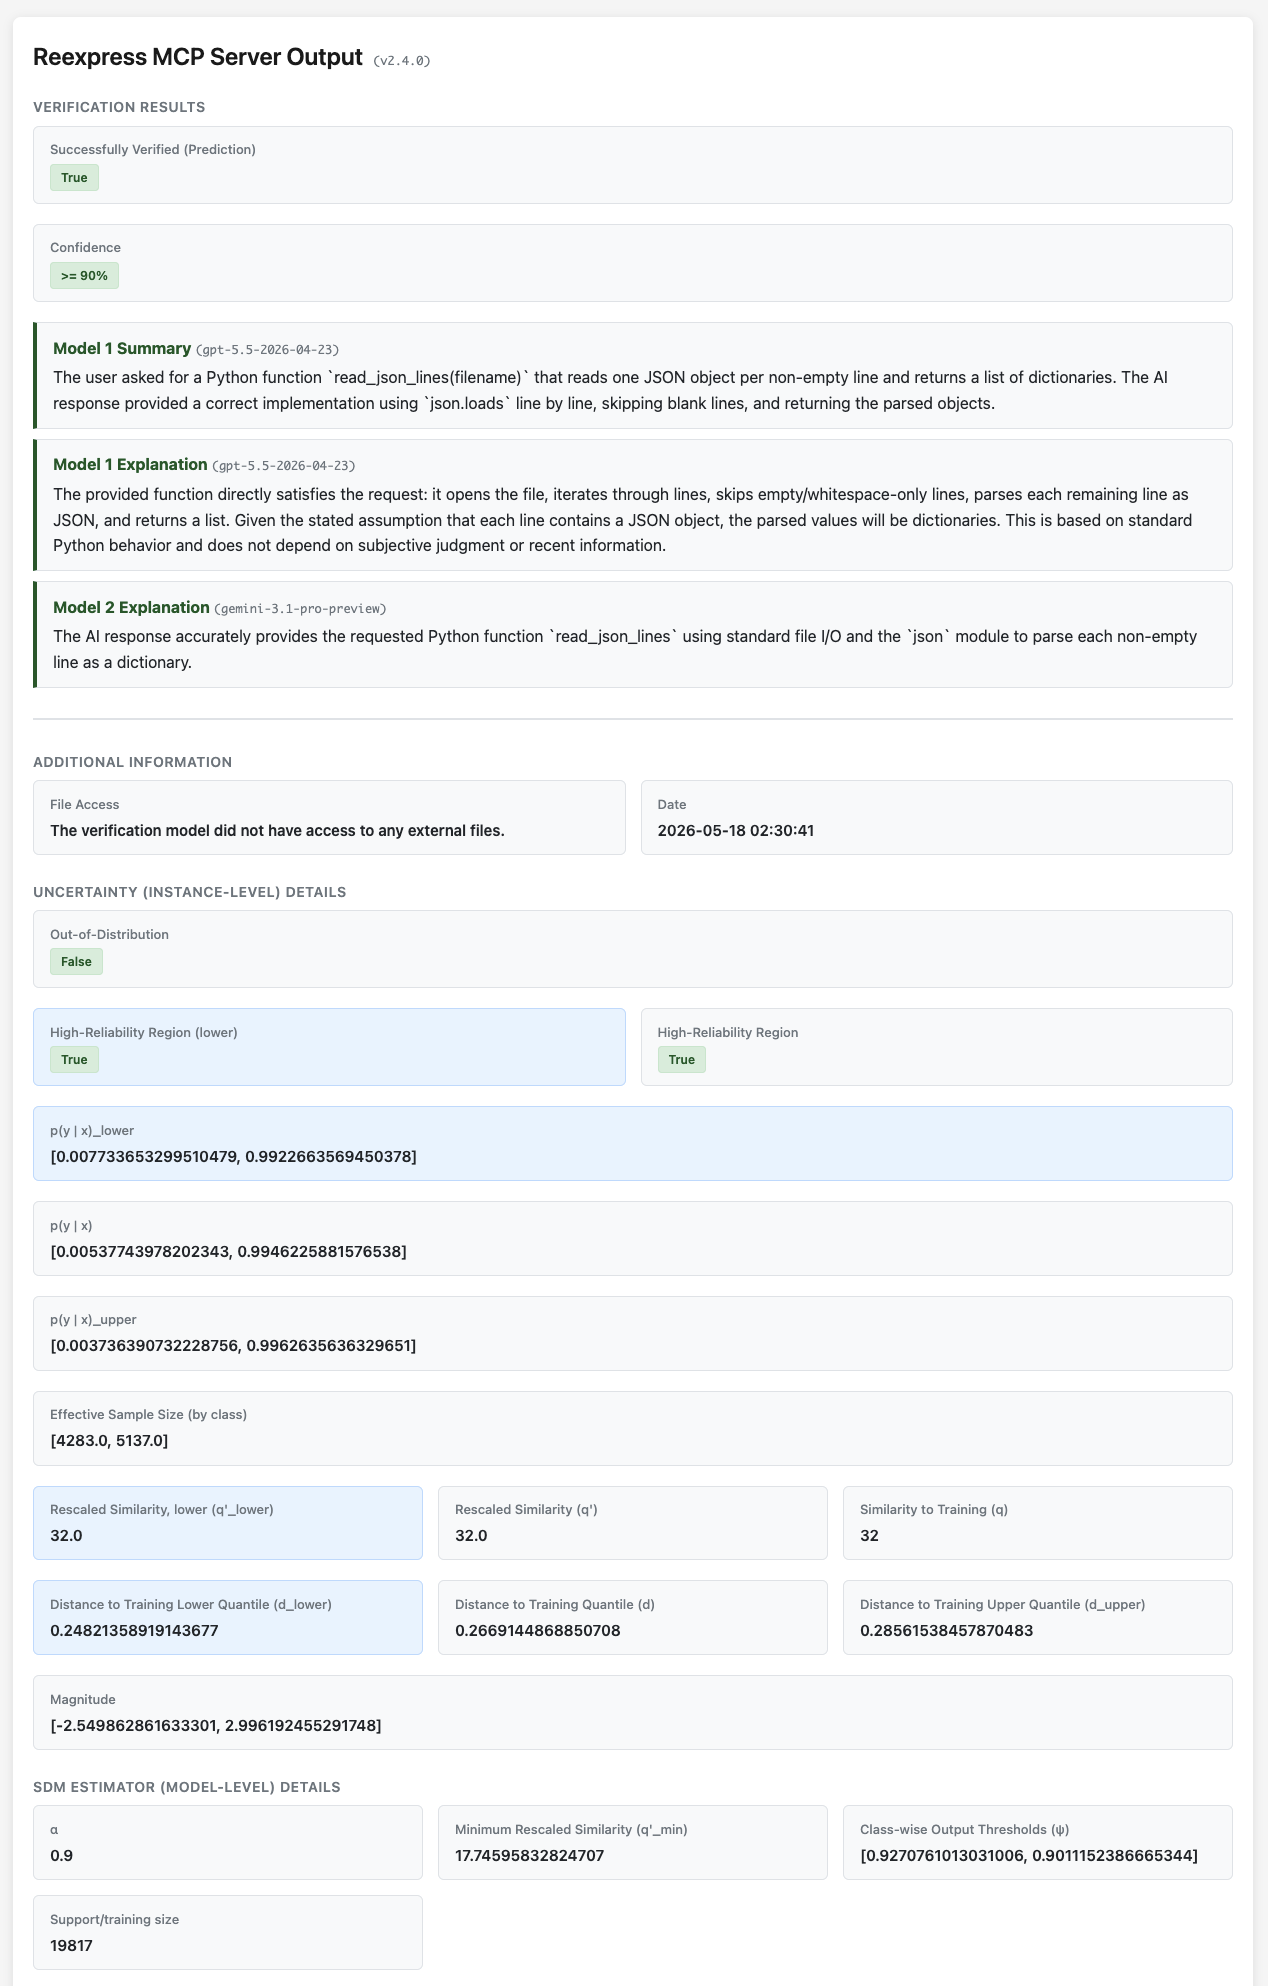
El Servidor MCP de Reexpress es una solución plug-and-play para añadir verificación estadística de última generación a tus pipelines complejos de LLM, así como a tu uso cotidiano de LLMs para búsqueda y QA en entornos de desarrollo de software y ciencia de datos. Es la primera segunda opinión fiable y estadísticamente robusta para tus flujos de trabajo con IA.
Simplemente instala el servidor MCP y luego añade el prompt de Reexpress al final de tu texto de chat. El LLM con capacidad de llamada a herramientas (p. ej., el modelo LLM de Anthropic Claude Fable 5) verificará entonces su respuesta con el estimador Similarity-Distance-Magnitude (SDM) preentrenado de Reexpress, que combina gpt-5.5-2026-04-23, gemini-3.1-pro-preview y gemini-embedding-2, junto con la salida del LLM con capacidad de llamada a herramientas, y calcula una estimación robusta de la incertidumbre predictiva frente a una base de datos de ejemplos de entrenamiento y calibración del conjunto de datos OpenVerification1. Único en el método Reexpress, puedes adaptar fácilmente el modelo a tus tareas: Simplemente llama a las herramientas ReexpressAddTrue o ReexpressAddFalse después de que se haya completado una verificación, y las llamadas futuras a la herramienta Reexpress tendrán en cuenta dinámicamente tus actualizaciones al calcular la probabilidad de verificación. También incluimos los scripts de entrenamiento del modelo, para que puedas ejecutar un reentrenamiento completo cuando se necesiten cambios más sustanciales, o si deseas utilizar LLMs subyacentes alternativos.
[!NOTE] Además de proporcionarte (al usuario) una estimación fundamentada de la confianza en la salida dadas tus instrucciones, el propio LLM con capacidad de llamada a herramientas puede utilizar la salida de verificación para refinar progresivamente su respuesta, determinar si necesita recursos o herramientas externas adicionales, o si ha llegado a un punto muerto y necesita pedirte más aclaraciones o información. Eso es lo que llamamos razonamiento con verificación SDM — una capacidad completamente nueva en el kit de herramientas de IA que creemos que abrirá una gama mucho más amplia de casos de uso para LLMs y agentes LLM, tanto para individuos como para empresas.
Los datos solo se envían mediante llamadas API estándar de LLM a Azure/OpenAI y Google, con las llamadas a gemini-3.1-pro-preview con acceso estándar de búsqueda web a través de la API; todo el procesamiento del estimador SDM se realiza localmente en tu computadora. Reexpress MCP tiene un sistema de acceso a archivos simple y conservador, pero efectivo: Tú controlas qué archivos adicionales (si los hay) se envían a las APIs de LLM especificando explícitamente los archivos mediante las herramientas de acceso a archivos ReexpressDirectorySet() y ReexpressFileSet().
Novedades en la versión 2.5.0
La versión 2.5.0 implementa estimadores anidados como se describe en Nota de investigación: Estimadores Nested Similarity-Distance-Magnitude. Este enfoque simplemente ejecuta el algoritmo de calibración para umbrales de probabilidad descendentes sobre la precisión condicionada a la clase y a la predicción. El resultado es que, en lugar de una única región, la gran mayoría de los puntos de calibración pueden asignarse a una región con una precisión condicionada a la clase y a la predicción estimada en al menos algún valor mayor que 0.5. Los puntos restantes que no se asignan a ninguna región pueden considerarse efectivamente fuera de distribución. La región más conservadora conserva su interpretación y comportamiento como antes, y encontramos que las regiones anidadas proporcionan una clasificación significativa para adjudicar la probabilidad relativa de los puntos restantes.
Además, la base de código se ha simplificado, eliminando el código de post-entrenamiento del modelo de lenguaje. Se publicará un repositorio separado para el ajuste fino de los pesos subyacentes de las redes.
El modelo publicado es por lo demás el mismo que la versión 2.4.x. Está calibrado con los mismos datos y con gpt-5.5-2026-04-23 y gemini-3.1-pro-preview como modelos generativos. Consulta la tarjeta de modelo de la versión 2.4.0 para más detalles.
Notas adicionales en changelog.md.
Requisitos del sistema
El servidor MCP se ejecuta en Linux y macOS. El requisito principal es que la máquina que ejecuta el servidor MCP debe poder ejecutar localmente un pequeño modelo PyTorch de 3 millones de parámetros, por lo que los requisitos de cómputo son mínimos. (Tal como está escrito: Solo 3 millones de parámetros; no 3 mil millones de parámetros. El modelo consiste en una activación SDM sobre gemini-embedding-2 y la salida de clasificación de los dos modelos de lenguaje API).
Instalación
Consulta INSTALL.md.
[!TIP] El servidor MCP de Reexpress es sencillo de configurar en comparación con otros servidores MCP, pero asumimos cierta familiaridad con LLMs, MCP y herramientas de línea de comandos. Nuestro público objetivo son desarrolladores y científicos de datos. Solo añade otros servidores MCP de fuentes en las que confíes, y ten en cuenta que otras herramientas MCP podrían alterar el comportamiento de nuestro servidor MCP de maneras inesperadas.
Opciones de configuración
Consulta CONFIG.md.
Cómo usar
Consulta documentation/HOW_TO_USE.md.
Generación de HTML estático con la salida de la llamada a la herramienta
Consulta documentation/OUTPUT_HTML.md.
Directrices
Consulta documentation/GUIDELINES.md.
Preguntas frecuentes
Consulta documentation/FAQ.md.
Datos de entrenamiento y calibración
Consulta documentation/DATA.md.
Evaluación sobre OpenVerification1
Consulta documentation/EVAL.md.
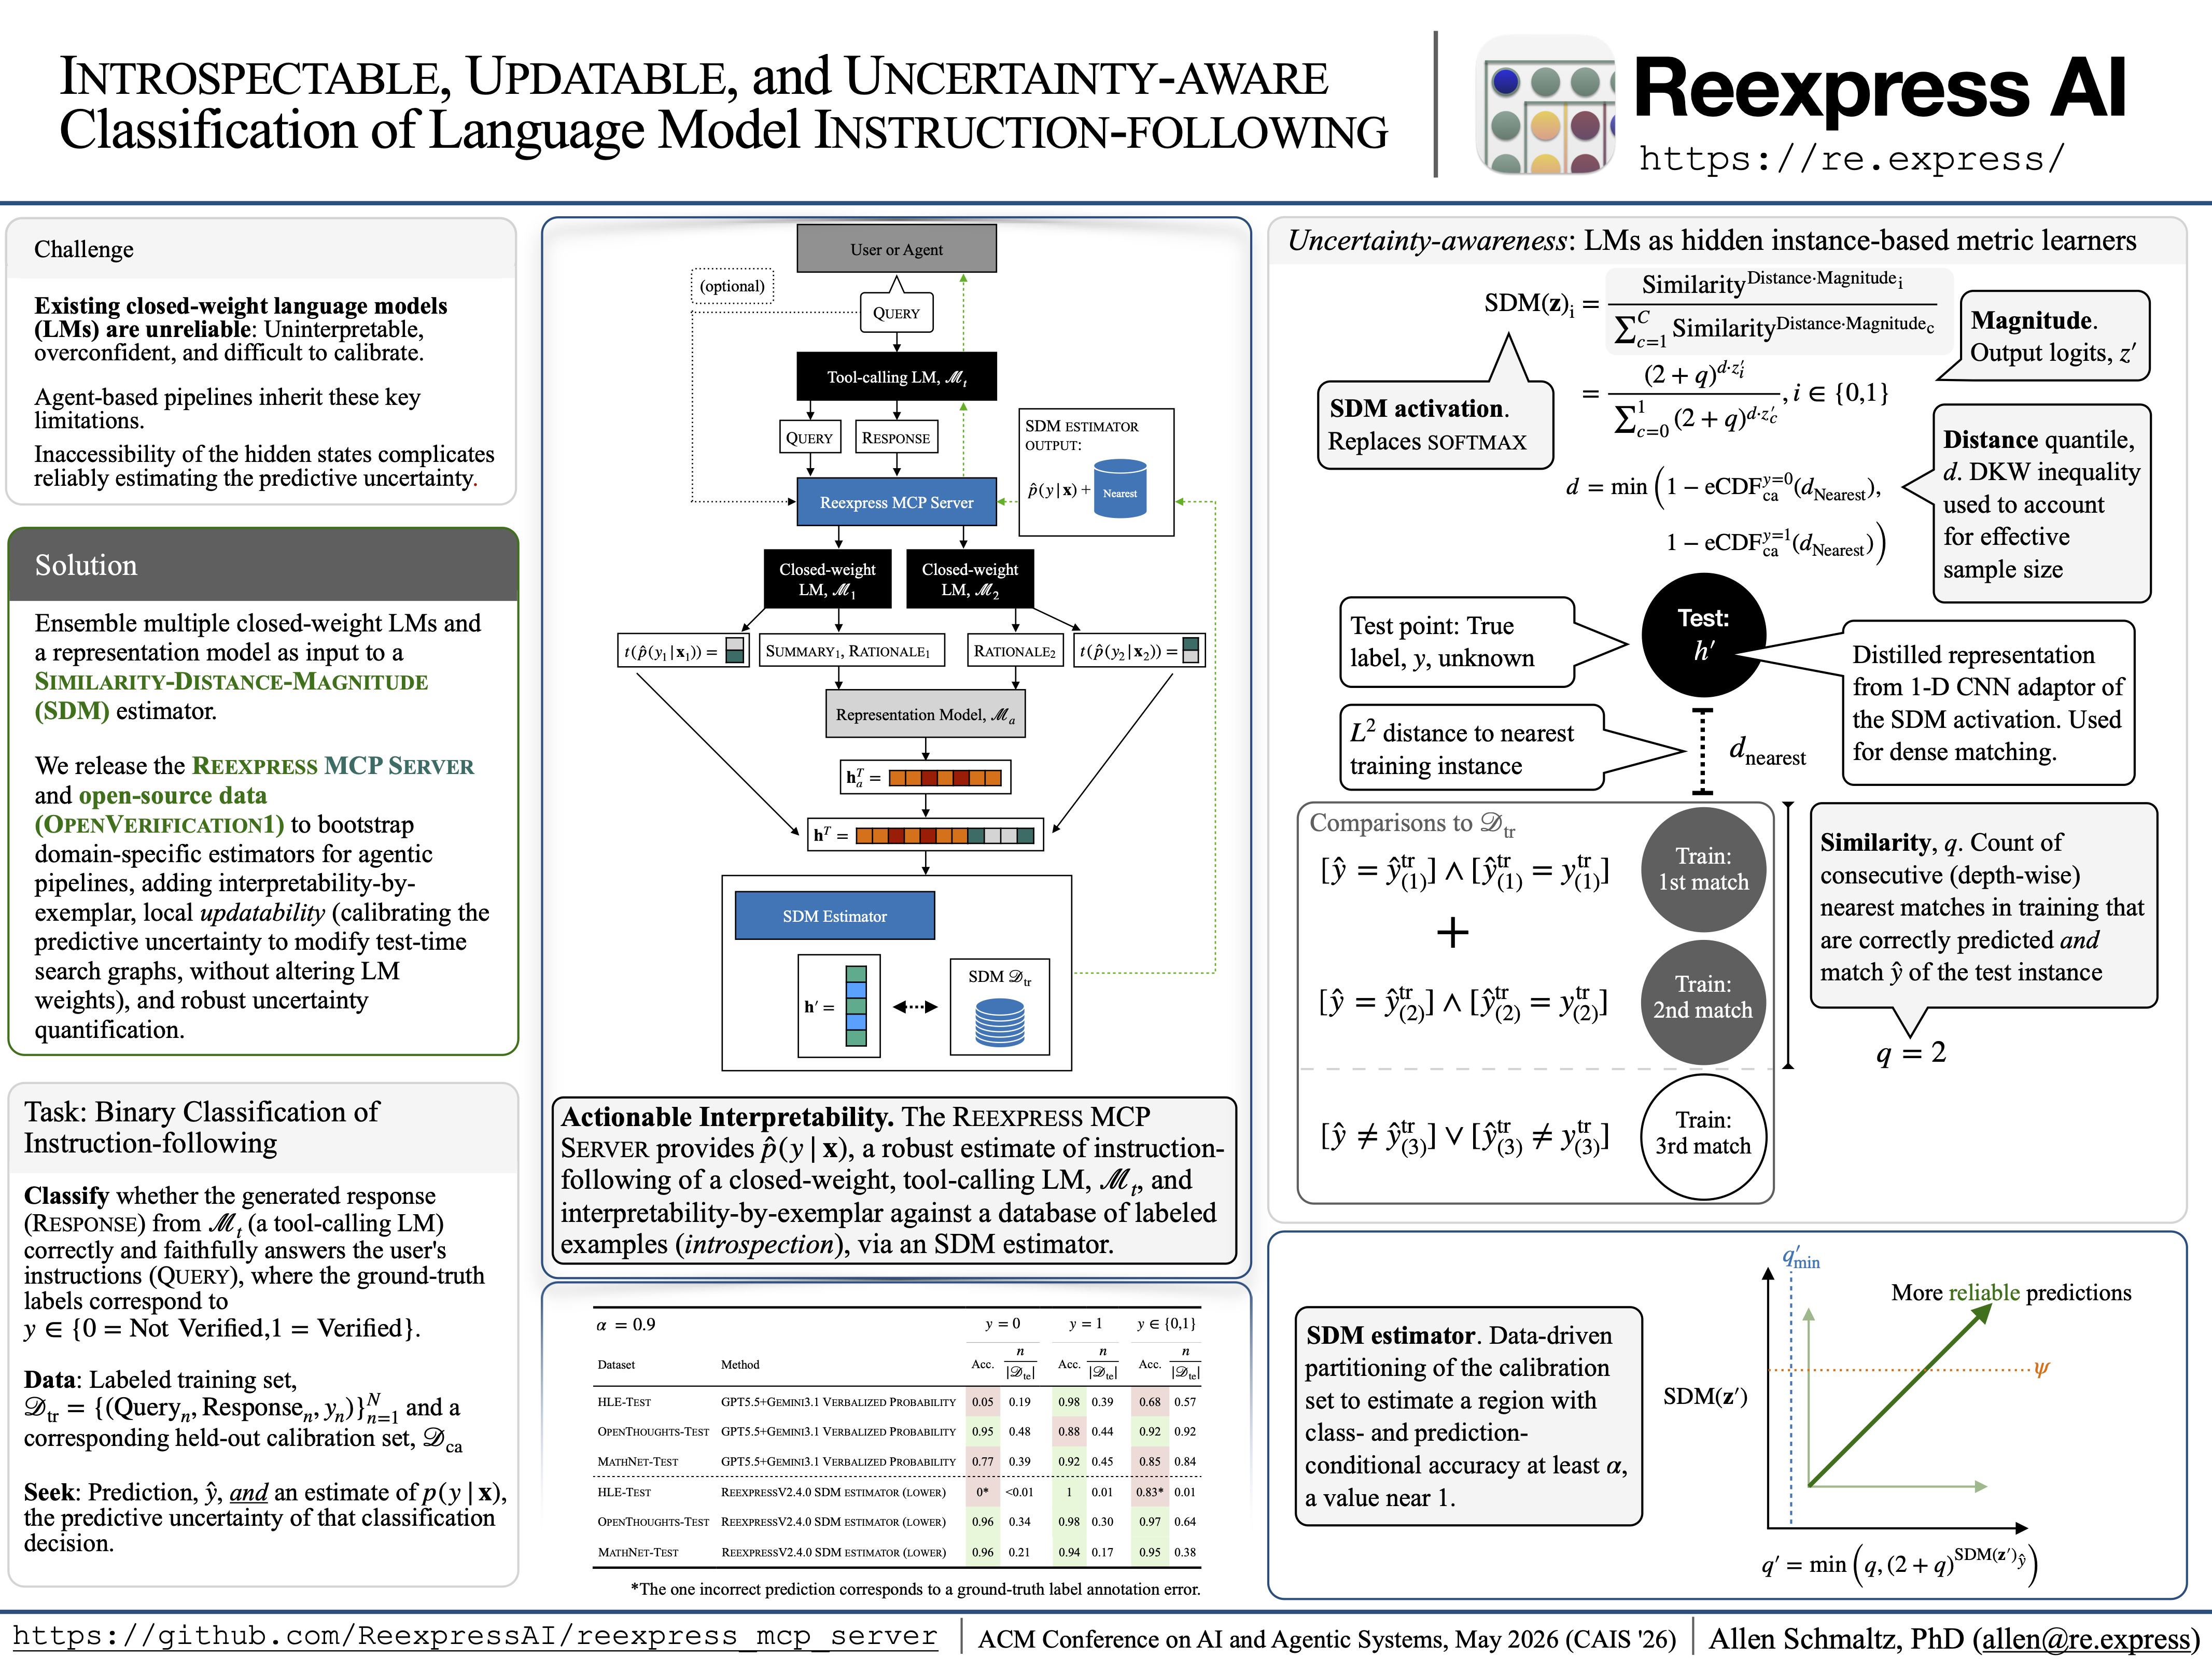
Artículo de demostración del sistema
Se incluye una copia de nuestro artículo de demostración del sistema "Introspectable, Updatable, and Uncertainty-aware Classification of Language Model Instruction-following", que se centra en particular en la versión 2.1.0 del Servidor MCP de Reexpress, aquí. Los scripts de soporte para replicar el análisis se incluyen aquí.
La tarjeta de modelo de la versión 2.4.0, que destaca los cambios desde el artículo de demostración del sistema, está disponible aquí.
Citación
Si encuentras útil este software, considera citar los siguientes artículos revisados por pares:
@inproceedings{Schmaltz-2026-SimilarityDistanceMagnitudeActivations,
    title = "Similarity-Distance-Magnitude Activations",
    author = "Schmaltz, Allen",
    editor = "Liakata, Maria  and
      Moreira, Viviane P.  and
      Zhang, Jiajun  and
      Jurgens, David",
    booktitle = "Findings of the {A}ssociation for {C}omputational {L}inguistics: {ACL} 2026",
    month = jul,
    year = "2026",
    address = "San Diego, California, United States",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2026.findings-acl.1109/",
    doi = "10.18653/v1/2026.findings-acl.1109",
    pages = "22037--22057",
    ISBN = "979-8-89176-395-1",
    abstract = "We introduce the Similarity-Distance-Magnitude (SDM) activation function, a more robust and interpretable formulation of the standard softmax activation function, adding Similarity (i.e., correctly predicted depth-matches into training) awareness and Distance-to-training-distribution awareness to the existing output Magnitude (i.e., decision-boundary) awareness, and enabling interpretability-by-exemplar via dense matching. We further introduce the SDM estimator, based on a data-driven partitioning of the class-wise empirical CDFs via the SDM activation, to control the class- and prediction-conditional accuracy among selective classifications. When used as the final-layer activation over pre-trained language models for selective classification, the SDM estimator is more robust to covariate shifts and out-of-distribution inputs than existing calibration methods using softmax activations, while remaining informative over in-distribution data."
}
@inproceedings{Schmaltz-2026-ReexpressMCPServer,
    author = {Schmaltz, Allen},
    title = {Introspectable, Updatable, and Uncertainty-aware Classification of Language Model Instruction-following},
    year = {2026},
    isbn = {9798400724152},
    publisher = {Association for Computing Machinery},
    address = {New York, NY, USA},
    url = {https://doi.org/10.1145/3786335.3813214},
    doi = {10.1145/3786335.3813214},
    abstract = {In this system demonstration paper, we introduce an open-source implementation for training and testing Similarity-Distance-Magnitude (SDM) estimators for the task of binary classification of instruction-following of closed-weight language models (LMs). This SDM estimator provides an approximately conditional estimate of the predictive uncertainty over instruction-following, conditional on multiple closed-weight LMs and the representation space of an open-weight model. While it would be more robust to use as input to the SDM estimator the hidden-states of the underlying models, this indirect, compositional proxy is more reliable than verbalized uncertainty and adds a means of auditing the predictions against data with known labels. We release the code as an MCP Server to simplify adding interpretability-by-exemplar and locally updatable, uncertainty-aware instruction-following to agent-based pipelines. We further release OpenVerification1, a balanced set of over two million examples of instruction-following and associated rationales from recent closed-weight LMs, for bootstrapping domain-specific estimators. Finally, we discuss limitations of estimating the predictive uncertainty without access to the hidden-states of the tool-calling LM and provide practical guidance for applications.},
    booktitle = {Proceedings of the ACM Conference on AI and Agentic Systems},
    pages = {1259–1269},
    numpages = {11},
    keywords = {Approximately conditional calibration, Interpretability-by-exemplar, Classification of instruction-following, Model ensembles},
    location = {
    },
    series = {CAIS '26}
}
Footnotes
-
The el formato de salida ha cambiado desde la v1.0.0 utilizada en el video. Consulta changelog.md. ↩