AiCore Project
Un marco unificado para integrar varios modelos de lenguaje y proveedores de embeddings para generar completaciones de texto y embeddings.
Documentación
Proyecto AiCore




✨ AiCore es un framework integral para integrar diversos proveedores de modelos de lenguaje y embeddings con una interfaz unificada. Soporta operaciones tanto síncronas como asíncronas para generar completaciones de texto y embeddings, con las siguientes características:
🔌 Soporte multi-proveedor: OpenAI, Mistral, Groq, Gemini, NVIDIA y más 🤖 Aumento de razonamiento: Mejora los LLMs tradicionales con capacidades de razonamiento 📊 Observabilidad: Monitoreo y analítica integrados 💰 Seguimiento de tokens: Métricas detalladas de uso y seguimiento de costos ⚡ Despliegue flexible: Soporte para Chainlit, FastAPI y scripts independientes 🛠️ Integración MCP: Conéctate a servidores del Protocolo de Control de Modelos mediante llamadas a herramientas 🖥️ Proveedor Claude Code: Usa tu suscripción de Claude local o remotamente mediante el SDK de Python de Claude Agents — no se requiere clave API
Inicio rápido
pip install git+https://github.com/BrunoV21/AiCore
o
pip install git+https://github.com/BrunoV21/AiCore.git#egg=core-for-ai[all]
o
pip install core-for-ai[all]
Realiza tu Primera Solicitud
Síncrono
from aicore.llm import Llm
from aicore.llm.config import LlmConfig
import os

llm_config = LlmConfig(
  provider="openai",
  model="gpt-4o",
  api_key="super_secret_openai_key"
)

llm = Llm.from_config(llm_config)

# Generate completion
response = llm.complete("Hello, how are you?")
print(response)
Asíncrono
from aicore.llm import Llm
from aicore.llm.config import LlmConfig
import os

async def main():
  llm_config = LlmConfig(
    provider="openai",
    model="gpt-4o",
    api_key="super_secret_openai_key"
  )

  llm = Llm.from_config(llm_config)

  # Generate completion
  response = await llm.acomplete("Hello, how are you?")
  print(response)

if __name__ == "__main__":
  asyncio.run(main())
hay más ejemplos disponibles en examples/ y docs/exampes/
Características Clave
Soporte Multi-proveedor
Proveedores de LLM:
- Anthropic
- OpenAI
- Mistral
- Groq
- Gemini
- NVIDIA
- OpenRouter
- DeepSeek
- Claude Code (local — mediante el SDK de Python de Claude Agents, no se requiere clave API)
- Claude Code Remoto (remoto — se conecta a un
aicore-proxy-servera través de HTTP)
Proveedores de Embeddings:
- OpenAI
- Mistral
- Groq
- Gemini
- NVIDIA
Herramientas de Observabilidad:
- Seguimiento de operaciones y recopilación de métricas
- Panel interactivo para visualización
- Monitoreo de uso de tokens y latencia
- Seguimiento de costos
Integración MCP:
- Conéctate a múltiples servidores MCP simultáneamente
- Descubrimiento y llamada automática de herramientas
- Soporte para transportes WebSocket, SSE y stdio
Para configurar la aplicación para pruebas, necesitas crear un archivo config.yml con las claves API y nombres de modelo necesarios para cada proveedor que planees usar. La variable de entorno CONFIG_PATH debe apuntar a la ubicación de este archivo. Aquí tienes un ejemplo de cómo configurar el archivo config.yml:
# config.yml
embeddings:
  provider: "openai" # or "mistral", "groq", "gemini", "nvidia"
  api_key: "your_openai_api_key"
  model: "text-embedding-3-small" # Optional

llm:
  provider: "openai" # or "mistral", "groq", "gemini", "nvidia"
  api_key: "your_openai_api_key"
  model: "gpt-o4" # Optional
  temperature: 0.1
  max_tokens: 1028
  reasonning_effort: "high"
  mcp_config: "./mcp_config.json" # Path to MCP configuration
  max_tool_calls_per_response: 3 # Optional limit on tool calls
los ejemplos de configuración para los múltiples proveedores están incluidos en el directorio de config
Ejemplo de Integración MCP
from aicore.llm import Llm
from aicore.config import Config
import asyncio

async def main():
    # Load configuration with MCP settings
    config = Config.from_yaml("./config/config_example_mcp.yml")

    # Initialize LLM with MCP capabilities
    llm = Llm.from_config(config.llm)

    # Make async request that can use MCP-connected tools
    response = await llm.acomplete(
        "Search for latest news about AI advancements",
        system_prompt="Use available tools to gather information"
    )
    print(response)

asyncio.run(main())
Ejemplo de configuración MCP (mcp_config.json):
{
  "mcpServers": {
    "search-server": {
      "transport_type": "ws",
      "url": "ws://localhost:8080",
      "description": "WebSocket server for search functionality"
    },
    "data-server": {
      "transport_type": "stdio",
      "command": "python",
      "args": ["data_server.py"],
      "description": "Local data processing server"
    },
    "brave-search": {
      "command": "npx",
      "args": [
        "-y",
        "@modelcontextprotocol/server-brave-search"
      ],
      "env": {
        "BRAVE_API_KEY": "SUPER-SECRET-BRAVE-SEARCH-API-KEY"
      }
    }
  }
}
Proveedor Claude Code
AiCore soporta el enrutamiento de completaciones a través de tu suscripción de Claude mediante el SDK de Python de Claude Agents. No se requiere clave API de Anthropic — la autenticación se maneja completamente mediante la CLI de Claude Code. Esto se expone a través de dos proveedores y un servidor proxy opcional:
| Componente | Descripción |
|---|---|
claude_code | Proveedor local — ejecuta la CLI de Claude Code en la misma máquina que AiCore |
remote_claude_code | Proveedor remoto — se conecta a través de HTTP a una instancia de aicore-proxy-server |
aicore-proxy-server | Servidor proxy — envuelve la CLI local como un servicio FastAPI SSE, compartible a través de una red |
Ambos proveedores comparten la misma interfaz acomplete() / complete() y emiten eventos idénticos de transmisión de llamadas a herramientas — puedes cambiar entre ellos con un solo cambio de configuración.
Proveedor Local (claude_code)
Ejecuta claude-agent-sdk directamente en la máquina donde se está ejecutando AiCore.
Requisitos previos
# 1. Install the Claude Code CLI (requires Node.js 18+)
npm install -g @anthropic-ai/claude-code

# 2. Authenticate once
claude login

# 3. Install AiCore (the Python SDK is included automatically)
pip install core-for-ai
Inicio rápido
from aicore.llm import Llm
from aicore.llm.config import LlmConfig

config = LlmConfig(
    provider="claude_code",
    model="claude-sonnet-4-5-20250929",
    # No api_key needed — auth is handled by the CLI
)

llm = Llm.from_config(config)
response = await llm.acomplete("List all Python files in this project")
print(response)
Archivo de Configuración
# config/config_example_claude_code.yml
llm:
  provider: "claude_code"
  model: "claude-sonnet-4-5-20250929"

  # Optional
  permission_mode: "bypassPermissions"   # default — all tools allowed
  cwd: "/path/to/your/project"           # working directory for the CLI
  max_turns: 10                           # limit agentic turns
  mcp_config: "./mcp_config.json"   # pass through an MCP config file
  cli_path: "/usr/local/bin/claude"      # override if CLI is not on PATH
  allowed_tools:
    - "Read"
    - "Write"
    - "Bash"
Servidor Proxy (aicore-proxy-server)
El servidor proxy envuelve claude-agent-sdk en un servicio FastAPI SSE para que Claude Code pueda accederse remotamente a través de HTTP. Útil cuando:
- La CLI de Claude Code está autenticada en una máquina diferente (por ejemplo, una máquina de desarrollo, un servidor o WSL)
- Quieres compartir una sola suscripción de Claude entre múltiples clientes de AiCore
- Tu carga de trabajo de AiCore se ejecuta en un entorno de contenedor o nube que no puede ejecutar la CLI directamente
Instalación (solo en el servidor)
# Install AiCore with the claude-server extras
pip install core-for-ai[claude-server]

# Also install the Claude Code CLI and authenticate
npm install -g @anthropic-ai/claude-code
claude login
El extra [claude-server] instala fastapi, uvicorn[standard] y python-dotenv. pyngrok es opcional y solo se necesita para el modo de túnel ngrok.
Iniciando el Servidor
# Minimal — binds to 127.0.0.1:8080, prompts for tunnel choice interactively
aicore-proxy-server

# Fully configured
aicore-proxy-server \
  --host 0.0.0.0 \
  --port 8080 \
  --token my-secret-token \
  --tunnel none \
  --cwd /path/to/project \
  --log-level INFO

# Or via Python module
python -m aicore.scripts.claude_code_proxy_server --port 8080 --tunnel none
En la primera ejecución, el token de portador se genera automáticamente y se imprime. Establece CLAUDE_PROXY_TOKEN en tu entorno o archivo .env para reutilizarlo entre reinicios, o pasa --token explícitamente.
Referencia de CLI
| Indicador | Predeterminado | Descripción |
|---|---|---|
--host | 127.0.0.1 | Dirección de enlace |
--port | 8080 | Puerto TCP |
--token | (generado automáticamente) | Token de portador; también lee la variable de entorno CLAUDE_PROXY_TOKEN |
--tunnel | (solicitado) | none / ngrok / cloudflare / ssh |
--tunnel-port | igual que --port | Puerto remoto para túneles SSH |
--cwd | (sin restricciones) | Forzar un directorio de trabajo para todas las sesiones de Claude |
--allowed-cwd-paths | (cualquiera) | Lista blanca de valores de cwd que los clientes pueden solicitar |
--log-level | INFO | DEBUG / INFO / WARNING / ERROR |
--cors-origins | * | Orígenes CORS permitidos |
Soporte de Túneles
Cuando se omite --tunnel, el servidor solicita interactivamente al inicio.
| Modo | Requisito | Notas |
|---|---|---|
none | — | Solo red local |
ngrok | pip install pyngrok | El token de autenticación se almacena en el almacén de credenciales del sistema operativo en la primera ejecución y se carga automáticamente en ejecuciones posteriores |
cloudflare | binario cloudflared en PATH | Túnel rápido, URL efímera |
ssh | Acceso SSH a un VPS | Imprime el comando ssh -R; no se necesita software adicional |
Puntos Finales de API
| Método | Ruta | Autenticación | Descripción |
|---|---|---|---|
GET | /health | Ninguna | Estado del servidor, tiempo de actividad, versión de la CLI de Claude, recuento de transmisiones activas |
GET | /capabilities | Portador | Opciones admitidas y valores predeterminados aplicados por el servidor |
POST | /query | Portador | Transmitir una consulta de claude-agent-sdk como SSE |
DELETE | /query/{session_id} | Portador | (stub 501 — reservado para futura cancelación basada en WebSocket) |
Proveedor Remoto (remote_claude_code)
Conecta AiCore a un aicore-proxy-server en ejecución a través de HTTP SSE. El proveedor remoto reconstruye el flujo de mensajes del SDK localmente, brindando la misma interfaz acomplete() / complete() que el proveedor local — no se necesita la CLI de Claude Code en el lado del cliente.
Requisitos previos (lado del cliente)
pip install core-for-ai # no CLI or claude-server extras required
El servidor proxy debe estar en ejecución y ser accesible antes de instanciar el proveedor (se realiza una verificación de GET /health automáticamente al inicio, controlable mediante skip_health_check).
Inicio rápido
from aicore.llm import Llm
from aicore.llm.config import LlmConfig

config = LlmConfig(
    provider="remote_claude_code",
    model="claude-sonnet-4-5-20250929",
    base_url="http://your-proxy-host:8080",   # or a tunnel URL
    api_key="your_proxy_token",               # CLAUDE_PROXY_TOKEN from server startup
)

llm = Llm.from_config(config)
response = await llm.acomplete("Summarise this codebase")
print(response)
Archivo de Configuración
# config/config_example_remote_claude_code.yml
llm:
  provider: "remote_claude_code"
  model: "claude-sonnet-4-5-20250929"
  base_url: "http://your-proxy-host:8080"   # or the ngrok / cloudflare tunnel URL
  api_key: "your_proxy_token"               # CLAUDE_PROXY_TOKEN printed at server startup

  # Optional — forwarded to the proxy server
  permission_mode: "bypassPermissions"
  cwd: "/path/to/project"                   # must be in server's --allowed-cwd-paths
  max_turns: 10
  allowed_tools:
    - "Bash"
    - "Read"
    - "Write"

  # Skip the GET /health connectivity check at startup
  skip_health_check: false
Transmisión de Llamadas a Herramientas y Callbacks
Tanto claude_code como remote_claude_code emiten eventos idénticos de llamadas a herramientas:
def on_tool_event(event: dict):
    if event["stage"] == "started":
        print(f"→ Calling tool: {event['tool_name']}")
    elif event["stage"] == "concluded":
        status = "✗" if event["is_error"] else "✓"
        print(f"{status} Tool finished: {event['tool_name']}")

llm.tool_callback = on_tool_event

response = await llm.acomplete("Find all TODO comments in the codebase")
TOOL_CALL_START_TOKEN / TOOL_CALL_END_TOKEN también se emiten mediante stream_handler, por lo que cualquier consumidor de transmisión existente funciona sin cambios.
Modelos Soportados
| Modelo | Tokens Máximos | Ventana de Contexto |
|---|---|---|
claude-sonnet-4-5-20250929 | 64 000 | 200 000 |
claude-opus-4-6 | 32 000 | 200 000 |
claude-haiku-4-5-20251001 | 64 000 | 200 000 |
claude-3-7-sonnet-latest | 64 000 | 200 000 |
claude-3-5-sonnet-latest | 8 192 | 200 000 |
Nota:
temperature,max_tokensyapi_keyson ignorados por ambos proveedores — la CLI de Claude Code controla los parámetros del modelo internamente. El costo se reporta desdeResultMessage.total_cost_usden lugar de calcularse a partir de una tabla de precios.
Uso
Modelos de Lenguaje
Puedes usar los modelos de lenguaje para generar completaciones de texto. A continuación se muestra un ejemplo de cómo usar el proveedor MistralLlm:
from aicore.llm.config import LlmConfig
from aicore.llm.providers import MistralLlm

config = LlmConfig(
    api_key="your_api_key",
    model="your_model_name",
    temperature=0.7,
    max_tokens=100
)

mistral_llm = MistralLlm.from_config(config)
response = mistral_llm.complete(prompt="Hello, how are you?")
print(response)
Carga desde un Archivo de Configuración
Para cargar configuraciones desde un archivo YAML, establece la variable de entorno CONFIG_PATH y usa la clase Config para cargar las configuraciones. Aquí tienes un ejemplo:
from aicore.config import Config
from aicore.llm import Llm
import os

if __name__ == "__main__":
    os.environ["CONFIG_PATH"] = "./config/config.yml"
    config = Config.from_yaml()
    llm = Llm.from_config(config.llm)
    llm.complete("Once upon a time, there was a")
Asegúrate de que tu archivo config.yml esté configurado correctamente con las configuraciones necesarias.
Observabilidad
AiCore incluye un módulo integral de observabilidad que rastrea:
- Metadatos de solicitud/respuesta
- Uso de tokens (prompt, completación, total)
- Métricas de latencia (tiempo de respuesta, tiempo hasta el primer token)
- Estimaciones de costos (basadas en los precios del proveedor)
- Estadísticas de llamadas a herramientas (para integraciones MCP)
Características del Panel
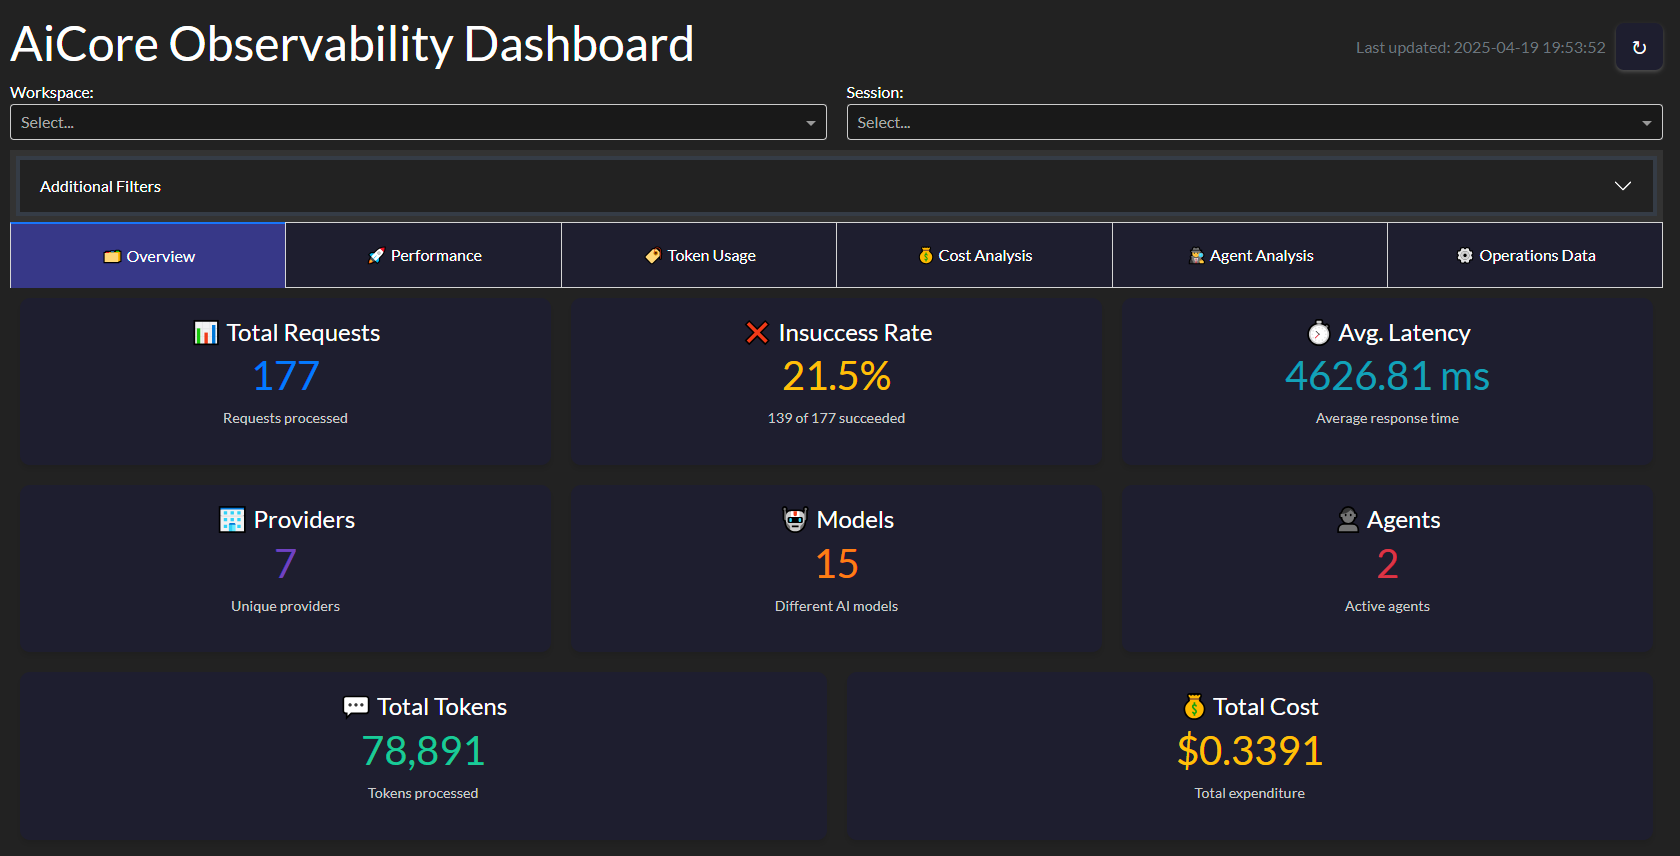
Métricas clave rastreadas:
- Solicitudes por minuto
- Tiempo promedio de respuesta
- Tendencias de uso de tokens
- Tasas de error
- Proyecciones de costos
from aicore.observability import ObservabilityDashboard

dashboard = ObservabilityDashboard(storage="observability_data.json")
dashboard.run_server(port=8050)
Uso Avanzado
Configuración Aumentada con Razonador
AiCore también contiene soporte nativo para aumentar los LLMs tradicionales con capacidades de razonamiento, proporcionándoles los pasos de pensamiento generados por un modelo de razonamiento de código abierto, lo que le permite generar sus respuestas de manera Aumentada con Razonamiento.
Esto puede ser útil en múltiples escenarios, como:
- asegurar que tus sistemas agénticos sigan funcionando con los prompts que has creado para tus LLMs favoritos mientras los aumentas con pasos de razonamiento
- control directo sobre cuánto tiempo quieres que tu razonador razone (mediante el parámetro max_tokens) y cuán creativo puede ser (temperatura de razonamiento desacoplada de la temperatura de generación) sin comprometer la configuración de generación
Para aprovechar el aumento de razonamiento, solo introduce una de las configuraciones de LLM compatibles en el campo del razonador y AiCore se encarga del resto
# config.yml
embeddings:
  provider: "openai" # or "mistral", "groq", "gemini", "nvidia"
  api_key: "your_openai_api_key"
  model: "your_openai_embedding_model" # Optional

llm:
  provider: "mistral" # or "openai", "groq", "gemini", "nvidia"
  api_key: "your_mistral_api_key"
  model: "mistral-small-latest" # Optional
  temperature: 0.6
  max_tokens: 2048
  reasoner:
    provider: "groq" # or openrouter or nvidia
    api_key: "your_groq_api_key"
    model: "deepseek-r1-distill-llama-70b" # or "deepseek/deepseek-r1:free" or "deepseek/deepseek-r1"
    temperature: 0.5
    max_tokens: 1024
Construido con AiCore
Reasoner4All
Un espacio de Hugging Face que muestra modelos aumentados con razonamiento

⏮ GitRecap
Resúmenes instantáneos de la actividad de Git
🌐 Aplicación en Vivo
📦 Repositorio de GitHub
🌀 Integración CodeTide y AgentTide
CodeTide es una herramienta completamente local y centrada en la privacidad para analizar y comprender bases de código Python mediante análisis simbólico y estructural — sin LLMs, sin embeddings, solo inteligencia de código rápida y determinista. Permite a desarrolladores y agentes de IA recuperar contexto de código preciso, visualizar la estructura del proyecto y generar cambios atómicos de código con confianza.
AgentTide es un agente de ingeniería de software de próxima generación, impulsado por precisión, construido sobre CodeTide. AgentTide aprovecha la comprensión simbólica de código de CodeTide para planificar, generar y aplicar parches de código de alta calidad — siempre con fidelidad total al contexto y los requisitos. Puedes interactuar con AgentTide mediante una CLI conversacional o una interfaz web hermosa.
Demostración en Vivo: Prueba AgentTide en Hugging Face Spaces: https://mclovinittt-agenttidedemo.hf.space/
AiCore se usó para realizar llamadas a LLMs dentro de AgentTide, permitiendo una integración perfecta entre el análisis de código local y los modelos de lenguaje avanzados. Esta combinación permite a AgentTide entregar cambios de código conscientes del contexto y listos para producción — siempre bajo tu control.
Planes Futuros
- Soporte Extendido de Proveedores: Proveedores adicionales de LLM y embeddings
- Agregar soporte para Voz: Integrar objetos de texto a voz y voz a texto con uso y observabilidad
Documentación
Para documentación completa, incluyendo referencias de API, ejemplos de uso avanzado y guías de configuración, visita:
📖 Sitio Oficial de Documentación
Licencia
Este proyecto está licenciado bajo la Licencia Apache 2.0.